Un serveur ou deux ? Où héberger une application d’IA et son service d’inférence
Comparez les déploiements colocalisés et séparés en cartographiant vos composants, vos flux de données et les responsabilités opérationnelles, puis évaluez chaque configuration au regard de vos propres exigences.
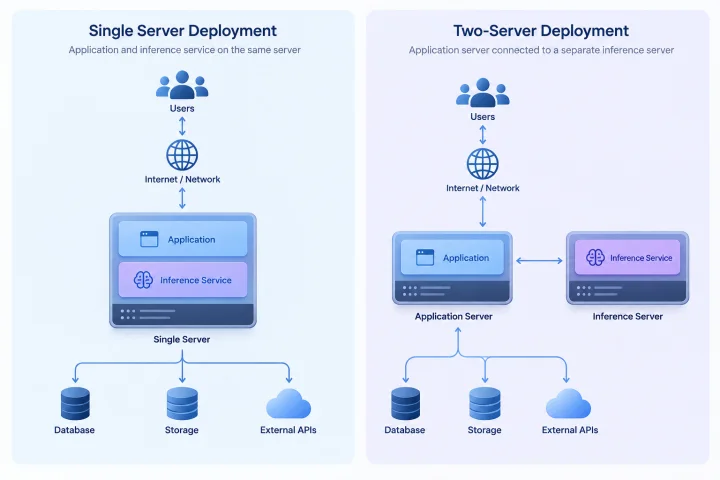
Commencez par distinguer les deux modes de déploiement
Dans une architecture colocalisée, l’application d’IA destinée aux utilisateurs et le service qui exécute l’inférence du modèle partagent un serveur. Il peut toutefois s’agir de processus logiciels ou de conteneurs distincts, exécutés sur le même hôte.
Dans une architecture séparée, l’application envoie les demandes d’inférence à un service hébergé sur un autre serveur ou sur un point de terminaison géré. Microsoft décrit une architecture où des clients distants partagent un point de terminaison de modèle exploité de manière centralisée (documentation Microsoft : https://learn.microsoft.com/en-us/windows-server/ai/local-ai-inference). Cela confirme l’existence de cette architecture précise ; cela ne compare pas les deux configurations et ne permet pas d’établir laquelle est préférable.
Les questions ci-dessous vous aideront à étudier vos propres exigences. Elles ne constituent pas des recommandations universelles sur la topologie la plus performante ou la plus facile à exploiter.
- Colocalisation : quelles conséquences le partage d’un hôte aurait-il pour vos ressources, votre maintenance et vos procédures de reprise ?
- Séparation : de quelles configurations réseau et de point de terminaison, et de quelles responsabilités, l’application dépendrait-elle ?

Cartographiez les composants et les questions à examiner
Représentez le système sous forme de composants et de connexions, et pas seulement comme une liste de serveurs. Incluez l’application destinée aux utilisateurs, l’environnement d’exécution de l’inférence, les fichiers de modèle, la base de données, le stockage de fichiers ou d’objets, les API externes, les systèmes d’identité et les tâches en arrière-plan. Indiquez les composants nécessaires à une requête et ceux qui sont facultatifs.
Pour chaque composant, notez où il s’exécute, qui en assure la maintenance, quelles ressources il utilise et ce que les utilisateurs constateraient s’il devenait indisponible. Ces éléments sont à vérifier en fonction de la configuration prise en charge par votre application et de vos propres exigences opérationnelles ; ce ne sont pas des conclusions découlant du choix d’une architecture.
Notez les tâches effectuées par les utilisateurs, le niveau de concurrence attendu et la possibilité que les requêtes arrivent par vagues. Si vous ne connaissez pas ces valeurs, considérez-les comme des questions à résoudre lors d’un projet pilote, plutôt que de combler les lacunes avec des estimations génériques de performance.
- Répertoriez l’application, le service d’inférence, la base de données, le stockage, les tâches planifiées et les API externes.
- Pour chaque connexion, indiquez son objectif, son sens, les identifiants utilisés et le comportement attendu lorsque la dépendance est indisponible.
- Repérez les éventuels conflits de ressources à étudier, par exemple lorsque l’activité de l’application et l’exécution du modèle utilisent la même capacité de processeur, de mémoire, d’accélération matérielle, de disque ou de réseau.
- Notez où sont stockés les fichiers de modèle, les invites, les documents téléversés, les réponses générées et les données de l’application.

Questions à examiner pour une architecture colocalisée
La colocalisation peut être une option à envisager si vous prévoyez d’héberger les deux services sur un même hôte. Avant de décider, vérifiez que votre application prend en charge la connexion prévue, que les fichiers de modèle sont compatibles avec votre plan de stockage et que votre équipe peut surveiller et rétablir les deux composants.
Demandez-vous ce qui se passerait si l’activité de l’application et l’inférence se disputaient les ressources, ou si une opération de maintenance ou un problème touchant l’hôte affectait les deux services. La réponse dépend de votre configuration et de l’expérience utilisateur acceptable ; la topologie, à elle seule, ne permet pas d’en établir les conséquences.
- Est-il acceptable que l’application et l’inférence partagent un hôte et ses modalités de maintenance ?
- Comment vérifierez-vous le comportement de l’application pendant l’exécution de tâches d’inférence représentatives ?
- Que devraient constater les utilisateurs si l’inférence est occupée ou indisponible, et pourront-ils toujours utiliser les fonctions non liées à l’IA de l’application ?
Questions à examiner pour une architecture séparée
Un service d’inférence distinct crée une frontière de service et de réseau supplémentaire. Vérifiez si cette séparation répond à un besoin précis, par exemple en matière de maintenance, de gestion des ressources ou d’administration. La séparation, à elle seule, ne garantit ni l’isolation, ni la sécurité, ni de meilleures performances.
Microsoft documente un point de terminaison d’inférence exploité de manière centralisée et partagé par des clients distants. Si vous envisagez cette architecture, vérifiez qui peut appeler le point de terminaison, comment les accès sont accordés et révoqués, et si les applications sont susceptibles de transmettre les mêmes catégories de données.
Réfléchissez au comportement attendu de l’application si elle ne peut pas joindre le point de terminaison, si les identifiants ne sont pas valides ou si le point de terminaison renvoie une erreur. Dans le cadre de l’évaluation de l’architecture, attribuez les responsabilités de surveillance, de maintenance et de reprise du point de terminaison.
- À quelle exigence répondrait la séparation du service ?
- Qui est responsable du point de terminaison, du contrôle d’accès, de la maintenance et de la réponse aux incidents ?
- Comment les erreurs réseau et celles du point de terminaison seront-elles gérées et signalées aux utilisateurs ?
Suivez les données et attribuez les responsabilités
Tracez le parcours des données pour une tâche réelle. Il peut inclure la saisie de l’utilisateur, les instructions de l’application, les documents récupérés ou d’autres éléments de contexte, une requête adressée au service d’inférence et une réponse. Le parcours réel dépend de l’application et de sa configuration : vérifiez donc ce qui est envoyé au lieu de le supposer.
Pour chaque élément de données, demandez-vous s’il franchit une frontière de service, où il est traité et s’il est conservé dans les données de l’application, les journaux du service, les sauvegardes ou un autre système. Ne déduisez pas les pratiques de journalisation ou de conservation de l’emplacement des services.
Notez qui peut accéder aux données et aux identifiants, quels paramètres de conservation s’appliquent et comment les sauvegardes sont gérées. Examinez séparément les appels aux API externes : une architecture à deux serveurs ne signifie pas que tous les traitements restent sur ces serveurs.
- Suivez séparément les entrées, le contexte récupéré, les pièces jointes, les sorties, les identifiants et les informations d’authentification.
- Pour chaque composant, vérifiez ce qui peut être consigné, ce qui est conservé, qui peut y accéder et pendant combien de temps.
- Confirmez quelles données et quels paramètres de l’application sont inclus dans les sauvegardes ; documentez séparément la gestion des fichiers de modèle et des autres ressources volumineuses.
- Désignez les responsables des décisions relatives aux données, aux accès et à la conservation.
Répondez à vos questions en suspens à l’aide d’un projet pilote
Un projet pilote peut vous aider à évaluer votre application, la configuration du modèle, les données et les conditions d’exploitation. Des affirmations génériques sur les résultats de tests de performance ne permettent pas de déterminer si vos tâches, votre profil de concurrence ou vos attentes en cas de panne seront acceptables.
Exécutez des tâches représentatives avec la ou les architectures envisagées. Incluez les usages habituels et la période la plus chargée que vous pouvez reproduire de manière réaliste. Décidez à l’avance de ce que vous allez observer — par exemple le comportement de l’application, l’achèvement des tâches d’inférence, l’utilisation des ressources et la pertinence des résultats — et définissez des critères d’acceptation adaptés à votre cas d’usage.
Si votre environnement s’y prête, testez les pannes pertinentes dans un cadre contrôlé : par exemple, l’indisponibilité d’un point de terminaison, une interruption du réseau ou des identifiants invalides. Consignez le comportement observé et les étapes de reprise, au lieu de présumer la réponse du système.
- Choisissez des tâches et des entrées représentatives, y compris les étapes pertinentes de recherche de documents ou d’appel d’API externes.
- Testez le profil d’utilisation attendu et toute activité simultanée réaliste que vous pouvez reproduire.
- Observez le comportement de l’application et de l’inférence pendant le traitement des requêtes.
- Définissez à l’avance vos critères d’acceptation, notamment pour l’achèvement des tâches, l’expérience utilisateur, le traitement des données et la capacité de reprise.
- Consignez la configuration, les hypothèses et les résultats afin de pouvoir les comparer après chaque modification.
Consignez votre décision et réexaminez-la si vos exigences évoluent
Consignez la topologie choisie, les exigences auxquelles elle doit répondre et les hypothèses qui sous-tendent la décision. Indiquez les responsables des composants, les flux de données, les comportements pertinents en cas de panne et les résultats du projet pilote. Réexaminez la décision si la charge de travail, les modalités de maintenance, les exigences d’accès ou les attentes en matière de reprise changent ; évaluez la nouvelle exigence au lieu de supposer qu’une architecture plus grande est automatiquement préférable.
Airbip propose le déploiement géré d’applications de catalogue sous forme de charges de travail Docker sur des serveurs cloud Airbip, avec le routage automatisé et les certificats TLS via Traefik et Let’s Encrypt, des vérifications DNS, la gestion du cycle de vie des services et des sauvegardes quotidiennes, hebdomadaires et mensuelles configurables. Ces capacités d’infrastructure ne déterminent pas où un service d’inférence particulier doit s’exécuter et ne déchargent pas le client de ses responsabilités concernant les choix en matière de données, d’accès et de gouvernance. Avant de choisir un modèle de déploiement, vérifiez que la configuration d’application et l’architecture d’inférence souhaitées correspondent à vos exigences.
- La topologie retenue et l’exigence à laquelle elle est censée répondre.
- Les hypothèses concernant la charge de travail, la concurrence, l’emplacement des données et les dépendances externes.
- Les données qui franchissent les frontières de service, les choix de conservation et les responsables des accès.
- Les responsabilités, les comportements pertinents en cas de panne, la procédure de reprise et les résultats du projet pilote.
- Les conditions qui vous amèneraient à réexaminer la décision.
Questions fréquentes
Un serveur d’inférence distinct améliore-t-il toujours les performances ?
Aucun avantage général en matière de performances n’est établi par les éléments disponibles. La séparation modifie l’organisation des services et introduit une dépendance réseau. Évaluez les options avec votre application, votre configuration et des tâches représentatives.
La colocalisation est-elle automatiquement plus sûre ?
Non. L’emplacement des services ne suffit pas à déterminer le contrôle d’accès, la conservation des données ou la gouvernance. Vérifiez quelles données circulent entre les composants, qui peut y accéder et comment les identifiants et les journaux sont gérés.
Que faut-il tester avant de choisir une architecture ?
Utilisez des tâches représentatives et un profil d’utilisation attendu. Décidez à l’avance de ce que vous allez observer et de ce que vous considérerez comme acceptable. Le cas échéant, testez le comportement en cas de panne et les procédures de reprise dans un environnement contrôlé.
Un même point de terminaison d’inférence peut-il servir plusieurs applications ?
Microsoft décrit un point de terminaison de modèle exploité de manière centralisée, que des clients distants peuvent partager (documentation : https://learn.microsoft.com/en-us/windows-server/ai/local-ai-inference). La pertinence de cette architecture pour votre configuration dépend de la compatibilité des applications, des contrôles d’accès, des politiques relatives aux données et de la répartition des responsabilités opérationnelles.
L’hébergement géré de l’application détermine-t-il où l’inférence s’exécute ?
Pas à lui seul. Airbip gère le déploiement des applications de catalogue et fournit des capacités d’infrastructure telles que le routage, l’automatisation TLS, les vérifications DNS, la gestion du cycle de vie des services et des sauvegardes configurables. Vérifiez séparément que l’architecture d’inférence et la configuration de l’application souhaitées répondent à vos exigences.