Inférence IA locale ou API hébergée : les questions à se poser pour faire un choix éclairé
Il n’existe pas de choix universel entre l’inférence locale et une API hébergée. Ces questions et cette courte fiche de travail vous aideront à clarifier vos limites en matière de données, votre charge de travail, vos responsabilités opérationnelles et les points qui restent à éclaircir.
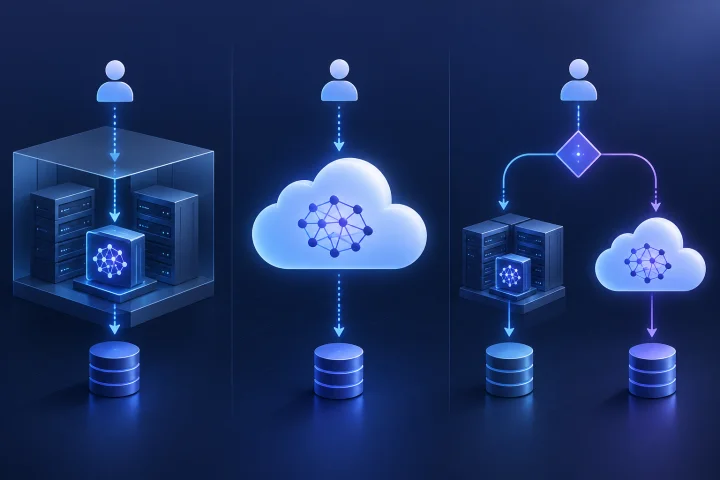
Un ensemble de questions, pas un classement universel
L’article [« A Cost-Benefit Analysis of On-Premise Large Language Models »](https://arxiv.org/html/2509.18101v1) décrit un cadre destiné à aider les organisations à évaluer dans quelles circonstances un déploiement sur site peut être économiquement viable. Cet article ne reprend pas ce cadre et ne compare pas les options à partir de résultats mesurés. Il propose des questions générales pour aider une équipe à déterminer ce qu’elle doit examiner.
L’hébergement de l’application et l’inférence du modèle sont deux choix distincts. Une application auto-hébergée peut être configurée pour utiliser un modèle dans le même environnement, une API hébergée ou plusieurs destinations. La configuration dépend de l’application et de ses paramètres.
Évitez de considérer que l’inférence locale est automatiquement plus confidentielle, moins coûteuse ou plus rapide, ou qu’une API hébergée est automatiquement plus simple ou mieux adaptée. Évaluez la configuration envisagée au regard de vos besoins.
- Quel composant reçoit en premier une requête utilisateur ?
- Où l’inférence du modèle est-elle configurée pour avoir lieu ?
- Quelles exigences excluraient une destination donnée ?

Définir les données et la charge de travail
Suivez une requête représentative dans la configuration envisagée. Notez quels composants la traitent et quelles informations sont en jeu, par exemple les données saisies par l’utilisateur, les éléments joints ou récupérés, la sortie du modèle ou les journaux opérationnels. Confirmez les détails pertinents en consultant la documentation de l’application et du fournisseur concernés.
Décrivez le travail que le système doit effectuer avant de comparer les options. Dressez la liste des tâches représentatives, des formats d’entrée et de sortie, des habitudes d’utilisation prévues et des critères qui définiraient un résultat acceptable pour votre équipe. Ces suggestions servent à définir un test ; elles ne constituent pas des critères d’évaluation universels.
- Quelles informations chaque composant traiterait-il ?
- Quels détails sur le traitement des données, les accès ou la conservation doivent être confirmés ?
- Quelles tâches et habitudes d’utilisation représentent la charge de travail prévue ?
- Quelles limites de sortie ou exigences de vérification sont importantes ?

Déterminer les responsabilités et les dépendances
Pour l’inférence locale, identifiez le modèle, l’environnement d’exécution et la configuration de calcul envisagés, puis consultez leur documentation officielle pour connaître les exigences et les responsabilités. Pour une API hébergée, consultez la documentation et les conditions actuelles du fournisseur concerné pour vérifier les détails pertinents à votre usage, comme le traitement des données, les contrôles d’accès, les quotas, les limites et le comportement en cas de défaillance.
Quelle que soit l’approche, examinez les composants dont dépend l’application, les personnes chargées de configurer et de maintenir la solution et les capacités de prise en charge de votre équipe. Estimez les coûts à partir de votre propre charge de travail et de vos hypothèses opérationnelles, plutôt que de vous fier à une affirmation générale selon laquelle une approche serait moins coûteuse.
- Quelle documentation décrit le modèle, l’environnement d’exécution ou le fournisseur ?
- Qui configurerait et maintiendrait la solution ?
- Quelles dépendances ou situations de défaillance faut-il prendre en compte ?
- Quelles hypothèses de charge de travail et d’exploitation doivent figurer dans une estimation des coûts ?
Une courte fiche de décision
Utilisez cette fiche pour transformer les questions ouvertes en une comparaison ciblée. Remplissez-la pour les configurations précises que vous envisagez ; laissez un point marqué comme non résolu si vous n’avez pas encore de réponse.
bullets
- Tâches requises et matériel de test représentatif : __________
- Limites relatives aux données et détails à vérifier : __________
- Destinations d’inférence envisagées et documentation correspondante : __________
- Responsabilités, dépendances et hypothèses opérationnelles : __________
- Questions auxquelles la comparaison doit répondre : __________
- Personne chargée de la vérification, responsable de la décision et points non résolus : __________
Considérer l’inférence hybride comme un choix de conception
Une configuration hybride peut être envisagée lorsqu’une équipe souhaite utiliser différentes destinations d’inférence pour différentes requêtes. Sa faisabilité et son fonctionnement dépendent de l’application et de sa configuration.
Avant de vous appuyer sur une telle configuration, précisez les règles de routage prévues, les destinations autorisées et le comportement de repli. Consultez la documentation et la configuration correspondantes pour déterminer si ces règles sont prises en charge comme prévu ; ne supposez pas qu’un mécanisme de repli est disponible ou qu’il respecte la limite souhaitée pour les données.
- Quelles requêtes, le cas échéant, sont destinées à chaque destination ?
- Que doit-il se passer si une destination ne peut pas traiter une requête ?
- La configuration documentée prend-elle en charge le routage prévu ?
Distinguer l’hébergement de l’application de celui de l’inférence
L’hébergement géré d’une application d’IA ne permet pas, à lui seul, de déterminer où s’effectue l’inférence du modèle de cette application. Airbip propose le déploiement géré d’un catalogue public d’applications professionnelles, de publication, d’analyse, de collaboration et d’IA. Les instances applicatives s’exécutent sous forme de charges de travail Docker sur les serveurs cloud d’Airbip. Airbip automatise le routage et les certificats TLS par l’intermédiaire de Traefik et Let’s Encrypt, inclut des vérifications DNS et la gestion du cycle de vie des services, et propose des sauvegardes quotidiennes, hebdomadaires et mensuelles configurables. Les clients peuvent utiliser un sous-domaine Airbip ou un nom de domaine personnalisé compatible.
Ces capacités d’hébergement ne déterminent pas la configuration d’inférence d’une application et ne déchargent pas le client de ses responsabilités en matière de données, d’accès et de gouvernance. Consultez la configuration et la documentation de l’application concernée pour connaître son point de terminaison de modèle et ses exigences. Consultez le site web Airbip en direct pour connaître les offres et conditions commerciales en vigueur.
Airbip peut être pertinent si votre besoin porte sur l’hébergement géré d’une application figurant dans son catalogue. Évaluez séparément tout besoin relatif à un environnement d’inférence ou à une configuration de fournisseur en particulier.
- Vérifiez séparément les détails de l’hébergement de l’application et de l’emplacement de l’inférence.
- Déterminez qui est responsable de l’accès aux données, de la configuration du modèle et de la gouvernance.
- Consultez les informations à jour sur le service pour le déploiement et les conditions que vous envisagez.
Questions fréquentes
Auto-héberger une application d’IA signifie-t-il que son inférence est locale ?
Non. L’hébergement de l’application et l’emplacement de l’inférence sont deux éléments distincts. La configuration de l’application détermine le point de terminaison du modèle qu’elle utilise.
L’inférence locale est-elle automatiquement plus confidentielle, moins coûteuse ou plus rapide ?
L’emplacement, à lui seul, ne permet pas de tirer une conclusion universelle. Évaluez la configuration, la charge de travail et les exigences spécifiques.
Que faut-il vérifier avant d’utiliser une API de modèle hébergée ?
Consultez la documentation et les conditions actuelles du fournisseur concerné pour vérifier les détails pertinents à votre usage, notamment le traitement des données, les contrôles d’accès, les quotas et le comportement en cas de défaillance.
Comment comparer les options locales et hébergées ?
Définissez les questions auxquelles vous devez répondre, utilisez des tâches représentatives et du matériel de test approuvé, consignez les configurations et les observations, puis notez les points non résolus. Une comparaison limitée ne vaut que pour les configurations testées, et pas nécessairement pour d’autres charges de travail.
Que faut-il prendre en compte pour l’inférence hybride ?
Vérifiez si l’application prend en charge le routage prévu, identifiez les destinations des requêtes concernées et précisez ce qui doit se passer si une destination ne peut pas traiter une requête.
Sources et lectures complémentaires
- A Cost-Benefit Analysis of On-Premise Large Language Models — arXiv
- Docker documentation — Docker
- Traefik documentation — Traefik Labs
- Let’s Encrypt documentation — Internet Security Research Group
- OWASP Top 10 for LLM Applications — OWASP