Que se passe-t-il lorsqu’une dépendance tombe en panne ? Un test de résilience pour les applications auto-hébergées
Une méthode pratique pour cartographier les services dont dépend votre application auto-hébergée, tester en toute sécurité des pannes réalistes et définir des solutions de repli sécurisées avant un lancement ou une migration.
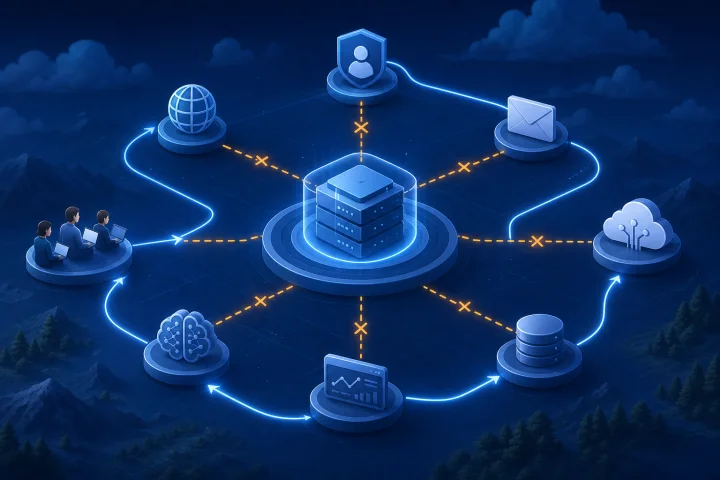
Une application peut être saine alors que le travail est impossible
Un conteneur en cours d’exécution, une requête réussie vers la page de connexion ou un contrôle vert du proxy inverse ne répondent qu’à une question limitée : ce composant répond-il dans la condition vérifiée ? Cela ne prouve pas que les utilisateurs peuvent se connecter via le fournisseur d’identité de l’organisation, envoyer une notification, récupérer un fichier, finaliser un paiement, appeler une API connectée ou obtenir une réponse d’un service de modèles.
Docker Compose peut démarrer les services dans l’ordre de leurs dépendances, mais cet ordre de démarrage ne signifie pas à lui seul qu’une dépendance est prête pour le travail de l’application. Docker documente l’utilisation d’un contrôle de santé configuré et de la condition `service_healthy` lorsqu’un service dépendant doit attendre que le service soit prêt ([documentation Docker](https://docs.docker.com/compose/how-tos/startup-order/)). Malgré cela, les contrôles de santé doivent être interprétés avec précision : le point de terminaison `/ping` documenté par Traefik prouve que le processus Traefik est actif, et non que chaque chemin d’application en amont est utilisable ([documentation Traefik](https://doc.traefik.io/traefik/reference/install-configuration/observability/healthcheck/)).
Considérez la résilience comme une question axée sur les résultats : quelles tâches utilisateur doivent continuer à réussir, lesquelles peuvent être différées et lesquelles doivent être bloquées en toute sécurité lorsqu’une dépendance est dégradée ? Cette approche produit un plan bien plus utile qu’une liste d’intégrations.
- Disponibilité du processus : un processus répond à une requête simple.
- Disponibilité opérationnelle : un service peut accepter le type précis de travail qu’il est sur le point de recevoir.
- Résultat métier confirmé : le résultat prévu s’est produit une seule fois, avec les bonnes données et toute piste d’audit requise.
- Rétablissement : l’équipe peut restaurer le fonctionnement normal, rapprocher les travaux dont l’issue est incertaine et expliquer l’impact.

Cartographier les dépendances selon la fonction qu’elles remplissent
Commencez par les parcours utilisateur, et non par le fichier de configuration. Pour chaque parcours important — par exemple se connecter, créer une fiche client, publier du contenu, envoyer une facture, accepter l’envoi d’un formulaire ou répondre à une requête d’IA — retracez chaque service requis entre l’action de l’utilisateur et le résultat confirmé.
Incluez les dépendances gérées, externes et opérées par des personnes. Un diagramme de déploiement Docker est utile, mais incomplet : le DNS, un registraire ou fournisseur de domaine personnalisé, l’identité, le SMTP ou les API d’e-mail, les API SaaS, les expéditeurs de webhooks, les points de terminaison de modèles et la supervision peuvent tous se trouver hors de la pile applicative. Docker Compose prend également en charge les services fournis par des fournisseurs externes, ce qui confirme qu’une charge de travail peut dépendre de ressources dont le cycle de vie est géré ailleurs ([référence Docker Compose](https://docs.docker.com/reference/compose-file/services/)).
Utilisez les groupes fonctionnels suivants afin que les lacunes soient visibles dès le départ.
- Identité et accès : fournisseur d’identité, fédération, authentification multifacteur, annuaire des rôles, chemin d’accès administrateur.
- Réseau et domaine : DNS, configuration de domaine personnalisé, proxy inverse, validation des certificats TLS et chemin de renouvellement.
- Communication : relais SMTP, API d’e-mail transactionnel, traitement des e-mails entrants, services de messagerie ou de notification.
- Données et fichiers : base de données principale, stockage d’objets ou de fichiers, destination des sauvegardes, emplacements d’importation ou d’exportation.
- Services commerciaux et connectés : prestataire de paiement, CRM, comptabilité, analytique, cartes, recherche, API partenaires et identifiants d’API.
- Traitement asynchrone : files d’attente, planificateurs, workers, webhooks et points de terminaison de rappel.
- Services d’IA : point de terminaison de modèle, service d’embeddings, magasin vectoriel, pipeline de récupération documentaire et identifiants de modèle.
- Exploitation : journaux, supervision, diffusion des alertes, contacts d’incident, gestion des secrets et documentation administrative.

Classer les dépendances selon les conséquences de leur perte
N’attribuez pas le même objectif de résilience à chaque dépendance. Les recommandations de NIST sur la chaîne d’approvisionnement appuient l’adaptation des exigences selon la criticité, en tenant compte de l’impact sur la mission ou l’activité, des données traitées et du produit ou service fourni ([NIST SP 1305](https://nvlpubs.nist.gov/nistpubs/SpecialPublications/NIST.SP.1305.pdf)). Appliquez le même raisonnement à chaque dépendance de l’architecture de votre application.
Une classification simple en quatre parties oblige à décider quel mode dégradé est acceptable. Un service peut relever de plusieurs catégories selon les workflows ; par exemple, l’e-mail peut être facultatif pour consulter des enregistrements, mais requis pour la récupération de mot de passe ou un envoi ayant une importance légale.
- Requis pour se connecter : sans lui, les utilisateurs ordinaires ne peuvent pas établir de session. Définissez séparément un chemin d’accès d’urgence sécurisé pour les administrateurs.
- Requis pour travailler : sans lui, une transaction centrale ne peut pas être réalisée correctement. Il peut s’agir, par exemple, du magasin de données principal ou d’une API externe obligatoire.
- Requis pour les fonctionnalités facultatives : les utilisateurs peuvent poursuivre leur travail principal, mais une action non essentielle est indisponible ou différée.
- Requis pour le rétablissement : l’exploitation quotidienne peut se poursuivre temporairement, mais la restauration, le renouvellement de certificats, la notification d’incident ou la récupération de données en dépendent.
- Pour chaque classification, définissez une durée d’interruption acceptable, un volume maximal de travaux en attente tolérable, la solution de repli autorisée et la personne habilitée à l’activer.
Demander des preuves, pas des descriptions rassurantes
La documentation des fournisseurs et un environnement de test doivent répondre à des questions opérationnelles auxquelles les pages marketing ne répondent souvent pas. Consignez un lien, un résultat de test, une référence de configuration ou un contact de support pour chaque réponse. Lorsque la documentation est silencieuse, indiquez que le comportement est inconnu plutôt que de supposer l’existence d’une relance, d’une file d’attente ou d’une sauvegarde.
Vérifiez la limite précise qui est testée. Traefik indique que, lorsque les contrôles de santé sont activés et que tous les serveurs d’un service sont indisponibles, il peut renvoyer HTTP 503. C’est une preuve utile concernant la disponibilité en amont à la limite du proxy inverse, mais pas une preuve qu’une transaction utilisateur a abouti ([FAQ Traefik](https://doc.traefik.io/traefik/getting-started/faq/)).
L’automatisation des certificats mérite sa propre entrée de dépendance. La validation HTTP-01 de Let’s Encrypt exige que l’autorité de certification récupère un fichier de défi depuis le serveur web, tandis que DNS-01 exige qu’elle interroge un enregistrement TXT dans le DNS. L’itinéraire pertinent, le contrôle DNS, la portée des identifiants et le comportement de propagation doivent donc être documentés avant que le renouvellement ne devienne urgent ([documentation Let’s Encrypt sur les défis](https://letsencrypt.org/docs/challenge-types/)).
- Quelle opération exacte prouve que la dépendance est utilisable, plutôt que simplement accessible ?
- Quels délais d’expiration, codes d’erreur, politiques de relance, limites de relance et comportements de temporisation progressive s’appliquent ?
- Une requête peut-elle être acceptée puis finalisée plus tard, et où son statut final peut-il être vérifié ?
- Les événements peuvent-ils arriver en retard, plusieurs fois ou dans le désordre ?
- L’application met-elle le travail en file d’attente pendant une panne ? Quelle est la limite de la file, sa visibilité et la méthode de rapprochement ?
- Quels identifiants sont nécessaires au rétablissement, où sont-ils stockés et qui peut les utiliser ?
- Quels changements DNS ou réseau peuvent empêcher le renouvellement de certificats ou l’accès à un domaine personnalisé ?
- Existe-t-il un environnement hors production ou un environnement de test (staging) du fournisseur pour une validation sûre ?
Exécuter des tests de panne contrôlés qui ressemblent à des incidents de production
Un test de résilience doit avoir un périmètre défini, une condition de sécurité, une action de retour arrière et un observateur. Commencez dans un environnement hors production représentatif. Ne passez à des exercices de production limités que lorsque l’impact, l’autorisation, la supervision et le retour à la normale sont compris. Ne réalisez pas d’expérience susceptible de provoquer une défaillance incontrôlée de la charge de travail.
Testez un workflow métier réel, et pas seulement un contrôle de connexion. Par exemple, si la distribution d’e-mails est indisponible, testez l’invitation de compte, la réinitialisation de mot de passe et l’action qui dépend de la réception du message par le destinataire. Consignez séparément si l’application a accepté la requête, si le fournisseur d’e-mail l’a acceptée et si le destinataire prévu peut accomplir l’action requise. Si un point de terminaison de modèle est indisponible, testez ce que voit l’utilisateur, si les documents sources restent protégés et si une interaction incomplète est enregistrée avec exactitude.
Pour le dépannage des certificats ou le développement de clients, utilisez l’environnement de test (staging) de Let’s Encrypt plutôt que de provoquer à répétition des autorisations de production échouées. Let’s Encrypt recommande cet environnement pour diagnostiquer les conditions d’autorisation sans consommer les limites de production ([documentation Let’s Encrypt sur les limites de débit](https://letsencrypt.org/docs/rate-limits/)).
- Fournisseur d’identité indisponible : essayez la connexion d’un utilisateur ordinaire, le renouvellement de session, l’accès administrateur et la déconnexion ; vérifiez l’accès d’urgence uniquement selon les contrôles documentés.
- Échec de distribution d’e-mails : déclenchez des messages, inspectez l’état de l’application et les preuves de distribution, vérifiez le message destiné à l’utilisateur, puis restaurez la distribution et rapprochez les actions différées ou échouées.
- API inaccessible : interrompez l’itinéraire ou refusez l’identifiant dans un environnement de test ; vérifiez les délais d’expiration, la présentation des erreurs, l’état enregistré et la possibilité de répéter l’action sans risque.
- Webhook retardé : retardez la livraison, puis relâchez-la ; testez les nouvelles tentatives de livraison, les événements dupliqués et les événements dans le désordre lorsque la documentation du fournisseur ou de l’application identifie ces comportements.
- Limite de débit épuisée : simulez des erreurs de quota lorsque cela est possible ; vérifiez des relances limitées, une temporisation progressive et une condition d’arrêt claire.
- Point de terminaison de modèle indisponible : testez un délai d’expiration et une réponse d’erreur ; déterminez si l’application propose un état d’indisponibilité clairement indiqué, diffère le travail ou doit bloquer le workflow.
- Service en amont non sain : rendez indisponibles tous les serveurs derrière un service de proxy inverse avec contrôle de santé, dans un environnement de test ; vérifiez la gestion attendue des 503, l’alerte et le rétablissement.
Consigner les résultats qui déterminent si une défaillance est sûre
Un test est incomplet lorsque le seul résultat est « il a relancé ». Une relance peut faire suite à une opération dont l’issue est inconnue. Un accusé de réception ou une réponse HTTP réussie d’une application ou d’une API externe peut seulement confirmer que la requête a été reçue ou acceptée à cette étape ; cela ne prouve pas nécessairement que tous les traitements en aval sont terminés ni que le résultat métier final est confirmé. Définissez les preuves d’aboutissement requises pour chaque workflow.
Consignez ce que vivent les utilisateurs et ce que les administrateurs doivent faire, mais déterminez aussi si les données sont correctes. Pour chaque opération différée ou relancée, établissez à partir de la documentation de l’application et du fournisseur concernés si une distribution en double, une réorganisation, une finalisation partielle ou des résultats incertains sont possibles. Lorsqu’ils le sont, utilisez une conception sûre face aux doublons et maintenez un plan de rapprochement.
Lorsqu’une API documente la prise en charge de l’idempotence, utilisez son mécanisme documenté pour les requêtes de création ou de mise à jour pouvant être relancées. Ne supposez pas qu’un tel mécanisme existe pour une API qui ne le documente pas.
- Impact utilisateur : tâche exacte affectée, message d’erreur, statut visible et possibilité pour les utilisateurs de poursuivre d’autres tâches.
- Risque d’intégrité des données : l’action peut-elle être perdue, dupliquée, partiellement enregistrée, traitée dans le désordre ou laissée dans un état inconnu ?
- Comportement des relances : déclencheur, délai d’expiration, calendrier, temporisation progressive, nombre maximal de tentatives et état d’échec final.
- Comportement de la file d’attente : emplacement où le travail est conservé, limite d’arriéré, traitement des doublons, hypothèses d’ordre, expiration et méthode de rejeu.
- Observabilité : journaux, métriques, alertes, identifiants de corrélation et preuves utilisées pour décider que le traitement est terminé.
- Actions administrateur : confinement immédiat, étapes de vérification, procédure de rapprochement, contact d’escalade et règle permettant de déclarer le rétablissement terminé.
Concevoir des solutions de repli pratiques et sécurisées
Une bonne solution de repli préserve la sécurité et rend les limites explicites. Ce n’est pas simplement un moyen de forcer le système à continuer. Définissez ce qui peut se poursuivre, ce qui doit être suspendu, qui peut approuver un processus manuel, où l’enregistrement est conservé et comment le travail différé sera rapproché par la suite.
L’accès administratif d’urgence en est un exemple clé. Microsoft recommande de concevoir des comptes d’urgence pour les scénarios de panne d’un fournisseur d’identité fédéré, en utilisant des comptes cloud uniquement qui ne dépendent ni de la fédération ni de la synchronisation sur site. Ces recommandations insistent également sur une authentification forte distincte de celle des comptes administratifs normaux, le stockage sécurisé des identifiants, la journalisation et la supervision, ainsi que des exercices de validation réguliers ([recommandations Microsoft sur l’accès d’urgence](https://learn.microsoft.com/en-us/entra/identity/role-based-access-control/security-emergency-access)).
Pour les activités orientées client, une procédure manuelle peut être plus sûre que des relances automatisées lorsque l’opération peut avoir des conséquences financières, juridiques ou de création de doublons. Une option de travail différé n’est appropriée que si la file d’attente, le statut final et le processus de rapprochement sont compris.
- Accès d’urgence local : accès administrateur étroitement contrôlé et authentifié séparément en cas de panne d’identité ; à utiliser uniquement selon une procédure documentée et testée.
- Processus manuel : solution temporaire limitée dans le temps, telle que l’enregistrement des demandes dans un système approuvé pour saisie ultérieure, avec un responsable et un contrôle de rapprochement.
- Travail différé : mettre en file d’attente le travail éligible jusqu’au retour d’une dépendance, tout en suivant l’arriéré, l’expiration, le traitement des doublons et le statut utilisateur.
- Isolation de fonctionnalité : désactiver uniquement la fonction facultative touchée tout en préservant les workflows centraux sûrs.
- Communication claire : indiquer ce qui est indisponible, ce que les utilisateurs doivent faire à la place, si le travail a été enregistré et quand la prochaine mise à jour sera fournie.
Éviter les contournements qui transforment une panne en incident de sécurité ou de données
Ne faites jamais de « désactiver l’authentification » la réponse par défaut à une panne d’identité. Cela supprime le contrôle précisément lorsque les administrateurs ont une visibilité réduite et subissent une pression accrue. Préparez plutôt une conception d’accès d’urgence limitée, avec des identifiants distincts, un usage restreint, une supervision et des tests planifiés.
De même, ne considérez pas les relances comme une preuve que rien n’a été perdu ou dupliqué. Les limites de débit peuvent aggraver les échecs répétés. Let’s Encrypt applique des limites aux autorisations échouées et recommande l’environnement de test (staging) pendant le dépannage ([documentation Let’s Encrypt sur les limites de débit](https://letsencrypt.org/docs/rate-limits/)). Configurez des relances limitées et une condition d’arrêt, puis examinez ou rapprochez le travail dont l’issue demeure incertaine.
Évitez les identifiants DNS sans restriction par commodité pour l’automatisation des certificats. Let’s Encrypt avertit que placer des identifiants d’API DNS à large portée sur un serveur web augmente l’impact d’une compromission, et suggère des identifiants à portée limitée ou une validation depuis un serveur distinct lorsque cela est possible ([documentation Let’s Encrypt sur les défis](https://letsencrypt.org/docs/challenge-types/)).
- Ne contournez pas les contrôles d’accès sans procédure d’urgence préautorisée et journalisée.
- Ne rejouez pas des transactions dont l’issue est inconnue tant que vous ne pouvez pas déterminer si l’originale a abouti.
- Ne supposez pas qu’un webhook est livré une seule fois ou dans l’ordre sans confirmer le comportement documenté.
- Ne laissez pas une boucle de relance illimitée générer de la charge, des coûts ou un blocage chez le fournisseur.
- N’accordez pas de larges autorisations DNS uniquement pour automatiser une seule tâche de validation.
- Ne clôturez pas un incident sur la seule base de la disponibilité d’un processus ; vérifiez le résultat métier affecté et rapprochez l’arriéré.
Questions fréquentes
Qu’est-ce que la planification des pannes de dépendances pour une application auto-hébergée ?
C’est la pratique qui consiste à identifier chaque service dont dépend une application, classer l’impact métier de la perte de chacun, tester des modes de défaillance réalistes et documenter des actions de repli et de rétablissement sécurisées avant qu’un incident ne survienne.
Chaque dépendance doit-elle avoir le même objectif de rétablissement ?
Non. Définissez les exigences selon la criticité : impact métier, données traitées et service fourni. Une dépendance nécessaire à la connexion ou aux transactions centrales requiert généralement un plan différent de celui d’une dépendance utilisée uniquement pour une fonctionnalité facultative.
Pourquoi un contrôle de santé réussi ne suffit-il pas ?
Un contrôle de santé prouve généralement une condition définie et limitée, telle que la disponibilité d’un processus ou la disponibilité en amont. Il peut ne pas prouver que les utilisateurs peuvent se connecter, envoyer un e-mail, traiter un paiement, récupérer un fichier ou recevoir une réponse d’IA.
Comment tester la résilience des webhooks ?
Testez l’échec de livraison, la livraison retardée, les nouvelles tentatives de livraison, les doublons et les événements dans le désordre lorsque ces comportements sont pertinents pour le fournisseur ou l’application. Vérifiez que le traitement est sûr face aux doublons lorsque nécessaire et que l’équipe peut rapprocher les événements après le rétablissement.
À quoi doit ressembler une solution de repli lors d’une panne du fournisseur d’identité ?
Utilisez un chemin d’accès administrateur d’urgence planifié et étroitement protégé, qui ne dépend pas du chemin de fédération défaillant. Sécurisez les identifiants, utilisez une authentification forte distincte, journalisez les usages, surveillez l’activité et validez régulièrement la procédure. Ne désactivez pas largement les contrôles d’accès.
En quoi l’hébergement géré aide-t-il et qu’est-ce qui reste à la charge du propriétaire de l’application ?
Pour les applications déployées et gérées via Airbip, Airbip gère l’infrastructure cloud autour des instances, y compris les charges de travail Docker sur les serveurs cloud Airbip, le routage et l’automatisation des certificats TLS via Traefik et Let’s Encrypt, les vérifications DNS, la gestion du cycle de vie des services et des sauvegardes quotidiennes, hebdomadaires et mensuelles configurables. Cela peut réduire le nombre de dépendances d’infrastructure qu’une équipe exploite directement. Le propriétaire de l’application doit toujours prendre et tester les décisions relatives aux intégrations applicatives, à l’identité et aux accès, au traitement des données, aux processus métier, aux fournisseurs externes et aux procédures de continuité.
Sources et lectures complémentaires
- Control startup and shutdown order in Compose — Docker
- Define services in Docker Compose — Docker
- Traefik Health Check Documentation — Traefik Labs
- Traefik Getting Started FAQ — Traefik Labs
- Challenge Types — Let's Encrypt / Internet Security Research Group
- Rate Limits — Let's Encrypt / Internet Security Research Group
- The NIST Cybersecurity Framework (CSF) 2.0 — NIST
- NIST CSF 2.0: Quick-Start Guide for Cybersecurity Supply Chain Risk Management — NIST
- OWASP Application Security Verification Standard — OWASP Foundation
- Manage emergency access admin accounts — Microsoft