Une IA auto-hébergée n’est pas automatiquement privée : liste de vérification des flux de données
Héberger vous-même une application d’IA ne prouve pas que les requêtes, les fichiers, les journaux ou les sauvegardes restent sur votre infrastructure. Retracez chaque flux de données et vérifiez chaque destination avant d’utiliser des informations sensibles.
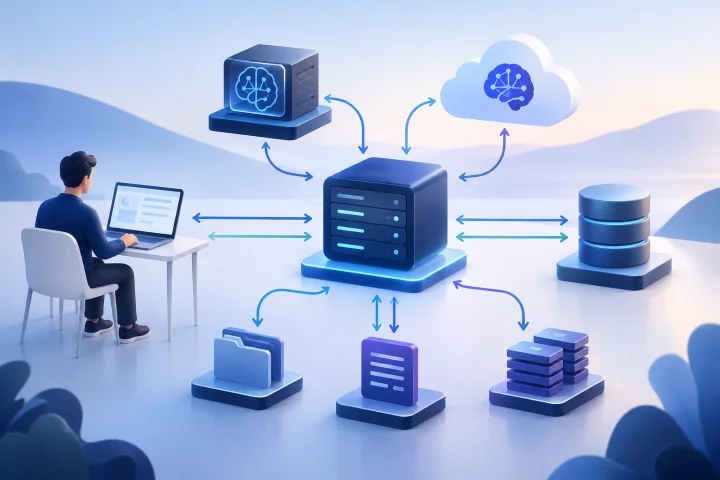
L’auto-hébergement décrit un choix de déploiement, pas un résultat complet en matière de confidentialité
Une application d’IA auto-hébergée fonctionne sur une infrastructure que vous ou un hébergeur avez mise en place. Ce fait ne vous indique pas, à lui seul, où l’inférence a lieu, quels services reçoivent des données, quelles informations sont conservées ni qui peut accéder aux copies utilisées pour l’exploitation.
Considérez l’application et le point d’accès du modèle comme deux parties distinctes du système. L’introduction à l’API d’Ollama, à l’adresse https://github.com/ollama/ollama/blob/main/docs/api/introduction.mdx, décrit une adresse d’API locale ainsi qu’une URL de base pour son API cloud. Sa documentation sur l’authentification, à l’adresse https://github.com/ollama/ollama/blob/main/docs/api/authentication.mdx, explique également que des requêtes vers des modèles cloud peuvent être effectuées par l’intermédiaire de son API locale. Le fait qu’une requête soit envoyée à une interface locale ne prouve donc pas, à lui seul, que le traitement du modèle a lieu localement.
La bonne question n’est pas simplement : « Est-ce auto-hébergé ? » Demandez plutôt : « Pour ce flux de travail et ces types de données, quels systèmes traitent ou stockent les informations, selon quelles conditions, et comment pouvons-nous le vérifier ? »
- Hébergement de l’application : où s’exécutent l’interface destinée aux utilisateurs et les services qui la prennent en charge.
- Hébergement du modèle : où a lieu l’inférence et quel point d’accès reçoit les requêtes.
- Traitement des données : quelles informations sont stockées, journalisées, sauvegardées, transmises ou rendues accessibles aux opérateurs et aux services connectés.

Cartographiez l’ensemble du flux de données avant le déploiement
Cartographiez le flux de travail réel, depuis la personne qui utilise le système jusqu’à chaque composant susceptible de traiter des informations. Incluez l’application d’IA, le point d’accès du modèle, la base de données, le stockage de fichiers, le proxy inverse, les outils connectés, les services d’analyse ou de surveillance et la destination des sauvegardes. Le cas échéant, ajoutez les voies d’accès humaines, par exemple pour l’administration, l’assistance et l’analyse des incidents.
Indiquez pour chaque connexion si elle est locale au déploiement ou externe, et précisez qui exploite chaque destination. « Local » doit signifier local à la machine ou à l’environnement concerné, et non simplement « accessible par une interface qui semble locale ». Vérifiez le point d’accès configuré et le modèle ou le service qu’il appelle réellement.
Faites cet exercice pour chaque fonctionnalité que vous comptez utiliser. La conversation, la recherche dans des documents, le téléversement de fichiers, la récupération d’informations et les intégrations peuvent emprunter des chemins différents. Ne supposez pas que le traitement des données d’une fonctionnalité suit les mêmes règles que celui d’une conversation ordinaire.
- Tracez les requêtes, les réponses, les synchronisations, la journalisation et les sauvegardes à l’aide de flèches.
- Indiquez pour chaque destination son opérateur, son environnement et sa finalité.
- Notez les connexions facultatives et vérifiez si leur désactivation modifie le flux de travail.
- Comparez la configuration et le comportement du réseau à la documentation actuelle du produit ; ne vous fiez ni à une étiquette de produit ni à un réglage par défaut comme preuve.

Faites l’inventaire des données, pas seulement des documents
Dressez la liste des informations qui entrent dans le flux de travail, qui en sont dérivées ou qui y sont générées. Le téléversement d’un document peut entraîner la création de texte extrait, de segments, de représentations vectorielles, de résultats de recherche, de requêtes contenant des passages récupérés et de réponses générées. La présence de chacun de ces éléments dépend de l’application et de sa configuration : vérifiez-la plutôt que de la supposer.
Incluez les métadonnées opérationnelles courantes. Un service peut enregistrer des horodatages, des identifiants de compte, des chemins de requête, des détails d’erreur, le modèle sélectionné ou des informations d’utilisation. Les journaux peuvent contenir plus d’informations que prévu si les requêtes ou les erreurs incluent des valeurs sensibles.
Pour chaque type de données, décrivez son niveau de sensibilité, sa finalité, sa destination et si le flux de travail en a réellement besoin.
- Données entrantes : requêtes, texte collé, fichiers téléversés, images et informations récupérées depuis des sources connectées.
- Données dérivées : texte extrait, segments, représentations vectorielles, index, contenu mis en cache et résumés, si le système en crée.
- Données produites : réponses générées, citations ou passages récupérés, et fichiers créés par l’application.
- Données opérationnelles : journaux de l’application, journaux d’accès du proxy, analyses, rapports d’erreur, métadonnées d’utilisation et enregistrements administratifs.
- Copies : contenu des bases de données, volumes de fichiers, instantanés, exports et sauvegardes.
Vérifiez les conditions de traitement et de conservation de chaque destination
Pour chaque service figurant sur la carte, consultez la documentation primaire à jour et le contrat applicable. Notez les informations reçues par le service, le lieu de traitement, les régions ou sous-traitants susceptibles d’intervenir, la durée de conservation, les personnes qui peuvent y accéder, les modalités de suppression et l’éventuelle utilisation des données à d’autres fins.
Ne considérez pas une déclaration générale d’un fournisseur comme une réponse complète pour toutes les fonctionnalités. La documentation de la plateforme OpenAI, par exemple, à l’adresse https://platform.openai.com/docs/models/default-usage-policies-by-endpoint, distingue les journaux de surveillance des abus de l’état de l’application et présente les informations et les contrôles de conservation par point d’accès. Examinez le point d’accès et la fonctionnalité exacts utilisés par votre application.
Si des données à caractère personnel sont soumises au RGPD, les aspects pertinents comprennent la minimisation des données, la limitation de la conservation, la sécurité, les destinataires et les transferts. Les explications de la Commission européenne sur les principes du RGPD, à l’adresse https://commission.europa.eu/law/law-topic/data-protection/information-business-and-organisations/principles-gdpr_en, couvrent ces principes ainsi que les informations relatives à la transparence. Lorsqu’un fournisseur traite des données à caractère personnel pour le compte d’un responsable du traitement, vérifiez le contrat de sous-traitance applicable et son champ d’application, notamment les conditions d’engagement d’un autre sous-traitant prévues par l’article 28 du RGPD, consultable à l’adresse https://eur-lex.europa.eu/eli/reg/2016/679/oj/. Cette liste de vérification opérationnelle ne remplace pas un avis juridique.
- Traitement : quelles données sont envoyées, pour quelle fonctionnalité et dans quelle région ou quel environnement ?
- Conservation et suppression : quelles données persistent, pendant combien de temps, et que deviennent les sauvegardes ou les données dérivées après une suppression ?
- Accès et réutilisation : qui peut accéder aux données, et sont-elles utilisées pour l’entraînement, l’amélioration du service, la surveillance des abus ou une autre finalité ?
- Contrat et sous-traitants : quelles conditions s’appliquent à votre compte et à votre cas d’usage, et comment les autres sous-traitants sont-ils encadrés ?
- Éléments de preuve : conservez la version de la documentation ou du contrat consultée, la date de consultation et les questions qui restent sans réponse.
N’oubliez pas les journaux, les sauvegardes et les autres copies opérationnelles
Une requête peut être absente de la base de données principale des conversations tout en figurant ailleurs. Vérifiez les journaux de l’application, les journaux d’accès du proxy inverse, les outils d’analyse, les rapports d’erreur, les processus d’assistance, les exports de bases de données, le stockage de fichiers persistant et les sauvegardes. Identifiez les copies automatisées ainsi que celles que des personnes peuvent créer lors d’un dépannage.
Docker décrit les volumes comme des espaces de stockage de données persistants et fournit des procédures pour les sauvegarder et les restaurer, à l’adresse https://docs.docker.com/engine/storage/volumes/. Sa documentation sur les pilotes de journalisation, à l’adresse https://docs.docker.com/engine/logging/configure/, décrit des pilotes qui peuvent envoyer les journaux des conteneurs vers des destinations locales ou externes. La documentation de Traefik sur les journaux d’accès, à l’adresse https://doc.traefik.io/traefik/observe/logs-and-access-logs/, décrit des champs et des en-têtes de requête configurables, ainsi que des options permettant de conserver, d’ignorer ou de masquer des champs. Examinez votre configuration réelle au lieu de supposer que les journaux sont inoffensifs ou locaux.
Pour les sauvegardes, déterminez ce qui est inclus, où elles sont conservées, qui peut y accéder, combien de temps elles sont conservées et comment les demandes de suppression sont traitées. Vérifiez ces détails pour le service et l’offre que vous utilisez réellement.
- Examinez la configuration de journalisation pour repérer les corps de requête, les en-têtes, les paramètres de requête, les détails d’erreur et les destinations externes des journaux.
- Vérifiez si les volumes persistants contiennent des fichiers téléversés, des index, l’historique des conversations ou d’autres états de l’application.
- Documentez le périmètre des sauvegardes, leur destination, les accès, la fréquence, la durée de conservation, la procédure de restauration et le traitement des suppressions.
- Examinez les voies d’accès de l’assistance et des administrateurs, notamment les modalités d’octroi et de retrait des accès.
Testez le flux de travail réel avec des données représentatives
La documentation décrit le comportement attendu ; un test contrôlé aide à établir ce que fait réellement votre configuration déployée. Tant que le flux de données et les conditions ne sont pas compris, utilisez un contenu synthétique ou approuvé, et non des données sensibles de clients.
Soumettez une phrase de test distinctive à chaque flux de travail, puis vérifiez les destinations que vous pouvez inspecter : enregistrements de l’application, stockage persistant, journaux configurés, journaux du proxy, services connectés et paramètres du point d’accès du modèle. Si vous ne pouvez pas examiner directement une destination, demandez des éléments de preuve ou des précisions à son opérateur. Testez également la suppression et distinguez la suppression de l’application active de l’expiration des sauvegardes ou des autres copies conservées.
HTTPS protège le trafic contre certains risques liés au transfert, comme l’explique https://letsencrypt.org/docs/why-all-https/, mais ne permet pas d’établir ce qui se passe après la réception des données par un service. Évaluez séparément la sécurité du transport, le lieu de traitement, la conservation et les accès.
- Effectuez un test pour chaque fonctionnalité : conversation, téléversement de fichiers, récupération de documents, intégrations et toute voie d’exportation ou de partage.
- Vérifiez le point d’accès du modèle réellement utilisé et sa configuration.
- Recherchez la phrase ou le fichier de test dans les systèmes que vous administrez, et notez les destinations que vous ne pouvez pas inspecter.
- Testez les comportements de suppression et de récupération, notamment la persistance éventuelle des données dans des sauvegardes ou des services externes.
- Répétez cette vérification après toute modification importante de la configuration ou lorsque les conditions d’un fournisseur changent.
Transformez les incertitudes en décisions et en règles de fonctionnement
Certaines questions resteront sans réponse, car la documentation publique d’un fournisseur ne couvre pas forcément votre compte, votre point d’accès ou votre contrat précis. Consignez ces lacunes au lieu de transformer une supposition en affirmation sur la confidentialité. Désignez un responsable et une échéance, et déterminez quelles données peuvent être utilisées tant que la question n’est pas résolue.
Définissez des règles adaptées aux éléments vérifiés : quelles informations sont autorisées, lesquelles doivent être supprimées ou masquées, quels flux de travail sont interdits et qui peut approuver des exceptions. Ces règles doivent être compréhensibles et utilisables par les personnes qui saisissent des informations, pas seulement par l’équipe ayant déployé le système.
Pour les données à caractère personnel, faites concorder la finalité documentée, la minimisation des données, la conservation, la sécurité, les destinataires et les transferts avec les obligations applicables à votre organisation. Gardez une trace des systèmes et des conditions examinés afin de pouvoir évaluer les changements ultérieurs.
- Attribuez à chaque flux un statut simple : vérifié, autorisé sous conditions, bloqué ou encore à l’étude.
- Désignez des responsables pour la configuration des points d’accès, les conditions des fournisseurs, les journaux, les sauvegardes, les accès et les consignes destinées aux utilisateurs.
- Établissez une règle claire concernant les données sensibles tant qu’une question importante reste sans réponse.
- Mettez à jour la cartographie lors de l’ajout d’un fournisseur de modèle, d’une intégration, d’une nouvelle source de données, d’une destination de journalisation ou d’un chemin de sauvegarde.
Choisissez le modèle de déploiement qui répond aux exigences vérifiées
L’auto-hébergement de l’application peut vous donner le contrôle de son environnement, mais ne garantit pas que chaque appel de modèle ou chaque copie opérationnelle reste dans cet environnement. Un service de modèles exploité par un tiers peut convenir si les conditions propres à son point d’accès, le traitement, la conservation et le contrat respectent vos obligations. L’inférence exécutée localement peut répondre à des exigences imposant un traitement local par le modèle, mais vérifiez le chemin des requêtes ainsi que le stockage, les journaux et les accès associés.
Comparez les modèles en vous fondant sur des éléments vérifiables, pas sur des étiquettes. Si une exigence stipule que les données ne doivent pas quitter un environnement donné, déterminez quels composants sont inclus dans ce périmètre et testez le flux de travail configuré. Si vous ne pouvez pas vérifier une condition exigée, ne faites pas transiter les données concernées par le système tant que vous n’avez pas obtenu de réponse satisfaisante ou approuvé une solution de remplacement.
Airbip propose le déploiement géré des applications de son catalogue public, avec des instances exécutées comme des charges de travail Docker sur les serveurs cloud d’Airbip. La plateforme automatise le routage et les certificats TLS par l’intermédiaire de Traefik et Let’s Encrypt, et propose des sauvegardes quotidiennes, hebdomadaires et mensuelles configurables. Ces fonctionnalités peuvent faciliter la gestion de l’infrastructure et du cycle de vie des applications, mais elles ne permettent pas, à elles seules, d’établir où un modèle externe traite les données, quelles sont les conditions de conservation d’un service connecté ni le traitement de chaque copie de sauvegarde. Consultez les informations actuelles sur les produits Airbip et les conditions applicables pour connaître les détails pertinents à votre déploiement.
- Choisissez l’hébergement de l’application en fonction de la personne qui doit exploiter l’infrastructure et des responsabilités d’administration que vous pouvez assumer.
- Choisissez un point d’accès de modèle en fonction des exigences vérifiées concernant le traitement, la conservation, les accès, la suppression et les contrats.
- Choisissez l’inférence locale uniquement après avoir vérifié le chemin du modèle et pris en compte le stockage local, les journaux, les sauvegardes et les accès administratifs.
- Si vous ne pouvez pas démontrer le respect du périmètre de données exigé, n’intégrez pas ces données au flux de travail ou choisissez un autre modèle de déploiement.
Questions fréquentes
Comment vérifier où le modèle traite les requêtes ?
Relevez le point d’accès configuré dans l’application et confrontez-le à la documentation applicable au modèle et à la fonctionnalité utilisés. Consignez les éléments de preuve disponibles.
Que dois-je vérifier en plus des requêtes et des fichiers téléversés ?
Faites l’inventaire des données dérivées, comme le texte extrait et les représentations vectorielles si elles sont créées, des réponses générées, des journaux, des analyses, des rapports d’erreur, du stockage persistant, des exports et des sauvegardes. La liste exacte dépend de l’application et de sa configuration.
Le protocole HTTPS prouve-t-il que les données sont privées ?
Non. HTTPS protège le trafic contre certains risques liés au transfert. Il ne permet pas d’établir le lieu de traitement d’un service, ses pratiques d’accès, la conservation, la suppression ou les conditions de réutilisation.
Que faire si la documentation d’un fournisseur ne répond pas à une question importante ?
Consignez cette lacune, demandez au fournisseur la documentation applicable ou des précisions contractuelles, et évitez d’envoyer les données concernées tant que la question n’est pas résolue. En attendant, utilisez un jeu de données de test présentant moins de risques.
Sources et lectures complémentaires
- Volumes: Back up, restore, or migrate data volumes — Docker
- Configure logging drivers — Docker
- Logs and Access Logs — Traefik Labs
- Data controls in the OpenAI platform — OpenAI
- Principles of personal data processing under the GDPR — European Commission
- Regulation (EU) 2016/679, Article 28 — EUR-Lex
- Ollama API introduction — Ollama
- Ollama API authentication — Ollama
- Why All Websites Should Use HTTPS — Internet Security Research Group (Let's Encrypt)