Comment définir un budget de connexions à la base de données pour une application auto-hébergée
Estimez le nombre de connexions que votre application pourrait ouvrir, comparez cette capacité à la limite de votre base de données et validez le budget avec des charges réalistes.
Pourquoi prévoir un budget de connexions à la base de données
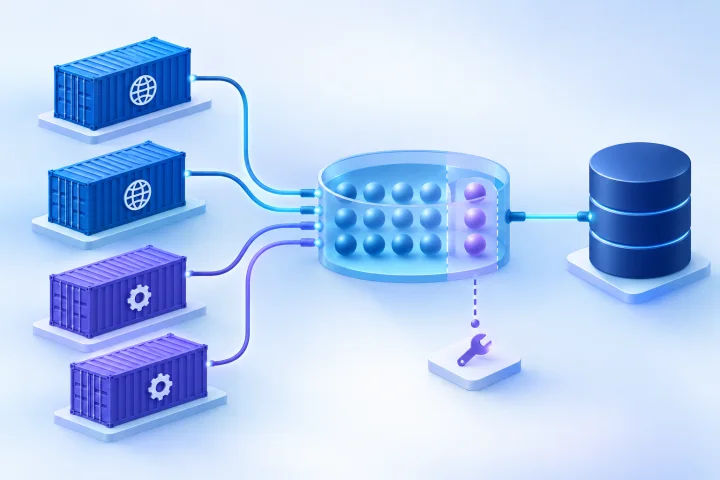
Un budget de connexions à la base de données estime le nombre de connexions simultanées dont un déploiement d’application pourrait avoir besoin, ainsi que la capacité à garder disponible pour la maintenance et les besoins imprévus. Il aide à éviter l’épuisement des connexions sans considérer la limite de la base de données comme un objectif à atteindre.
L’ajout de conteneurs d’application peut augmenter le nombre potentiel de connexions, même si le code et le trafic par conteneur restent identiques. La spécification Compose Deploy de Docker (https://docs.docker.com/reference/compose-file/deploy/) définit les réplicas comme le nombre de conteneurs prévus pour un service répliqué. Si chaque réplica possède ses propres pools, chacun augmente la capacité potentielle.
La capacité configurée n’est pas équivalente à l’utilisation réelle : un pool peut être en mesure d’ouvrir un certain nombre de connexions sans toutes les ouvrir en même temps. Une connexion inactive entre deux requêtes peut tout de même rester ouverte et être comptabilisée dans la limite de la base de données. Une infrastructure gérée ne dispense pas de comprendre le fonctionnement des pools de l’application ni la limite de la base.
- Considérez la capacité configurée des pools comme un plafond que l’application peut atteindre, et non comme une prévision de l’utilisation habituelle.
- Le nombre de connexions ouvertes observé est une mesure à un instant donné, et ne prouve pas que toutes exécutent activement des requêtes.
- Établissez un budget distinct pour chaque base de données si les composants de l’application se connectent à plusieurs bases.

Recenser toutes les sources de connexions
Dressez la liste de chaque processus ou outil pouvant se connecter à la base de données. Ne comptez pas uniquement l’application accessible depuis le web : les tâches en arrière-plan et les opérations peuvent disposer de leurs propres pools ou connexions directes.
Pour chaque source, notez le nombre d’instances pouvant fonctionner simultanément, le nombre de processus ou d’instances de pool par instance, ainsi que la capacité configurée du pool. Vérifiez la configuration du déploiement et la documentation officielle de l’application au lieu de supposer que les paramètres par défaut d’un framework s’appliquent à votre version ou à votre configuration.
- Conteneurs de l’application web, y compris le nombre maximal de réplicas que vous pourriez déployer.
- Conteneurs de travailleurs, ainsi que le nombre de processus de travail ou d’instances de pool de chacun.
- Planificateurs, tâches récurrentes et autres services qui se connectent directement à la base de données.
- Migrations, tâches de déploiement, outils de surveillance et de création de rapports, outils liés aux sauvegardes et sessions d’administration.
- Chevauchement temporaire lors des mises en production ou d’une reprise, si les anciennes et les nouvelles instances peuvent fonctionner simultanément.

Estimer la demande potentielle sans la confondre avec l’utilisation réelle
Pour une première estimation, calculez la capacité configurée maximale de chaque groupe de pools, puis additionnez les groupes qui se connectent à la même base de données. Une formule utile est : capacité potentielle des pools = nombre d’instances actives × nombre d’instances de pool par instance × nombre maximal de connexions par pool. Ajoutez la capacité des travailleurs distincts et des autres services, puis tenez compte des connexions directes qui n’utilisent pas ces pools.
Utilisez le nombre réel d’instances de pool, et non un nombre supposé de conteneurs d’application. Une application peut créer un pool par processus ; plusieurs processus web dans chaque conteneur multiplient alors la capacité à l’échelle des conteneurs. Si un moteur ou un pool est partagé entre plusieurs processus, suivez le comportement documenté de l’application au lieu de le compter deux fois.
Voici un calcul hypothétique, et non une configuration recommandée : trois réplicas, chacun comprenant quatre processus avec une taille maximale de pool de cinq par processus, représentent une capacité potentielle de 60 connexions pour les pools web. Si un service de travailleurs distinct possède deux réplicas avec une capacité de pool de quatre chacun, ajoutez-en huit, soit une capacité potentielle combinée de 68 connexions avant de prendre en compte les migrations, la surveillance ou les accès administratifs.
Ce total est un plafond configuré selon les hypothèses indiquées, et non une prévision de l’utilisation habituelle. Mesurez également les nombres réels sous charge.
- Notez chaque donnée et sa source : nombre de réplicas, processus par instance, instances de pool et limites par pool.
- Utilisez le nombre maximal d’instances que votre déploiement peut atteindre lors d’une montée en charge habituelle ou d’une mise en production, et non seulement le nombre en cours d’exécution aujourd’hui.
- N’ajoutez pas à un même total de base de données les capacités de composants qui ciblent des serveurs de base de données différents.
- Dans les cas documentés de QueuePool de SQLAlchemy, le nombre maximal de connexions utilisées par un moteur est égal à pool_size plus max_overflow. Vérifiez que ce pool et ces paramètres s’appliquent à votre application avant d’utiliser ce calcul. Consultez la documentation de SQLAlchemy sur les limites de pool (https://docs.sqlalchemy.org/en/20/errors.html).
Comparer l’estimation à la limite de la base de données
Comparez la demande potentielle de l’application à la limite documentée de connexions simultanées de la base de données. Ne prévoyez pas d’utiliser toutes les connexions disponibles. Gardez une marge pour la maintenance, les migrations, la surveillance, le diagnostic administratif et les augmentations temporaires de la demande. Déterminez cette réserve en fonction de vos besoins opérationnels et des pics observés : il n’existe pas de pourcentage universellement sûr.
Tenez compte de la façon dont la base de données définit les emplacements utilisables. La documentation PostgreSQL sur les connexions et l’authentification (https://www.postgresql.org/docs/17/runtime-config-connection.html) décrit max_connections comme le nombre maximal de connexions simultanées et précise que son augmentation accroît également l’allocation de certaines ressources, dont la mémoire partagée. PostgreSQL peut réserver des emplacements aux rôles disposant des privilèges appropriés ; tous les emplacements ne sont donc pas nécessairement disponibles pour les connexions ordinaires de l’application.
La documentation MySQL sur les connexions (https://dev.mysql.com/doc/refman/8.0/en/connection-interfaces.html) décrit max_connections comme le nombre maximal de clients simultanés autorisés. Elle documente également une connexion supplémentaire pour un compte doté du privilège CONNECTION_ADMIN ou du privilège SUPER, désormais obsolète, à des fins de diagnostic. Considérez cela comme une disposition administrative décrite par MySQL, et non comme une capacité ordinaire pour l’application.
Si l’estimation approche ou dépasse la limite utilisable, examinez d’abord le nombre de réplicas, le nombre de processus, les tailles des pools et les sources de connexions inutiles. Augmenter la limite de la base de données n’est pas automatiquement la bonne solution : cela peut consommer davantage de ressources et ne corrige ni un pool surdimensionné ni une fuite de connexions.
- Notez la limite configurée de la base de données ainsi que les emplacements réservés ou privilégiés qui la concernent.
- Déduisez la réserve opérationnelle avant de déterminer la capacité restante pour les pools de l’application.
- Consultez la documentation du fournisseur pour la base de données et la configuration que vous utilisez réellement.
- Si vous modifiez la limite, évaluez les conséquences sur les ressources de la base de données et validez le nouveau paramètre au lieu de supposer qu’une valeur plus élevée est sans risque.
Vérifier le fonctionnement du pooling aux deux niveaux
Un pool de l’application et une limite de connexions de la base de données ne contrôlent pas la même chose. Le pool de l’application détermine combien de connexions il peut créer et ce qui se passe lorsqu’elles sont toutes occupées. La limite de la base de données détermine combien de clients celle-ci accepte simultanément. Un pool qui autorise plus de connexions que la base de données ne peut en servir peut déplacer les erreurs de l’application vers la base de données.
Dans les cas documentés de QueuePool de SQLAlchemy, les requêtes supplémentaires attendent lorsque la capacité configurée est occupée et peuvent finir par expirer. La documentation SQLAlchemy (https://docs.sqlalchemy.org/en/20/errors.html) avertit également qu’un dépassement sans limite peut permettre à la demande d’atteindre la limite de connexions de la base de données. Considérez les délais d’expiration du pool comme un signal invitant à examiner la demande et le fonctionnement du pool, et non comme une consigne automatique d’agrandir le pool.
Si PgBouncer fait partie de l’architecture, distinguez les connexions clientes des connexions serveur. Sa documentation de configuration (https://www.pgbouncer.org/config) décrit des limites distinctes pour les clients et les serveurs par base de données ; l’écart entre les deux peut correspondre à des clients en attente de connexions serveur actives. Le mode de pooling influe aussi sur le moment où une connexion serveur peut être réutilisée : en mode session, après la déconnexion du client ; en mode transaction, après la fin d’une transaction. Vérifiez le mode configuré et la compatibilité de l’application dans la documentation.
Ne supposez pas que le pooling est en place simplement parce que l’application ou le déploiement utilise des conteneurs. Déterminez quel composant gère chaque pool, s’il existe par processus et si un proxy se trouve entre l’application et la base de données.
- Consultez la documentation officielle de l’application ou du framework concernant les pools pour la configuration déployée.
- Vérifiez la signification des paramètres de taille du pool, de dépassement, de durée de vie à l’inactivité et de délai d’attente, lorsqu’ils existent.
- Si vous utilisez un proxy de base de données, établissez des budgets distincts pour ses connexions côté client et côté base de données.
- Vérifiez ce qu’il advient d’une connexion à la fin d’une requête, d’une tâche ou d’une transaction.
Valider le budget avec une concurrence représentative
Une estimation théorique n’est qu’un point de départ. Faites fonctionner l’application avec un nombre représentatif de requêtes simultanées et de tâches en arrière-plan, en incluant les schémas de charge importants pour votre équipe. Observez le nombre de connexions ainsi que les files d’attente et les erreurs de l’application, puis comparez le pic à l’estimation et à la capacité réservée.
Pour PostgreSQL, pg_stat_activity (https://www.postgresql.org/docs/16/monitoring-stats.html) fournit une ligne par processus serveur et inclut des champs tels que application_name, user, l’adresse du client, state et la requête en cours. Ces champs peuvent aider à identifier les sources de connexions et à examiner l’activité observée. Utilisez une surveillance adaptée aux autres moteurs ; MySQL indique que le compteur Connection_errors_max_connections augmente lorsqu’une connexion est refusée parce que max_connections a été atteint, dans sa documentation sur les connexions (https://dev.mysql.com/doc/refman/8.0/en/connection-interfaces.html).
Ne testez pas uniquement le parcours web habituel. Incluez un scénario de déploiement ou de migration s’il peut se chevaucher avec le trafic en production, ainsi que l’activité des travailleurs s’ils partagent la base de données. Vérifiez si la demande tient dans le budget prévu et si l’application met les requêtes en attente ou échoue avant que la limite de la base de données ne soit épuisée.
- Notez le pic de connexions ouvertes et, lorsque ces données sont disponibles, l’état des connexions et l’identité de leur source.
- Surveillez les attentes dans les pools de l’application, les délais d’expiration dus aux limites des pools, les refus de connexion et les compteurs de limites côté base de données.
- Comparez le pic observé à la capacité potentielle calculée et à la réserve opérationnelle.
- Refaites cette vérification après toute modification du nombre de réplicas, de la concurrence des travailleurs, des paramètres des pools ou de la configuration de la base de données.
Examiner les signes avant-coureurs avant d’augmenter les limites
Un délai d’expiration du pool peut indiquer que toutes les connexions configurées sont occupées, tandis qu’un refus de la base de données peut indiquer que la limite du serveur a été atteinte. Aucun de ces symptômes ne permet à lui seul d’identifier la cause profonde. Vérifiez si la demande a augmenté, si les tâches durent plus longtemps, si les connexions sont conservées plus longtemps que prévu ou si un composant a créé davantage d’instances de pool que ne le supposait le budget.
Examinez aussi bien les connexions inactives persistantes que les requêtes actives. La documentation SQLAlchemy (https://docs.sqlalchemy.org/en/20/errors.html) précise qu’une connexion libérée peut rester connectée dans son pool afin d’être réutilisée ; des connexions ouvertes ne signifient donc pas nécessairement qu’une requête est en cours. Sur PostgreSQL, utilisez les champs d’identification et d’activité de pg_stat_activity pour vous aider à déterminer l’origine des connexions.
- Délais d’expiration du pool : confirmez la capacité du pool et recherchez une demande soutenue ou des connexions conservées trop longtemps.
- Refus de connexions par la base de données : vérifiez la limite du serveur, la capacité réservée et les sources applicatives qui se connectent.
- Nombre de connexions ouvertes étonnamment élevé : déterminez s’il s’agit de connexions inactives dans des pools, de tâches actives, de pools dupliqués ou d’une fuite.
- Changements soudains après un déploiement : comparez les paramètres des réplicas, des processus, des travailleurs et des pools au budget précédent.
Documenter le budget et les situations qui nécessitent de le revoir
Conservez le calcul avec la configuration de déploiement ou la documentation opérationnelle. Un budget utile peut être reproduit : un autre opérateur peut voir quels processus ont été pris en compte, quels paramètres ont été utilisés, quelle capacité a été réservée et comment l’estimation a été validée.
Considérez le budget comme un élément à réexaminer lorsque le système évolue, et non comme un chiffre à déterminer une seule fois. Airbip exécute des instances d’application sous forme de charges de travail Docker sur des serveurs cloud Airbip et fournit la gestion des déploiements et du cycle de vie des services. Ces capacités d’infrastructure ne déterminent pas le fonctionnement des pools de chaque application et ne remplacent pas la nécessité de revoir son budget de connexions à la base de données. Les équipes restent responsables de comprendre leurs choix applicatifs et d’accès aux données, même lorsque les tâches d’infrastructure sont gérées.
- Documentez la limite de la base de données, les emplacements réservés, les paramètres des pools de l’application et la source de chaque paramètre.
- Indiquez le nombre maximal de réplicas, les processus par instance, la concurrence des travailleurs et les autres sources de connexions.
- Consignez le calcul, la réserve opérationnelle, le pic observé, les conditions de test et les hypothèses connues.
- Désignez un responsable et révisez le budget après une mise à l’échelle, des changements de l’application ou de la base de données, une augmentation de la charge ou une modification du plan de reprise.
- Intégrez les migrations et les accès administratifs aux procédures de déploiement et de reprise afin qu’ils ne soient pas en concurrence inattendue avec la demande de l’application.
Questions fréquentes
La taille d’un pool correspond-elle au nombre de connexions que l’application utilise dans la base de données ?
Non. C’est une capacité configurée, pas nécessairement le nombre de connexions ouvertes ou exécutant des requêtes à un instant donné. Mesurez les connexions observées en plus de calculer le plafond configuré.
Comment estimer le nombre de connexions lorsque j’exécute plusieurs conteneurs d’application ?
Comptez les instances de pool dans chaque conteneur et multipliez leur capacité maximale par le nombre d’instances susceptibles de fonctionner simultanément. Si chaque processus possède un pool distinct, tenez également compte du nombre de processus. Ajoutez les travailleurs et les autres sources de connexions directes qui utilisent la même base de données.
Dois-je augmenter la limite de connexions à la base de données lorsqu’elles sont épuisées ?
Pas automatiquement. Identifiez d’abord les clients qui se connectent, vérifiez si la capacité configurée des pools dépasse ce qui est prévu, si des connexions sont conservées ou fuient, et si la concurrence de la charge a changé. Augmenter max_connections dans PostgreSQL accroît également l’allocation de certaines ressources, dont la mémoire partagée. Consultez la documentation PostgreSQL (https://www.postgresql.org/docs/17/runtime-config-connection.html) et validez les conséquences.
Pour quels usages faut-il réserver des connexions à la base de données ?
Prévoyez de la capacité pour les opérations nécessaires à votre déploiement, telles que la maintenance, les migrations, la surveillance, l’administration et les besoins imprévus. Le volume nécessaire dépend de votre système et de la charge observée ; ne partez pas du principe qu’il existe une réserve universellement sûre.
L’utilisation de PgBouncer signifie-t-elle que je peux ignorer les paramètres des pools de l’application ?
Non. PgBouncer distingue les limites de connexions clientes des limites de connexions serveur, et son mode de pooling influe sur le moment où les connexions serveur peuvent être réutilisées. Établissez un budget pour les deux côtés et vérifiez le mode configuré ainsi que le comportement de l’application dans la documentation officielle de PgBouncer (https://www.pgbouncer.org/config).
Sources et lectures complémentaires
- PostgreSQL: Connections and Authentication — PostgreSQL Global Development Group
- PostgreSQL: The Cumulative Statistics System — PostgreSQL Global Development Group
- SQLAlchemy: Error Messages — Connection Pool Limits — SQLAlchemy
- PgBouncer Configuration — PgBouncer
- Compose Deploy Specification — Docker
- MySQL: Connection Interfaces — Oracle