Um servidor ou dois? Como alojar uma aplicação de IA e o respetivo serviço de inferência
Compare implementações no mesmo servidor e em servidores separados: mapeie os componentes, os fluxos de dados e as responsabilidades operacionais e, em seguida, avalie cada opção à luz dos seus próprios requisitos.
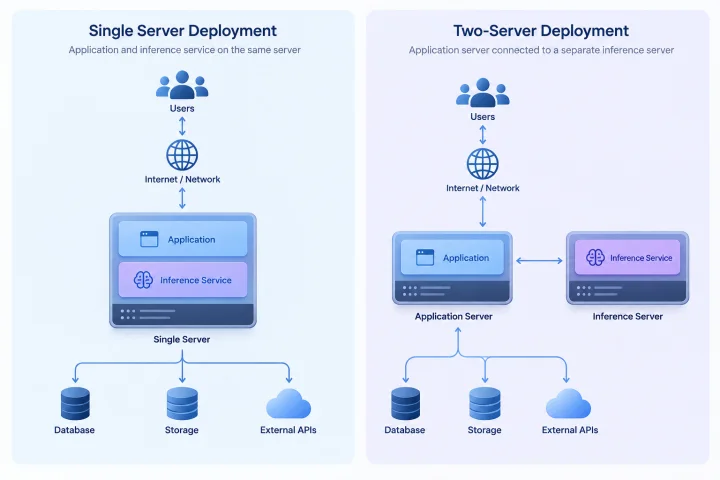
Comece por analisar os dois modelos de implementação
Numa arquitetura no mesmo servidor, a aplicação de IA com que os utilizadores interagem e o serviço que executa a inferência do modelo partilham um servidor. Podem continuar a ser processos de software ou contentores separados, mas utilizam o mesmo anfitrião.
Numa arquitetura separada, a aplicação envia pedidos de inferência para um serviço noutro servidor ou num ponto final gerido. A Microsoft descreve um modelo em que clientes remotos partilham um ponto final de modelo gerido centralmente (documentação da Microsoft: https://learn.microsoft.com/en-us/windows-server/ai/local-ai-inference). Isto sustenta esse modelo específico; não compara as duas arquiteturas nem determina qual é preferível.
As perguntas abaixo servem para investigar os seus próprios requisitos, não constituem orientações universais sobre qual das topologias tem melhor desempenho ou é mais fácil de operar.
- No mesmo servidor: o que implicaria partilhar um anfitrião em termos de recursos, manutenção e recuperação?
- Em servidores separados: de que rede, ponto final e responsabilidades dependeria a aplicação?

Mapeie os componentes e as questões a investigar
Desenhe o sistema como um conjunto de componentes e ligações, não apenas como uma lista de servidores. Inclua a aplicação com que os utilizadores interagem, o ambiente de execução da inferência, os ficheiros do modelo, a base de dados, o armazenamento de ficheiros ou de objetos, as APIs externas, os sistemas de identidade e as tarefas em segundo plano. Assinale os componentes necessários para cada pedido e os que são opcionais.
Para cada componente, registe onde é executado, quem o mantém, que recursos utiliza e o que os utilizadores sentiriam se ficasse indisponível. Estes são aspetos a verificar face à configuração suportada pela aplicação e aos seus requisitos operacionais — não são conclusões decorrentes da escolha de uma arquitetura.
Registe as tarefas que os utilizadores realizam, a concorrência esperada e se os pedidos chegam em períodos de maior intensidade. Se não conhecer estes valores, trate-os como questões a esclarecer num projeto-piloto, em vez de preencher as lacunas com estimativas genéricas de desempenho.
- Enumere a aplicação, o serviço de inferência, a base de dados, o armazenamento, as tarefas agendadas e as APIs externas.
- Para cada ligação, registe a sua finalidade, direção, credenciais e comportamento esperado quando a dependência está indisponível.
- Identifique possíveis sobreposições de recursos a investigar, como a atividade da aplicação e a execução do modelo utilizarem a mesma capacidade de CPU, memória, acelerador, disco ou rede.
- Registe onde são armazenados os ficheiros do modelo, os prompts, os documentos carregados, as respostas geradas e os registos da aplicação.

Questões para uma arquitetura no mesmo servidor
Uma arquitetura no mesmo servidor pode ser uma opção a considerar se estiver a ponderar manter ambos os serviços num único anfitrião. Antes de decidir, investigue se a aplicação suporta a ligação pretendida, se os ficheiros do modelo cabem no plano de armazenamento e se a sua equipa consegue monitorizar e recuperar ambos os componentes.
Pergunte o que aconteceria se a atividade da aplicação e a inferência competissem pelos recursos, ou se uma manutenção ou falha do anfitrião afetasse ambos os serviços. A resposta depende da sua configuração e da experiência aceitável para os utilizadores; a arquitetura, por si só, não determina o impacto.
- É aceitável que a atividade da aplicação e a inferência partilhem um anfitrião e os respetivos períodos de manutenção?
- Como irá verificar o comportamento da aplicação enquanto são executadas tarefas de inferência representativas?
- Que experiência devem ter os utilizadores se a inferência estiver ocupada ou indisponível? Poderão continuar a utilizar as partes da aplicação que não dependem de IA?
Questões para uma arquitetura em servidores separados
Um serviço de inferência separado cria um limite distinto entre serviços e redes. Investigue se esse limite responde a um requisito específico, como diferentes planos de manutenção, gestão de recursos ou administração. A separação, por si só, não garante isolamento, segurança ou melhor desempenho.
A Microsoft documenta um ponto final de inferência operado centralmente e partilhado por clientes remotos. Se estiver a considerar esse modelo, confirme quem pode chamar o ponto final, como o acesso é concedido e revogado e se as aplicações poderão enviar as mesmas categorias de dados.
Pondere o que a aplicação deverá fazer se não conseguir contactar o ponto final, se as credenciais forem inválidas ou se o ponto final devolver um erro. Ao avaliar a arquitetura, atribua responsabilidades pela monitorização, manutenção e recuperação do ponto final.
- A que requisito responderia um limite de serviço separado?
- Quem é responsável pelo ponto final, pelo controlo de acesso, pela manutenção e pela resposta a incidentes?
- Como serão tratados os erros de rede e do ponto final e como serão comunicados aos utilizadores?
Trace os dados e as responsabilidades
Desenhe o fluxo de dados para uma tarefa real. Este poderá incluir a entrada do utilizador, as instruções da aplicação, documentos recuperados ou outro contexto, um pedido ao serviço de inferência e uma resposta. O fluxo efetivo depende da aplicação e da sua configuração, por isso confirme o que é enviado em vez de o presumir.
Para cada elemento de dados, pergunte se atravessa um limite entre serviços, onde é processado e se é guardado nos registos da aplicação, nos registos do serviço, em cópias de segurança ou noutro sistema. Não deduza o comportamento de registo ou retenção com base na localização dos serviços.
Registe quem pode aceder aos dados e às credenciais, que definições de retenção se aplicam e como são geridas as cópias de segurança. Analise separadamente as chamadas a APIs externas; uma arquitetura com dois servidores não implica que todo o processamento permaneça nesses servidores.
- Trace separadamente as entradas, o contexto recuperado, os anexos, as saídas, os identificadores e as credenciais.
- Para cada componente, confirme o que pode ser registado, o que é retido, quem lhe pode aceder e durante quanto tempo é mantido.
- Confirme que dados e configurações da aplicação estão incluídos nas cópias de segurança; documente separadamente como são geridos os ficheiros do modelo e outros recursos de grande dimensão.
- Atribua responsáveis pelas decisões relativas aos dados, ao acesso e à retenção.
Use um projeto-piloto para esclarecer as questões em aberto
Um projeto-piloto pode ajudar a avaliar a aplicação, a configuração do modelo, os dados e as condições operacionais. Afirmações genéricas de desempenho obtidas em testes comparativos não permitem determinar se as suas próprias tarefas, o padrão de concorrência ou as expectativas perante falhas serão aceitáveis.
Execute tarefas representativas na arquitetura ou nas arquiteturas que está a considerar. Inclua a utilização normal e o período de maior atividade realista que conseguir reproduzir. Decida antecipadamente o que vai observar — como o comportamento da aplicação, a conclusão da inferência, o uso de recursos e a adequação dos resultados — e defina critérios de aceitação para o seu caso de utilização.
Se for adequado ao seu ambiente, teste falhas relevantes num contexto controlado: por exemplo, um ponto final indisponível, uma interrupção da ligação de rede ou credenciais inválidas. Registe o comportamento observado e os passos de recuperação, em vez de presumir como o sistema irá reagir.
- Escolha tarefas e entradas representativas, incluindo as etapas relevantes de recuperação de documentos ou chamadas a APIs externas.
- Teste o padrão de utilização esperado e qualquer atividade concorrente realista que consiga reproduzir.
- Observe o comportamento da aplicação e da inferência enquanto os pedidos são processados.
- Defina antecipadamente os critérios de aceitação, incluindo a conclusão das tarefas, a experiência do utilizador, o tratamento dos dados e a capacidade de recuperação.
- Registe a configuração, as pressuposições e os resultados para os poder comparar após alterações.
Documente a decisão e reveja-a quando os requisitos mudarem
Registe a topologia escolhida, os requisitos que se pretende satisfazer e as pressuposições subjacentes à decisão. Inclua os responsáveis pelos componentes, os fluxos de dados, o comportamento relevante perante falhas e as conclusões do projeto-piloto. Reveja a decisão se a carga de trabalho, os planos de manutenção, os requisitos de acesso ou as expectativas de recuperação mudarem; avalie o novo requisito em vez de presumir que uma arquitetura maior é automaticamente melhor.
A Airbip disponibiliza a implementação gerida de aplicações do catálogo como cargas de trabalho Docker em servidores na cloud da Airbip, com encaminhamento automatizado e certificados TLS através do Traefik e do Let's Encrypt, verificações de DNS, gestão do ciclo de vida dos serviços e cópias de segurança diárias, semanais e mensais configuráveis. Estas capacidades de infraestrutura não determinam onde deve ser executado um serviço de inferência específico nem eliminam a responsabilidade do cliente pelas escolhas relativas a dados, acesso e governação. Antes de selecionar um modelo de implementação, confirme que a configuração pretendida da aplicação e a arquitetura de inferência correspondem aos seus requisitos.
- Arquitetura escolhida e requisito a que se pretende responder.
- Pressuposições sobre carga de trabalho, concorrência, localização dos dados e dependências externas.
- Dados que atravessam limites entre serviços, opções de retenção e responsáveis pelo acesso.
- Responsabilidades, comportamento relevante perante falhas, procedimento de recuperação e conclusões do projeto-piloto.
- Condições que levariam a rever a decisão.
Perguntas frequentes
Um servidor de inferência separado melhora sempre o desempenho?
Não há evidência disponível que estabeleça uma vantagem geral de desempenho. A separação altera a disposição dos serviços e introduz uma dependência de rede. Avalie as opções com a sua aplicação, configuração e tarefas representativas.
A instalação dos serviços no mesmo servidor é automaticamente mais segura?
Não. A localização, por si só, não determina o controlo de acesso, a retenção de dados ou a governação. Confirme que dados circulam entre os componentes, quem lhes pode aceder e como são geridos as credenciais e os registos.
O que devemos testar antes de escolher uma arquitetura?
Utilize tarefas representativas e o padrão de utilização esperado. Decida antecipadamente o que vai observar e o que será considerado aceitável. Quando for relevante, teste o comportamento perante falhas e a recuperação num contexto controlado.
Um ponto final de inferência pode servir várias aplicações?
A Microsoft descreve um ponto final de modelo gerido centralmente que pode ser partilhado por clientes remotos (documentação: https://learn.microsoft.com/en-us/windows-server/ai/local-ai-inference). A adequação desse modelo à sua configuração depende da compatibilidade das aplicações, dos controlos de acesso, das políticas de dados e da atribuição de responsabilidades operacionais.
O alojamento gerido de aplicações determina onde é executada a inferência?
Não, por si só. A Airbip gere a implementação de aplicações do catálogo e disponibiliza capacidades de infraestrutura, como encaminhamento, automatização de TLS, verificações de DNS, gestão do ciclo de vida dos serviços e cópias de segurança configuráveis. Confirme separadamente que a arquitetura de inferência e a configuração da aplicação pretendidas satisfazem os seus requisitos.