Inferência local de IA vs. API alojada: perguntas gerais para uma decisão prática
Não existe uma escolha universal entre inferência local e uma API alojada. Use estas perguntas e uma breve ficha de análise para esclarecer limites de dados, carga de trabalho, responsabilidades operacionais e requisitos ainda por resolver.
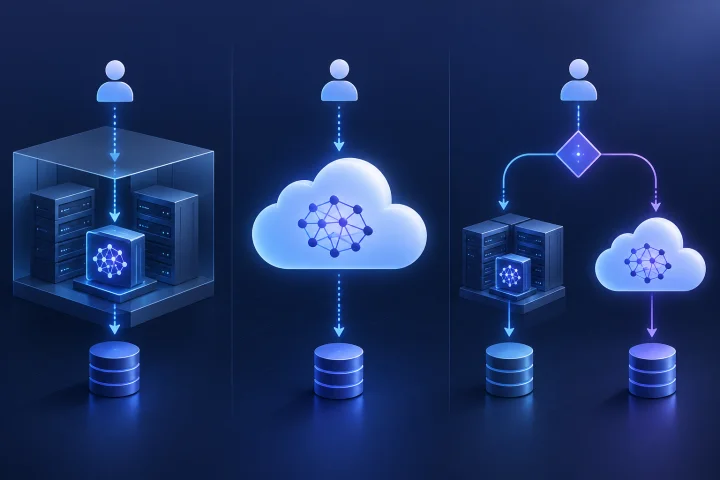
Um conjunto de perguntas, não uma classificação universal
O artigo [“A Cost-Benefit Analysis of On-Premise Large Language Models”](https://arxiv.org/html/2509.18101v1) descreve uma estrutura destinada a ajudar organizações a avaliar em que situações a implementação local pode ser economicamente viável. Este artigo não reproduz essa estrutura nem compara opções com base em resultados medidos. Apresenta perguntas gerais para ajudar uma equipa a identificar o que precisa de investigar.
O alojamento de aplicações e a inferência de modelos são escolhas distintas. Uma aplicação autoalojada pode ser configurada para usar um modelo no mesmo ambiente, uma API alojada ou mais do que um destino. A configuração depende da aplicação e das respetivas definições.
Evite tratar a inferência local como automaticamente mais privada, mais barata ou mais rápida, ou considerar uma API alojada automaticamente mais simples ou mais adequada. Avalie a configuração específica face aos seus requisitos.
- Que componente recebe primeiro o pedido do utilizador?
- Onde está configurada a execução da inferência do modelo?
- Que requisitos excluiriam determinado destino?

Defina os dados e a carga de trabalho
Acompanhe um pedido representativo ao longo da configuração proposta. Anote que componentes o processam e que informações estão envolvidas, como a entrada do utilizador, material anexado ou recuperado, a saída do modelo ou registos operacionais. Confirme os detalhes relevantes na documentação da aplicação e do fornecedor específicos.
Descreva o trabalho que o sistema deverá realizar antes de comparar as opções. Liste tarefas representativas, formatos de entrada e saída, padrões de utilização esperados e o que a sua equipa consideraria um resultado aceitável. Estas são sugestões para definir um teste, não critérios universais de avaliação.
- Que informações seriam processadas por cada componente?
- Que detalhes sobre o tratamento, o acesso ou a retenção de dados precisam de ser confirmados?
- Que tarefas e padrões de utilização representam a carga de trabalho pretendida?
- Que limitações de saída ou requisitos de revisão são importantes?

Identifique responsabilidades e dependências
Para a inferência local, identifique o modelo, o ambiente de execução e a configuração de computação que está a considerar; em seguida, consulte a documentação oficial para conhecer os requisitos e as responsabilidades. Para uma API alojada, consulte a documentação e os termos atuais do fornecedor específico para verificar os detalhes relevantes para a sua utilização, como o tratamento de dados, os controlos de acesso, as quotas, os limites e o comportamento em caso de falha.
Em qualquer uma das abordagens, considere de que componentes a aplicação depende, quem configuraria e manteria a solução e a que a sua equipa consegue dar suporte. Estime os custos com base na sua própria carga de trabalho e nas suas premissas operacionais, em vez de se apoiar numa afirmação geral de que uma abordagem é mais barata.
- Que documentação descreve o modelo, o ambiente de execução ou o fornecedor?
- Quem configuraria e manteria a solução?
- Que dependências ou situações de falha precisam de ser consideradas?
- Que premissas sobre carga de trabalho e operação devem ser incluídas na estimativa de custos?
Uma breve ficha de decisão
Use esta ficha para transformar questões em aberto numa comparação focada. Preencha-a para as configurações específicas que está a considerar e assinale um item como não resolvido quando ainda não tiver uma resposta.
Ficha de decisão
- Tarefas necessárias e material de teste representativo: __________
- Limites dos dados e detalhes a verificar: __________
- Destinos de inferência candidatos e respetiva documentação: __________
- Responsabilidades, dependências e premissas operacionais: __________
- Perguntas que a comparação deve responder: __________
- Revisor, responsável pela decisão e questões por resolver: __________
Trate a inferência híbrida como uma escolha de projeto
Uma configuração híbrida pode ser considerada quando uma equipa pretende usar destinos de inferência diferentes para pedidos diferentes. A possibilidade de o fazer e o comportamento da solução dependem da aplicação e da respetiva configuração.
Antes de depender dessa configuração, especifique as regras de encaminhamento pretendidas, os destinos permitidos e o comportamento de contingência. Consulte a documentação e a configuração relevantes para determinar se essas regras são suportadas como esperado; não presuma que existe uma alternativa de contingência nem que ela preserva o limite de dados pretendido.
- Que pedidos, se houver, devem ser encaminhados para cada destino?
- O que deve acontecer se um destino não conseguir concluir um pedido?
- A configuração documentada suporta o encaminhamento pretendido?
Mantenha separados o alojamento da aplicação e o alojamento da inferência
O alojamento gerido de uma aplicação de IA não determina, por si só, onde é executada a inferência do modelo dessa aplicação. A Airbip oferece implementação gerida para um catálogo público de aplicações empresariais, de publicação, análise, colaboração e IA. As instâncias das aplicações são executadas como cargas de trabalho Docker em servidores na cloud da Airbip. A Airbip automatiza o encaminhamento e os certificados TLS através do Traefik e do Let’s Encrypt, inclui verificações de DNS e gestão do ciclo de vida dos serviços e oferece cópias de segurança diárias, semanais e mensais configuráveis. Os clientes podem usar um subdomínio da Airbip ou um domínio personalizado compatível.
Estes recursos de alojamento não determinam a configuração de inferência de uma aplicação nem eliminam a responsabilidade do cliente pelas decisões relativas a dados, acesso e governação. Consulte a configuração e a documentação da aplicação específica para identificar o endpoint do modelo e os respetivos requisitos. Consulte o site atual da Airbip para obter informações sobre os planos e as condições comerciais em vigor.
A Airbip pode ser relevante quando o requisito é ter alojamento gerido para uma aplicação do seu catálogo. Avalie separadamente qualquer requisito relativo a um ambiente de inferência ou a uma configuração específica de fornecedor.
- Confirme separadamente o alojamento da aplicação e o local da inferência.
- Determine quem é responsável pelo acesso aos dados, pela configuração do modelo e pela governação.
- Consulte as informações atuais do serviço para a implementação e as condições que está a considerar.
Perguntas frequentes
O artigo citado recomenda a implementação local?
O artigo descreve uma estrutura de análise de custos e benefícios destinada a ajudar organizações a avaliar quando a implementação local de LLMs pode ser economicamente viável. A informação citada aqui não apresenta os métodos nem os resultados da análise.
Autoalojar uma aplicação de IA significa que a inferência é local?
Não. O alojamento da aplicação e o local da inferência são aspetos distintos. A configuração da aplicação determina que endpoint de modelo utiliza.
A Airbip determina onde é executada a inferência do modelo?
Não. A Airbip oferece alojamento gerido para aplicações do seu catálogo; o destino de inferência depende da configuração da aplicação.
Fontes e leituras adicionais
- A Cost-Benefit Analysis of On-Premise Large Language Models — arXiv
- Docker documentation — Docker
- Traefik documentation — Traefik Labs
- Let’s Encrypt documentation — Internet Security Research Group
- OWASP Top 10 for LLM Applications — OWASP