O que acontece quando uma dependência falha? Um teste de resiliência para aplicações auto-hospedadas
Um método prático para mapear os serviços dos quais sua aplicação auto-hospedada depende, testar interrupções realistas com segurança e definir alternativas seguras antes de um lançamento ou migração.
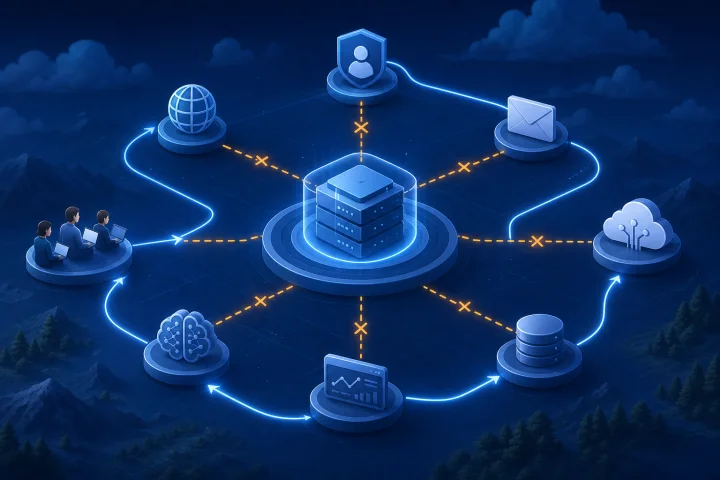
Uma aplicação pode estar saudável enquanto seu trabalho é impossível
Um contêiner em execução, uma solicitação bem-sucedida à página de login ou uma verificação positiva do proxy reverso respondem apenas a uma pergunta limitada: esse componente está respondendo na condição verificada? Isso não prova que usuários consigam entrar pela identidade da organização, enviar uma notificação, recuperar um arquivo, concluir um pagamento, chamar uma API conectada ou obter uma resposta de um serviço de modelos.
O Docker Compose pode iniciar serviços na ordem de dependência, mas somente a ordem de inicialização não significa que uma dependência está pronta para o trabalho da aplicação. A Docker documenta o uso de uma verificação de integridade configurada e da condição `service_healthy` quando um serviço dependente precisa aguardar a prontidão ([documentação do Docker](https://docs.docker.com/compose/how-tos/startup-order/)). Ainda assim, verificações de integridade exigem interpretação precisa: o endpoint `/ping` documentado pelo Traefik é evidência de que o processo do Traefik está ativo, e não prova de que todos os caminhos de aplicações upstream estão utilizáveis ([documentação do Traefik](https://doc.traefik.io/traefik/reference/install-configuration/observability/healthcheck/)).
Trate a resiliência como uma questão baseada em resultados: quais tarefas dos usuários ainda devem ser concluídas, quais podem ser adiadas e quais precisam ser bloqueadas com segurança quando uma dependência está comprometida? Isso produz um plano muito mais útil do que uma lista de integrações.
- Vivacidade: um processo responde a uma solicitação simples.
- Prontidão: um serviço pode aceitar o tipo específico de trabalho que está prestes a receber.
- Conclusão de negócio: o resultado pretendido ocorreu uma única vez, com os dados corretos e qualquer trilha de auditoria exigida.
- Recuperação: a equipe pode restaurar a operação normal, reconciliar trabalhos com resultado incerto e explicar o impacto.

Mapeie as dependências pela função que desempenham
Comece pelas jornadas dos usuários, não pelo arquivo de configuração. Para cada jornada importante — como entrar, criar um cadastro de cliente, publicar conteúdo, enviar uma fatura, aceitar o envio de um formulário ou responder a uma consulta de IA — rastreie todos os serviços necessários, da ação do usuário até o resultado confirmado.
Inclua dependências gerenciadas, externas e operadas por pessoas. Um diagrama de implantação Docker é útil, mas incompleto: DNS, um registrador ou provedor de domínio personalizado, identidade, SMTP ou APIs de e-mail, APIs SaaS, remetentes de webhooks, endpoints de modelos e monitoramento podem estar todos fora da pilha da aplicação. O Docker Compose também suporta serviços de provedores delegados externamente, reforçando que uma carga de trabalho pode depender de recursos cujo ciclo de vida está em outro lugar ([referência do Docker Compose](https://docs.docker.com/reference/compose-file/services/)).
Use os grupos funcionais a seguir para que lacunas se tornem visíveis cedo.
- Identidade e acesso: provedor de identidade, federação, autenticação multifator, diretório de funções, caminho de acesso para administradores.
- Rede e domínio: DNS, configuração de domínio personalizado, proxy reverso, caminho de validação e renovação de certificado TLS.
- Comunicação: relay SMTP, API de e-mail transacional, tratamento de e-mails recebidos, serviços de mensagens ou notificações.
- Dados e arquivos: banco de dados principal, armazenamento de objetos ou arquivos, destino de backup, locais de importação ou exportação.
- Serviços comerciais e conectados: provedor de pagamentos, CRM, contabilidade, análises, mapas, busca, APIs de parceiros e credenciais de API.
- Processamento assíncrono: filas, agendadores, workers, webhooks e endpoints de callback.
- Serviços de IA: endpoint de modelo, serviço de embeddings, banco vetorial, pipeline de recuperação de documentos e credenciais de modelo.
- Operações: logs, monitoramento, entrega de alertas, contatos de incidentes, gestão de segredos e documentação administrativa.

Classifique as dependências pela consequência de perdê-las
Não atribua a mesma meta de resiliência a todas as dependências. A orientação da NIST sobre cadeia de suprimentos apoia a variação dos requisitos conforme a criticidade, considerando o impacto na missão ou no negócio, os dados processados e o produto ou serviço fornecido ([NIST SP 1305](https://nvlpubs.nist.gov/nistpubs/SpecialPublications/NIST.SP.1305.pdf)). Aplique o mesmo raciocínio a cada dependência na arquitetura da sua aplicação.
Uma classificação simples em quatro partes obriga uma decisão sobre a operação degradada aceitável. Um serviço pode aparecer em mais de uma categoria para diferentes fluxos de trabalho; por exemplo, o e-mail pode ser opcional para visualizar registros, mas obrigatório para recuperação de senha ou para uma entrega legalmente importante.
- Necessária para entrar: sem ela, usuários comuns não conseguem estabelecer uma sessão. Defina separadamente uma rota segura de acesso emergencial para administradores.
- Necessária para trabalhar: sem ela, uma transação central não pode ser concluída corretamente. Os exemplos podem incluir o armazenamento de dados principal ou uma API externa obrigatória.
- Necessária para recursos opcionais: os usuários podem continuar seu trabalho principal, mas uma ação não essencial fica indisponível ou é adiada.
- Necessária para recuperação: a operação diária pode continuar temporariamente, mas a restauração, a renovação de certificados, a notificação de incidentes ou a recuperação de dados dependem dela.
- Para cada classificação, defina uma janela de interrupção aceitável, um backlog máximo tolerável, a alternativa permitida e a pessoa autorizada a acioná-la.
Peça evidências, não descrições tranquilizadoras
A documentação do fornecedor e um ambiente de teste devem responder a perguntas operacionais que páginas de marketing muitas vezes não respondem. Registre um link, resultado de teste, referência de configuração ou contato de suporte para cada resposta. Quando a documentação não abordar o comportamento, marque-o como desconhecido em vez de presumir que existe uma tentativa de repetição, fila ou backup.
Verifique o limite exato que está sendo testado. O Traefik observa que, quando as verificações de integridade estão habilitadas e todos os servidores de um serviço estão não saudáveis, ele pode retornar HTTP 503. Isso é uma evidência útil sobre a disponibilidade upstream no limite do proxy reverso, mas não é evidência de que uma transação de usuário foi concluída ([FAQ do Traefik](https://doc.traefik.io/traefik/getting-started/faq/)).
A automação de certificados merece sua própria entrada de dependência. A validação HTTP-01 do Let’s Encrypt exige que a autoridade certificadora recupere um arquivo de desafio do servidor web, enquanto a DNS-01 exige que ela consulte um registro TXT no DNS. A rota relevante, o controle de DNS, o escopo das credenciais e o comportamento de propagação devem, portanto, ser documentados antes que a renovação se torne urgente ([documentação de desafios do Let’s Encrypt](https://letsencrypt.org/docs/challenge-types/)).
- Qual operação exata comprova que a dependência está utilizável, em vez de apenas acessível?
- Quais timeout, código de erro, política de repetição, limite de tentativas e comportamento de espera progressiva se aplicam?
- Uma solicitação pode ser aceita e concluída posteriormente, e onde seu status final pode ser verificado?
- Eventos podem chegar atrasados, mais de uma vez ou fora de ordem?
- A aplicação enfileira trabalho durante uma interrupção? Qual é o limite, a visibilidade e o método de reconciliação da fila?
- Quais credenciais são necessárias para a recuperação, onde são armazenadas e quem pode usá-las?
- Quais alterações de DNS ou rede podem impedir a renovação de certificados ou o acesso ao domínio personalizado?
- Há um ambiente não produtivo ou ambiente de homologação do provedor para validação segura?
Execute testes controlados de falhas que se pareçam com incidentes de produção
Um teste de resiliência deve ter um escopo definido, uma condição de segurança, uma ação de reversão e um observador. Comece em um ambiente não produtivo representativo. Avance para exercícios limitados em produção somente quando o impacto, a autorização, o monitoramento e a reversão forem compreendidos. Não execute um experimento que se espera causar uma falha descontrolada da carga de trabalho.
Teste um fluxo de trabalho real de negócio, não apenas uma verificação de conexão. Por exemplo, se a entrega de e-mails estiver indisponível, teste o convite de conta, a redefinição de senha e a ação que depende de o destinatário receber a mensagem. Registre separadamente se a aplicação aceitou a solicitação, se o provedor de e-mail a aceitou e se o destinatário pretendido consegue concluir a ação exigida. Se um endpoint de modelo estiver indisponível, teste o que o usuário vê, se os documentos de origem permanecem protegidos e se uma interação incompleta é registrada com precisão.
Para a solução de problemas de certificados ou o desenvolvimento de clientes, use o ambiente de homologação do Let’s Encrypt em vez de provocar repetidamente autorizações de produção com falha. O Let’s Encrypt recomenda o ambiente de homologação para diagnosticar condições de autorização sem consumir os limites de produção ([documentação de limites de taxa do Let’s Encrypt](https://letsencrypt.org/docs/rate-limits/)).
- Provedor de identidade indisponível: tente a entrada de usuários comuns, a renovação de sessão, o acesso de administrador e o logout; verifique o acesso emergencial somente sob seus controles documentados.
- Falha na entrega de e-mail: inicie mensagens, inspecione o status da aplicação e as evidências de entrega, verifique a mensagem apresentada ao usuário, depois restaure a entrega e reconcilie ações atrasadas ou com falha.
- API inacessível: interrompa a rota ou negue a credencial em um ambiente de teste; verifique timeouts, apresentação de erros, estado salvo e se a ação pode ser repetida com segurança.
- Webhook atrasado: atrase a entrega e depois libere-a; teste nova entrega, eventos duplicados e eventos fora de ordem quando a documentação do provedor ou da aplicação identificar esses comportamentos.
- Limite de taxa esgotado: simule erros de cota quando possível; verifique tentativas limitadas, espera progressiva e uma condição clara de parada.
- Endpoint de modelo indisponível: teste um timeout e uma resposta de erro; determine se a aplicação oferece um estado de indisponibilidade claramente identificado, adia o trabalho ou precisa bloquear o fluxo de trabalho.
- Upstream não saudável: torne indisponíveis, em um ambiente de teste, todos os servidores por trás de um serviço de proxy reverso com verificação de integridade; verifique o tratamento esperado de 503, os alertas e a recuperação.
Registre os resultados que determinam se uma falha é segura
Um teste está incompleto quando o único resultado é “ele tentou novamente”. Uma repetição pode ocorrer após uma operação cujo resultado é desconhecido. Uma resposta bem-sucedida de uma aplicação ou API externa pode indicar que um limite de processamento foi atingido; ela não prova, por si só, todos os resultados de negócio subsequentes. Defina a evidência de conclusão necessária para cada fluxo de trabalho.
Registre o que os usuários vivenciam e o que os administradores precisam fazer, mas também determine se os dados estão corretos. Para cada operação atrasada ou repetida, estabeleça, a partir da documentação relevante da aplicação e do provedor, se são possíveis entrega duplicada, reordenação, conclusão parcial ou resultados incertos. Quando forem possíveis, use um projeto seguro contra duplicações e mantenha um plano de reconciliação.
Quando uma API documentar suporte à idempotência, use o mecanismo documentado para solicitações de criação ou atualização que possam ser repetidas. Não presuma que esse mecanismo existe em uma API que não o documenta.
- Impacto para o usuário: tarefa exata afetada, mensagem de erro, status visível e se os usuários podem continuar outro trabalho.
- Risco à integridade dos dados: a ação pode ser perdida, duplicada, salva parcialmente, processada fora de ordem ou deixada em estado desconhecido?
- Comportamento de repetição: gatilho, timeout, programação, espera progressiva, número máximo de tentativas e estado final de falha.
- Comportamento da fila: onde o trabalho é mantido, limite de backlog, tratamento de duplicatas, pressupostos de ordenação, expiração e método de reprocessamento.
- Observabilidade: logs, métricas, alertas, IDs de correlação e a evidência usada para decidir que o processamento foi concluído.
- Ações do administrador: contenção imediata, etapas de verificação, procedimento de reconciliação, contato de escalonamento e regra para declarar a recuperação como concluída.
Projete alternativas que sejam práticas e seguras
Uma boa alternativa preserva a segurança e deixa os limites explícitos. Ela não é simplesmente uma forma de forçar o sistema a prosseguir. Defina o que pode continuar, o que deve pausar, quem pode aprovar um processo manual, onde o registro é mantido e como o trabalho adiado será reconciliado depois.
O acesso administrativo emergencial é um exemplo importante. A Microsoft recomenda contas de emergência planejadas para cenários de interrupção de provedores de identidade federados, usando contas exclusivas da nuvem que não dependem de federação ou sincronização local. A mesma orientação enfatiza autenticação forte diferente das contas administrativas normais, armazenamento seguro de credenciais, registro em log e monitoramento, além de exercícios de validação regulares ([orientação da Microsoft sobre acesso emergencial](https://learn.microsoft.com/en-us/entra/identity/role-based-access-control/security-emergency-access)).
Para trabalhos voltados ao cliente, um procedimento manual pode ser mais seguro do que repetições automatizadas quando a operação pode criar consequências financeiras, legais ou de registros duplicados. Uma opção de trabalho adiado é apropriada somente quando a fila, o status final e o processo de reconciliação são compreendidos.
- Acesso local de emergência: acesso de administrador rigidamente controlado e autenticado separadamente para uma interrupção de identidade; use somente conforme um procedimento documentado e testado.
- Processo manual: uma alternativa limitada no tempo, como registrar solicitações em um sistema aprovado para lançamento posterior, com um responsável e uma verificação de reconciliação.
- Trabalho adiado: enfileire o trabalho elegível até que uma dependência retorne, acompanhando backlog, expiração, processamento duplicado e status do usuário.
- Isolamento de recurso: desative apenas a função opcional afetada enquanto preserva fluxos de trabalho centrais seguros.
- Comunicações claras: informe o que está indisponível, o que os usuários devem fazer em vez disso, se o trabalho foi salvo e quando será fornecida a próxima atualização.
Evite soluções alternativas que transformam uma interrupção em um incidente de segurança ou de dados
Nunca faça de “desativar a autenticação” a resposta padrão a uma interrupção de identidade. Isso remove o controle exatamente quando os administradores têm menor visibilidade e maior pressão. Em vez disso, prepare um modelo limitado de acesso emergencial com credenciais distintas, uso restrito, monitoramento e testes agendados.
Da mesma forma, não trate repetições como prova de que nada foi perdido ou duplicado. Limites de taxa podem piorar falhas repetidas. O Let’s Encrypt aplica limites a autorizações com falha e recomenda o ambiente de homologação durante a solução de problemas ([documentação de limites de taxa do Let’s Encrypt](https://letsencrypt.org/docs/rate-limits/)). Configure tentativas limitadas e uma condição de parada, depois investigue ou reconcilie trabalhos cujo resultado permaneça incerto.
Evite credenciais de DNS sem escopo definido por conveniência na automação de certificados. O Let’s Encrypt alerta que colocar credenciais amplas de API de DNS em um servidor web aumenta o impacto de um comprometimento e sugere credenciais com escopo restrito ou validação a partir de um servidor separado quando viável ([documentação de desafios do Let’s Encrypt](https://letsencrypt.org/docs/challenge-types/)).
- Não contorne controles de acesso sem um procedimento emergencial pré-autorizado e registrado em log.
- Não repita transações de resultado desconhecido até que seja possível determinar se a original foi concluída.
- Não presuma que a entrega de webhooks ocorre uma única vez ou em ordem sem confirmar o comportamento documentado.
- Não permita que um ciclo ilimitado de repetições gere carga, custo ou bloqueio pelo provedor.
- Não conceda permissões amplas de DNS apenas para automatizar uma única tarefa de validação.
- Não encerre um incidente baseado somente na vivacidade do processo; verifique o resultado de negócio afetado e reconcilie o backlog.
Perguntas frequentes
O que é planejamento para falhas de dependências em aplicações auto-hospedadas?
É a prática de identificar todos os serviços dos quais uma aplicação depende, classificar o impacto de negócio da perda de cada um, testar modos de falha realistas e documentar alternativas seguras e ações de recuperação antes que ocorra um incidente.
Todas as dependências devem ter o mesmo objetivo de recuperação?
Não. Defina requisitos de acordo com a criticidade: impacto no negócio, dados processados e serviço fornecido. Uma dependência necessária para entrada ou transações centrais geralmente exige um plano diferente de outra usada apenas para um recurso opcional.
Por que uma verificação de integridade bem-sucedida não é suficiente?
Uma verificação de integridade geralmente comprova uma condição restrita e definida, como a vivacidade do processo ou a disponibilidade upstream. Ela pode não provar que usuários conseguem concluir um login, enviar um e-mail, processar um pagamento, recuperar um arquivo ou receber uma resposta de IA.
Como devemos testar a resiliência de webhooks?
Teste falha na entrega, entrega atrasada, nova entrega, duplicatas e eventos fora de ordem quando esses comportamentos forem relevantes para o provedor ou a aplicação. Verifique que o processamento é seguro contra duplicação quando necessário e que a equipe consegue reconciliar eventos após a recuperação.
Como deve ser uma alternativa para uma interrupção do provedor de identidade?
Use uma rota planejada e rigorosamente protegida de acesso administrativo emergencial que não dependa do caminho de federação que falhou. Proteja as credenciais, use autenticação forte distinta, registre o uso em log, monitore a atividade e valide o procedimento regularmente. Não desative controles de acesso de forma ampla.
Onde a hospedagem gerenciada ajuda e o que continua sendo responsabilidade do proprietário da aplicação?
Para aplicações compatíveis, a Airbip gerencia a infraestrutura em nuvem em torno de instâncias de aplicações auto-hospedadas, incluindo cargas de trabalho Docker em servidores na nuvem da Airbip, roteamento e automação de certificados TLS por meio do Traefik e do Let’s Encrypt, verificações de DNS, gestão do ciclo de vida dos serviços e backups diários, semanais e mensais configuráveis. Isso pode reduzir as dependências de infraestrutura que uma equipe opera diretamente. O proprietário da aplicação ainda precisa tomar e testar decisões sobre integrações da aplicação, identidade e acesso, tratamento de dados, processos de negócio, fornecedores externos e procedimentos de continuidade.
Fontes e leituras adicionais
- Control startup and shutdown order in Compose — Docker
- Define services in Docker Compose — Docker
- Traefik Health Check Documentation — Traefik Labs
- Traefik Getting Started FAQ — Traefik Labs
- Challenge Types — Let's Encrypt / Internet Security Research Group
- Rate Limits — Let's Encrypt / Internet Security Research Group
- The NIST Cybersecurity Framework (CSF) 2.0 — NIST
- NIST CSF 2.0: Quick-Start Guide for Cybersecurity Supply Chain Risk Management — NIST
- OWASP Application Security Verification Standard — OWASP Foundation
- Manage emergency access admin accounts — Microsoft