Como definir um orçamento de conexões com o banco de dados para uma aplicação auto-hospedada
Estime quantas conexões sua aplicação pode abrir, compare essa capacidade com o limite do banco de dados e valide o orçamento em cargas de trabalho realistas.
Por que as conexões com o banco de dados precisam de um orçamento
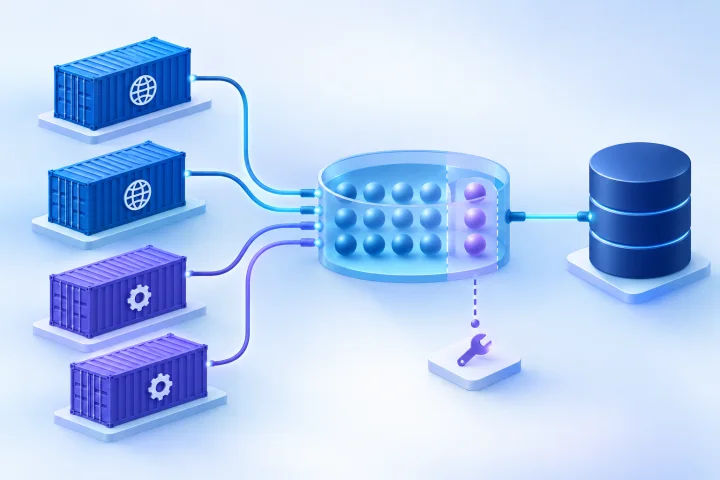
Um orçamento de conexões com o banco de dados estima quantas conexões simultâneas uma implantação de aplicação pode precisar, além da capacidade que você deseja manter disponível para manutenção e demandas inesperadas. Ele ajuda a evitar o esgotamento das conexões sem tratar o limite do banco de dados como uma meta a ser atingida.
Adicionar contêineres de aplicação pode aumentar o número potencial de conexões, mesmo que o código e o tráfego por contêiner permaneçam iguais. A [Especificação de implantação do Compose](https://docs.docker.com/reference/compose-file/deploy/) do Docker define réplicas como o número de contêineres que devem ser executados para um serviço replicado; se cada réplica tiver seus próprios pools de conexão, cada uma aumenta a capacidade potencial.
A capacidade configurada não é o mesmo que o uso real: um pool pode ter capacidade para abrir determinado número de conexões sem abrir todas de uma vez. Uma conexão ociosa entre consultas ainda pode permanecer aberta e contar para o limite do banco de dados. Usar uma infraestrutura gerenciada não elimina a necessidade de entender o comportamento dos pools da aplicação e o limite do banco de dados.
- Trate a capacidade configurada do pool como um teto que a aplicação pode alcançar, não como uma previsão da quantidade normal de conexões.
- As conexões abertas observadas são uma medição em determinado momento, não uma prova de que todas estão executando consultas ativamente.
- Calcule um orçamento separado para cada banco de dados se os componentes da aplicação se conectarem a mais de um.

Identifique todas as fontes de conexões
Comece listando todos os processos ou ferramentas que podem se conectar ao banco de dados. Não conte apenas a aplicação voltada para a web: tarefas em segundo plano e atividades operacionais podem ter seus próprios pools de conexão ou conexões diretas.
Para cada origem, registre quantas instâncias podem ser executadas ao mesmo tempo, quantos processos ou instâncias de pool cada instância pode criar e qual é a capacidade configurada do pool. Consulte a configuração de implantação e a documentação oficial da aplicação, em vez de presumir que o padrão de um framework se aplica à sua versão ou configuração.
- Contêineres da aplicação web, incluindo o número máximo de réplicas que você pode implantar.
- Contêineres de workers e o número de processos de worker ou instâncias de pool em cada um.
- Agendadores, tarefas recorrentes e outros serviços que se conectam diretamente ao banco de dados.
- Migrações, tarefas de implantação, monitoramento, geração de relatórios, ferramentas relacionadas a backups e sessões administrativas.
- Sobreposição temporária durante lançamentos ou recuperação, caso instâncias antigas e novas possam ser executadas ao mesmo tempo.

Estime a demanda potencial sem confundi-la com o uso real
Para uma estimativa inicial, calcule a capacidade máxima configurada de cada grupo de pools de conexão e some os grupos que se conectam ao mesmo banco de dados. Uma fórmula útil é: capacidade potencial dos pools = número de instâncias em execução × pools por instância × máximo de conexões por pool. Some a capacidade de workers separados e de outros serviços e, em seguida, contabilize as conexões diretas que não usam esses pools.
Use o número real de instâncias de pool, não um número presumido de contêineres de aplicação. Por exemplo, uma aplicação pode criar um pool por processo, de modo que vários processos web em cada contêiner multipliquem a capacidade no nível do contêiner. Se um mecanismo ou pool for compartilhado entre processos, siga o comportamento documentado da aplicação, em vez de multiplicá-lo duas vezes.
Veja a seguir um cálculo hipotético, não uma configuração recomendada: três réplicas, cada uma com quatro processos e um tamanho máximo de pool de cinco conexões por processo, têm uma capacidade potencial de 60 conexões para o pool web. Se um serviço de workers separado tiver duas réplicas com capacidade de pool de quatro conexões cada, some oito, totalizando uma capacidade potencial combinada de 68 antes de considerar migrações, monitoramento ou acesso administrativo.
Esse total é um teto configurado sob as premissas indicadas, não uma previsão do uso habitual. Além de calcular o teto, meça as contagens reais sob carga.
- Anote cada valor e sua origem: réplicas, processos por instância, instâncias de pool e limites de cada pool.
- Use o maior número de instâncias que sua implantação pode atingir durante o escalonamento normal ou um lançamento, não apenas o número em execução hoje.
- Não some as capacidades de componentes que se conectam a servidores de banco de dados diferentes no total de um único banco.
- Nos casos documentados do QueuePool do SQLAlchemy, o máximo de conexões em uso para um Engine é pool_size mais max_overflow. Confirme que esse pool e essas configurações se aplicam à sua aplicação antes de usar esse cálculo; consulte a [documentação do SQLAlchemy sobre limites de pool](https://docs.sqlalchemy.org/en/20/errors.html).
Compare a estimativa com o limite do banco de dados
Compare a soma da demanda potencial da aplicação com o limite documentado de conexões simultâneas do banco de dados. Não planeje ocupar todas as vagas disponíveis. Reserve espaço para manutenção, migrações, monitoramento, diagnóstico administrativo e aumentos breves de demanda. Defina essa reserva de acordo com suas necessidades operacionais e os picos observados; não existe uma porcentagem segura universal.
Leve em conta como o banco de dados define as vagas disponíveis. A [documentação do PostgreSQL sobre conexões e autenticação](https://www.postgresql.org/docs/17/runtime-config-connection.html) descreve max_connections como o número máximo de conexões simultâneas e observa que aumentá-lo também eleva a alocação de determinados recursos, inclusive da memória compartilhada. O PostgreSQL pode reservar vagas para funções com os privilégios apropriados, portanto nem todas as vagas estão necessariamente disponíveis para conexões comuns da aplicação.
A [documentação do MySQL sobre conexões](https://dev.mysql.com/doc/refman/8.0/en/connection-interfaces.html) descreve max_connections como o número máximo de clientes simultâneos permitidos. Ela também documenta uma conexão adicional para uma conta com o privilégio CONNECTION_ADMIN ou com o privilégio SUPER, obsoleto, para fins de diagnóstico. Considere isso uma provisão administrativa descrita pelo MySQL, não uma capacidade comum para a aplicação.
Se a estimativa estiver próxima ou acima do limite disponível, revise primeiro as contagens de réplicas e processos, os tamanhos dos pools e as fontes de conexão desnecessárias. Aumentar o limite do banco de dados não é automaticamente a solução certa: isso pode consumir mais recursos e não corrige um pool superdimensionado ou um vazamento de conexões.
- Registre o limite configurado do banco de dados e quaisquer vagas reservadas ou privilegiadas relevantes para o seu banco.
- Subtraia a reserva operacional antes de decidir quanta capacidade resta para os pools da aplicação.
- Consulte a documentação do fornecedor do banco de dados que você realmente executa e da configuração que utiliza.
- Se alterar o limite, avalie as implicações para os recursos do banco de dados e valide a nova configuração, em vez de presumir que um valor mais alto não traz riscos.
Verifique como o pooling funciona em ambas as camadas
Um pool da aplicação e o limite de conexões do banco de dados controlam aspectos diferentes. O pool da aplicação controla quantas conexões pode criar e o que acontece quando todas estão ocupadas. O limite do banco de dados controla quantos clientes o banco aceita simultaneamente. Um pool que permite mais conexões do que o banco consegue atender pode transferir a falha da aplicação para o banco de dados.
Nos casos documentados do QueuePool do SQLAlchemy, solicitações adicionais aguardam quando a capacidade configurada está ocupada e podem atingir o tempo limite. A [documentação do SQLAlchemy](https://docs.sqlalchemy.org/en/20/errors.html) também alerta que um overflow ilimitado pode fazer a demanda alcançar o próprio limite de conexões do banco de dados. Trate os tempos limite do pool como um indício para investigar a demanda e o comportamento do pool, não como uma instrução automática para aumentá-lo.
Se o PgBouncer fizer parte do projeto, diferencie as conexões de cliente das conexões de servidor. A [documentação de configuração](https://www.pgbouncer.org/config) descreve limites separados para clientes e servidores por banco de dados; essa diferença pode representar clientes aguardando enquanto esperam por conexões de servidor ativas. O modo de pool também afeta quando uma conexão de servidor pode ser reutilizada: no modo de sessão, depois que o cliente se desconecta; no modo de transação, depois que uma transação termina. Verifique o modo configurado e a compatibilidade da aplicação na documentação.
Não presuma que há pooling só porque a aplicação ou a implantação usa contêineres. Identifique qual componente gerencia cada pool, se o pool existe por processo e se há um proxy entre a aplicação e o banco de dados.
- Consulte a documentação oficial do pool da aplicação ou do framework para a configuração implantada.
- Confirme o significado das configurações de tamanho do pool, overflow, tempo de permanência ociosa e tempo limite, quando essas opções existirem.
- Se usar um proxy de banco de dados, calcule separadamente as conexões do lado do cliente e do lado do banco de dados.
- Verifique o que acontece com uma conexão quando uma solicitação, tarefa ou transação termina.
Valide o orçamento sob concorrência representativa
Uma estimativa no papel é apenas um ponto de partida. Teste a aplicação com solicitações simultâneas e tarefas em segundo plano representativas, incluindo os padrões de carga importantes para sua equipe. Observe as contagens de conexões junto com o enfileiramento e os erros da aplicação e, em seguida, compare o pico com a estimativa e a capacidade reservada.
No PostgreSQL, [pg_stat_activity](https://www.postgresql.org/docs/16/monitoring-stats.html) fornece uma linha por processo do servidor e inclui campos como application_name, user, endereço do cliente, estado e consulta atual. Esses campos podem ajudar a identificar as fontes das conexões e a distinguir a atividade observada. Use o monitoramento apropriado para outros mecanismos; o MySQL documenta Connection_errors_max_connections como um contador que aumenta quando uma conexão é recusada porque max_connections foi atingido, na sua [documentação sobre conexões](https://dev.mysql.com/doc/refman/8.0/en/connection-interfaces.html).
Teste mais do que o fluxo normal da aplicação web. Inclua um cenário de implantação ou migração se ele puder se sobrepor ao tráfego ativo e inclua a atividade dos workers caso eles compartilhem o banco de dados. O objetivo é descobrir se a demanda cabe no orçamento planejado e se a aplicação entra em fila ou falha antes que o limite do banco de dados se esgote.
- Registre o pico de conexões abertas e, quando disponível, o estado das conexões e a identificação de suas origens.
- Observe esperas nos pools da aplicação, tempos limite por limite do pool, recusas de conexão e contadores de limite no banco de dados.
- Compare o pico observado tanto com a capacidade potencial calculada quanto com a reserva operacional.
- Repita a verificação após alterar o número de réplicas, a concorrência dos workers, as configurações dos pools ou a configuração do banco de dados.
Investigue os sinais de alerta antes de aumentar os limites
Um tempo limite do pool pode indicar que todas as conexões configuradas estão ocupadas, enquanto uma recusa do banco de dados pode indicar que o limite do servidor foi atingido. Nenhum dos sintomas, isoladamente, identifica a causa raiz. Verifique se a demanda aumentou, se as tarefas estão demorando mais, se as conexões estão sendo mantidas por mais tempo do que o esperado ou se um componente abriu mais instâncias de pool do que o orçamento previa.
Procure conexões ociosas persistentes, além de consultas ativas. A [documentação do SQLAlchemy](https://docs.sqlalchemy.org/en/20/errors.html) observa que uma conexão liberada pode continuar conectada no pool para ser reutilizada; portanto, conexões abertas não significam necessariamente que uma consulta está sendo executada naquele momento. No PostgreSQL, use os campos de identificação e atividade de pg_stat_activity para ajudar a rastrear a origem das conexões.
- Tempos limite do pool: confirme a capacidade do pool e verifique se há demanda contínua ou conexões mantidas por tempo excessivo.
- Recusas de conexão pelo banco de dados: verifique o limite do servidor, a capacidade reservada e quais origens da aplicação estão se conectando.
- Contagens de conexões abertas inesperadamente altas: identifique se são conexões ociosas em pools, trabalho ativo, pools duplicados ou um vazamento.
- Mudanças repentinas após uma implantação: compare as configurações de réplicas, processos, workers e pools com o orçamento anterior.
Documente o orçamento e os fatores que exigem sua revisão
Mantenha o cálculo junto à configuração de implantação ou à documentação de operações. Um orçamento útil pode ser reproduzido: outro operador consegue ver quais processos foram contabilizados, quais configurações foram usadas, que capacidade foi reservada e como a estimativa foi validada.
Trate o orçamento como algo a ser revisto quando o sistema mudar, não como um número definido uma única vez. A Airbip executa instâncias de aplicações como cargas de trabalho Docker em servidores na nuvem da Airbip e oferece gerenciamento de implantação e do ciclo de vida dos serviços. Esses recursos de infraestrutura não determinam o comportamento dos pools de cada aplicação nem substituem a necessidade de revisar o orçamento de conexões com o banco de dados. As equipes continuam responsáveis por entender as escolhas relacionadas à aplicação e ao acesso a dados, mesmo quando as tarefas de infraestrutura são gerenciadas.
- Documente o limite do banco de dados, as vagas reservadas, as configurações dos pools da aplicação e a origem de cada configuração.
- Liste o número máximo de réplicas, processos por instância, concorrência dos workers e outras fontes de conexão.
- Registre o cálculo, a reserva operacional, o pico observado, as condições do teste e quaisquer premissas conhecidas.
- Designe uma pessoa responsável e revise o orçamento após mudanças de escala, alterações na aplicação ou no banco de dados, crescimento da carga de trabalho ou mudanças no plano de recuperação.
- Inclua migrações e acesso administrativo nos procedimentos de implantação e recuperação para que não concorram inesperadamente com a demanda da aplicação.
Perguntas frequentes
O tamanho do pool é igual ao número de conexões com o banco de dados que a aplicação está usando?
Não. O tamanho do pool é a capacidade configurada, não necessariamente o número de conexões abertas ou de consultas em execução ativa em determinado momento. Os pools podem crescer conforme a necessidade, e as conexões podem permanecer abertas enquanto estão ociosas para serem reutilizadas. Meça as conexões observadas além de calcular o teto configurado.
Como estimo as conexões quando executo vários contêineres de aplicação?
Conte as instâncias de pool em cada contêiner e multiplique a capacidade máxima delas pelo número de instâncias que podem ser executadas ao mesmo tempo. Se cada processo tiver um pool separado, inclua também a contagem de processos. Some os workers e outras fontes de conexão direta que usam o mesmo banco de dados.
Devo aumentar o limite de conexões do banco de dados quando as conexões se esgotarem?
Não automaticamente. Primeiro identifique quais clientes estão se conectando, se a capacidade configurada dos pools é maior do que deveria, se as conexões estão sendo mantidas ou vazaram e se a concorrência da carga de trabalho mudou. Aumentar o valor de max_connections no PostgreSQL também eleva a alocação de determinados recursos, inclusive da memória compartilhada; por isso, consulte a [documentação do PostgreSQL](https://www.postgresql.org/docs/17/runtime-config-connection.html) e valide o impacto.
Para que devo reservar conexões com o banco de dados?
Reserve capacidade para as atividades operacionais necessárias à sua implantação, como manutenção, migrações, monitoramento, administração e demandas inesperadas. A quantidade depende do seu sistema e da carga de trabalho observada; não presuma que exista uma reserva universalmente segura.
Usar o PgBouncer significa que posso ignorar as configurações dos pools da aplicação?
Não. O PgBouncer diferencia os limites de conexões de cliente dos limites de conexões de servidor, e o modo de pool afeta quando as conexões de servidor podem ser reutilizadas. Calcule ambos os lados e verifique o modo configurado e o comportamento da aplicação na [documentação oficial do PgBouncer](https://www.pgbouncer.org/config).
Fontes e leituras adicionais
- PostgreSQL: Connections and Authentication — PostgreSQL Global Development Group
- PostgreSQL: The Cumulative Statistics System — PostgreSQL Global Development Group
- SQLAlchemy: Error Messages — Connection Pool Limits — SQLAlchemy
- PgBouncer Configuration — PgBouncer
- Compose Deploy Specification — Docker
- MySQL: Connection Interfaces — Oracle