IA auto-hospedada não significa automaticamente privacidade: uma lista de verificação do fluxo de dados
Hospedar uma aplicação de IA por conta própria não comprova que prompts, arquivos, registros ou backups permanecem na sua infraestrutura. Trace todos os fluxos de dados e verifique cada destino antes de usar informações sensíveis.
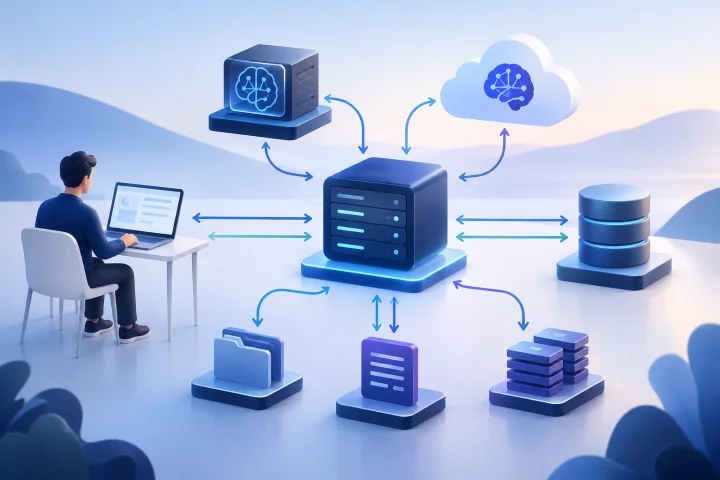
Auto-hospedagem descreve uma escolha de implantação, não um resultado completo de privacidade
Uma aplicação de IA auto-hospedada é executada em uma infraestrutura providenciada por você ou por um provedor de hospedagem. Esse fato, por si só, não informa onde ocorre a inferência, quais serviços recebem dados, o que é retido ou quem pode acessar cópias operacionais.
Considere a aplicação e o endpoint do modelo como partes distintas do sistema. A [introdução à API do Ollama](https://github.com/ollama/ollama/blob/main/docs/api/introduction.mdx) descreve um endereço de API local, além de um URL base para a API na nuvem. A [documentação de autenticação](https://github.com/ollama/ollama/blob/main/docs/api/authentication.mdx) também explica que é possível fazer chamadas a modelos na nuvem por meio da API local. O fato de uma solicitação ser enviada a uma interface local não comprova, por si só, que o processamento do modelo é local.
A pergunta certa não é simplesmente “Esta aplicação é auto-hospedada?”. Em vez disso, pergunte: “Neste fluxo de trabalho e para estes tipos de dados, quais sistemas processam ou armazenam informações, sob quais condições e como podemos verificar isso?”
- Hospedagem da aplicação: onde são executados a interface usada pelas pessoas e os serviços que a sustentam.
- Hospedagem do modelo: onde ocorre a inferência e qual endpoint recebe as solicitações.
- Tratamento de dados: o que é armazenado, registrado, incluído em backups, transmitido ou disponibilizado a operadores e serviços conectados.

Desenhe o fluxo completo de dados antes da implantação
Mapeie o fluxo real de trabalho, da pessoa que usa o sistema a cada componente que possa tratar informações. Inclua a aplicação de IA, o endpoint do modelo, o banco de dados, o armazenamento de arquivos, o proxy reverso, as ferramentas conectadas, os serviços de análise ou monitoramento e o destino dos backups. Quando aplicável, inclua também caminhos de acesso humano, como administração, suporte e investigação de incidentes.
Identifique cada conexão como local à implantação ou externa a ela e anote quem opera cada destino. “Local” deve significar local à máquina ou ao ambiente relevante, e não simplesmente “acessado por uma interface que parece local”. Confirme o endpoint configurado e o modelo ou serviço ao qual ele realmente faz chamadas.
Faça isso para cada recurso que pretende usar. Chat, pesquisa em documentos, upload de arquivos, recuperação de informações e integrações podem seguir caminhos diferentes. Não presuma que o tratamento de dados de um recurso obedece às mesmas regras do chat comum.
- Desenhe setas para solicitações, respostas, sincronização, registros e backups.
- Identifique cada destino com seu operador, ambiente e finalidade.
- Registre quais conexões são opcionais e se desativá-las altera o fluxo de trabalho.
- Compare a configuração e o comportamento da rede com a documentação atual do produto; não confie em um rótulo de produto ou em uma configuração padrão como prova.

Faça o inventário dos dados, não apenas dos documentos
Liste as informações que entram no fluxo de trabalho, que são derivadas dele ou que são geradas por ele. O envio de um documento pode resultar em texto extraído, trechos, embeddings, resultados de pesquisa, prompts com passagens recuperadas e respostas geradas. A existência de cada item depende da aplicação e da configuração; por isso, verifique em vez de presumir.
Inclua os metadados operacionais comuns. Um serviço pode registrar horários, identificadores de conta, caminhos de solicitações, detalhes de erros, seleção de modelos ou informações de uso. Os registros podem conter mais do que as equipes esperam quando solicitações ou erros incluem valores sensíveis.
Para cada tipo de dado, descreva sua sensibilidade, finalidade, destino e se o fluxo de trabalho realmente precisa dele.
- Entradas: prompts, texto colado, arquivos enviados, imagens e informações recuperadas de fontes conectadas.
- Dados derivados: texto extraído, trechos, embeddings, índices, conteúdo em cache e resumos, se o sistema os criar.
- Saídas: respostas geradas, citações ou passagens recuperadas e arquivos criados pela aplicação.
- Dados operacionais: registros da aplicação, registros de acesso do proxy, análises, relatórios de erros, metadados de uso e registros administrativos.
- Cópias: conteúdo de bancos de dados, volumes de arquivos, snapshots, exportações e backups.
Verifique as condições de processamento e retenção de cada destino
Para cada serviço no mapa, consulte a documentação primária atual e o contrato aplicável. Registre o que o serviço recebe, onde ocorre o processamento, quais regiões ou subprocessadores podem estar envolvidos, por quanto tempo as informações são mantidas, quem pode acessá-las, como funciona a exclusão e se os dados podem ser usados para outras finalidades.
Não considere uma declaração geral do provedor como resposta completa para todos os recursos. A [documentação da plataforma OpenAI](https://platform.openai.com/docs/models/default-usage-policies-by-endpoint), por exemplo, diferencia registros de monitoramento de abuso do estado da aplicação e apresenta informações e controles de retenção por endpoint. Analise o endpoint e o recurso exatos usados pela sua aplicação.
Se dados pessoais estiverem sujeitos ao Regulamento Geral sobre a Proteção de Dados (RGPD), os aspectos relevantes incluem minimização de dados, limitação da conservação, segurança, destinatários e transferências. A [orientação da Comissão Europeia sobre os princípios do RGPD](https://commission.europa.eu/law/law-topic/data-protection/information-business-and-organisations/principles-gdpr_en) aborda esses princípios e as informações de transparência. Quando um provedor trata dados pessoais em nome de um responsável pelo tratamento, verifique o contrato de tratamento aplicável e seu escopo, incluindo as condições para recorrer a outro subprocessador, conforme o [artigo 28 do RGPD](https://eur-lex.europa.eu/eli/reg/2016/679/oj/). Esta é uma lista de verificação operacional, não substitui aconselhamento jurídico.
- Processamento: quais dados são enviados, para qual recurso e em que região ou ambiente?
- Retenção e exclusão: o que persiste, por quanto tempo e o que acontece com backups ou dados derivados após a exclusão?
- Acesso e reutilização: quem pode acessar os dados e eles são usados para treinamento, melhoria do serviço, monitoramento de abuso ou outra finalidade?
- Contrato e subprocessadores: quais condições se aplicam à sua conta e ao seu caso de uso, e como outros subprocessadores são abrangidos?
- Evidências: guarde a versão da documentação ou do contrato analisada, a data e quaisquer perguntas ainda sem resposta.
Inclua registros, backups e outras cópias operacionais
Um prompt pode não estar no banco de dados principal do chat e, ainda assim, aparecer em outros lugares. Verifique os registros da aplicação, os registros de acesso do proxy reverso, as ferramentas de análise, os relatórios de erros, os fluxos de suporte, as exportações do banco de dados, o armazenamento persistente de arquivos e os backups. Identifique tanto as cópias automatizadas quanto as que as pessoas podem criar durante a resolução de problemas.
A [documentação do Docker descreve os volumes como armazenamentos persistentes de dados](https://docs.docker.com/engine/storage/volumes/) e fornece procedimentos para fazer backup e restaurá-los. A [documentação dos drivers de registro do Docker](https://docs.docker.com/engine/logging/configure/) descreve drivers que podem enviar registros de contêineres para destinos locais ou externos. A [documentação de registros de acesso do Traefik](https://doc.traefik.io/traefik/observe/logs-and-access-logs/) descreve campos e cabeçalhos de solicitações configuráveis, incluindo opções para manter, descartar ou ocultar campos. Inspecione sua configuração real, em vez de presumir que os registros são inofensivos ou locais.
Para os backups, determine o que está incluído, onde são guardados, quem pode acessá-los, por quanto tempo permanecem e como são tratados os pedidos de exclusão. Confirme esses detalhes para o serviço e o plano que você realmente usa.
- Inspecione a configuração de registro para verificar corpos de solicitações, cabeçalhos, parâmetros de consulta, detalhes de erros e destinos externos de registros.
- Verifique se os volumes persistentes contêm uploads, índices, histórico de chat ou outros dados da aplicação.
- Documente o escopo, o destino, o acesso, a frequência, a retenção, o processo de restauração e o comportamento de exclusão dos backups.
- Analise os caminhos de acesso de suporte e administração, incluindo como o acesso é concedido e revogado.
Teste o fluxo de trabalho real com dados representativos
A documentação descreve o comportamento pretendido; um teste controlado ajuda a determinar o que a configuração implantada realmente faz. Use conteúdo sintético ou de teste aprovado, não registros sensíveis de clientes, até compreender o fluxo de dados e as condições aplicáveis.
Envie uma frase de teste distintiva por cada fluxo de trabalho e verifique os destinos que você pode inspecionar: registros da aplicação, armazenamento persistente, registros configurados, registros do proxy, serviços conectados e configurações do endpoint do modelo. Quando não puder inspecionar diretamente um destino, peça evidências ou esclarecimentos ao operador. Teste também a exclusão e diferencie a remoção da aplicação ativa do vencimento de backups ou de outras cópias retidas.
O [HTTPS protege o tráfego contra certos riscos durante a transmissão](https://letsencrypt.org/docs/why-all-https/), mas não determina o que acontece depois que um serviço recebe os dados. Trate a segurança do transporte, o local de processamento, a retenção e o acesso como verificações separadas.
- Execute um teste para cada recurso: chat, upload de arquivos, recuperação de documentos, integrações e qualquer caminho de exportação ou compartilhamento.
- Verifique o endpoint e a configuração reais do modelo; um endereço de API local, por si só, não comprova que a inferência é local.
- Pesquise a frase ou o arquivo de teste nos sistemas que você administra e anote quais destinos não podem ser inspecionados.
- Teste o comportamento de exclusão e recuperação, inclusive se os dados permanecem em backups ou serviços externos.
- Repita a verificação após mudanças importantes na configuração ou quando as condições de um provedor forem alteradas.
Transforme incertezas em decisões e regras operacionais
Algumas perguntas continuarão sem resposta porque a documentação pública de um provedor pode não abranger sua conta, seu endpoint ou seu contrato específicos. Registre essas lacunas, em vez de transformar uma suposição em uma afirmação sobre privacidade. Designe uma pessoa responsável e um prazo, e determine quais dados podem ser usados enquanto a questão não for resolvida.
Defina regras compatíveis com as evidências: quais informações são permitidas, quais devem ser removidas ou mascaradas, quais fluxos de trabalho são proibidos e quem pode aprovar exceções. As regras devem ser práticas para as pessoas que inserem informações, não apenas para a equipe que implantou o sistema.
No caso de dados pessoais, alinhe a finalidade documentada, a minimização de dados, a retenção, a segurança, os destinatários e as transferências às obrigações aplicáveis à sua organização. Mantenha um registro dos sistemas e das condições analisados para que mudanças possam ser avaliadas posteriormente.
- Use um status simples para cada fluxo: verificado, permitido sob condições, bloqueado ou ainda em análise.
- Designe responsáveis pela configuração dos endpoints, pelas condições dos fornecedores, pelos registros, pelos backups, pelo acesso e pelas orientações aos usuários.
- Estabeleça uma regra clara para dados sensíveis enquanto qualquer questão relevante permanecer sem resposta.
- Revise o mapa ao adicionar um provedor de modelos, uma integração, uma nova fonte de dados, um destino de registros ou um caminho de backup.
Escolha o modelo de implantação que atenda aos requisitos verificados
A auto-hospedagem da aplicação pode dar controle sobre o ambiente da aplicação, mas não garante que todas as chamadas a modelos ou cópias operacionais permaneçam nesse ambiente. Um serviço de modelos operado externamente pode ser adequado se as condições específicas do endpoint, o processamento, a retenção e o contrato forem compatíveis com suas obrigações. A inferência operada localmente pode atender a requisitos que exigem processamento local do modelo, mas verifique o trajeto das solicitações e o armazenamento, os registros e os controles de acesso ao redor.
Compare as opções com base em evidências, não em rótulos. Se um requisito determinar que os dados não podem sair de um ambiente específico, estabeleça quais componentes estão incluídos nesse limite e teste o fluxo de trabalho configurado. Se não puder verificar uma condição obrigatória, não encaminhe os dados afetados pelo sistema até obter uma resposta adequada ou aprovar uma alternativa.
A Airbip oferece implantação gerenciada de aplicações do seu catálogo público, com instâncias executadas como cargas de trabalho Docker em servidores de nuvem da Airbip. A empresa automatiza o roteamento e os certificados TLS por meio do Traefik e do Let’s Encrypt, e oferece backups diários, semanais e mensais configuráveis. Esses recursos podem ajudar com a infraestrutura da aplicação e tarefas de ciclo de vida, mas, por si só, não determinam onde um modelo externo processa dados, quais são as condições de retenção de um serviço conectado nem como cada cópia de backup é tratada. Consulte as informações atuais dos produtos da Airbip e as condições aplicáveis para obter detalhes relevantes para sua implantação.
- Escolha a hospedagem da aplicação com base em quem deve operar a infraestrutura e nas responsabilidades de administração que sua equipe pode assumir.
- Escolha um endpoint de modelo com base em requisitos verificados de processamento, retenção, acesso, exclusão e contrato.
- Escolha a inferência local somente depois de verificar a rota do modelo e considerar o armazenamento local, os registros, os backups e o acesso administrativo.
- Se não for possível demonstrar o limite exigido para os dados, mantenha esses dados fora do fluxo de trabalho ou escolha outro modelo de implantação.
Perguntas frequentes
Auto-hospedar uma aplicação de IA significa que os prompts permanecem no meu servidor?
Não necessariamente. A aplicação pode enviar prompts para um endpoint de modelo separado. Verifique a rota configurada e a documentação atual para o modelo e o recurso específicos.
O que devo verificar além dos prompts e arquivos enviados?
Faça o inventário dos dados derivados, como texto extraído e embeddings, se forem criados, além de respostas geradas, registros, análises, relatórios de erros, armazenamento persistente, exportações e backups. A lista exata depende da aplicação e da configuração.
O HTTPS comprova que os dados são privados?
Não. O HTTPS protege o tráfego contra certos riscos durante a transmissão. Não determina o local de processamento, as práticas de acesso, a retenção, a exclusão ou as condições de reutilização de um serviço.
E se a documentação do fornecedor não responder a uma pergunta importante?
Registre a lacuna, peça ao fornecedor a documentação aplicável ou esclarecimentos contratuais e evite enviar dados que dependam dessa resposta até que a questão seja resolvida. Enquanto isso, use um conjunto de dados de teste de menor risco.
Fontes e leituras adicionais
- Volumes: Back up, restore, or migrate data volumes — Docker
- Configure logging drivers — Docker
- Logs and Access Logs — Traefik Labs
- Data controls in the OpenAI platform — OpenAI
- Principles of personal data processing under the GDPR — European Commission
- Regulation (EU) 2016/679, Article 28 — EUR-Lex
- Ollama API introduction — Ollama
- Ollama API authentication — Ollama
- Why All Websites Should Use HTTPS — Internet Security Research Group (Let's Encrypt)