Cosa succede quando una dipendenza non funziona? Un test di resilienza per applicazioni self-hosted
Un metodo pratico per mappare i servizi da cui dipende la tua applicazione self-hosted, testare in sicurezza interruzioni realistiche e definire fallback sicuri prima di un lancio o di una migrazione.
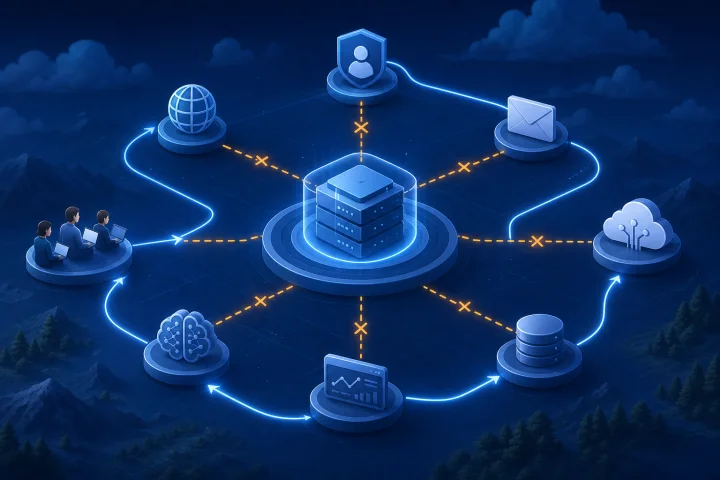
Un'applicazione può essere in salute mentre il suo lavoro è impossibile
Un container in esecuzione, una richiesta riuscita alla pagina di accesso o un controllo verde del reverse proxy rispondono solo a una domanda circoscritta: quel componente risponde nella condizione verificata? Non dimostrano che gli utenti possano accedere tramite il provider di identità dell'organizzazione, inviare una notifica, recuperare un file, completare un pagamento, chiamare un'API connessa o ottenere una risposta da un servizio di modelli.
Docker Compose può avviare i servizi nell'ordine delle dipendenze, ma il solo ordine di avvio non significa che una dipendenza sia pronta per il lavoro dell'applicazione. Docker documenta l'uso di un controllo di integrità configurato e della condizione `service_healthy` quando un servizio dipendente deve attendere la disponibilità ([documentazione Docker](https://docs.docker.com/compose/how-tos/startup-order/)). Anche in questo caso, i controlli di integrità richiedono un'interpretazione precisa: l'endpoint `/ping` documentato da Traefik attesta che il processo Traefik è attivo, non che ogni percorso verso le applicazioni upstream sia utilizzabile ([documentazione Traefik](https://doc.traefik.io/traefik/reference/install-configuration/observability/healthcheck/)).
Considera la resilienza come una questione basata sui risultati: quali attività utente devono continuare a riuscire, quali possono essere ritardate e quali devono essere bloccate in sicurezza quando una dipendenza è compromessa? Questo produce un piano molto più utile di un elenco di integrazioni.
- Liveness: un processo risponde a una semplice richiesta.
- Readiness: un servizio può accettare il tipo specifico di lavoro che sta per ricevere.
- Completamento business: il risultato previsto si è verificato una volta, con i dati corretti e qualsiasi traccia di audit richiesta.
- Ripristino: il team può ripristinare la normale operatività, riconciliare il lavoro dall'esito incerto e spiegare l'impatto.

Mappa le dipendenze in base alla funzione che svolgono
Inizia dai percorsi utente, non dal file di configurazione. Per ogni percorso importante, ad esempio accesso, creazione di un record cliente, pubblicazione di contenuti, invio di una fattura, accettazione dell'invio di un modulo o risposta a una query AI, traccia ogni servizio necessario dall'azione dell'utente al risultato confermato.
Includi dipendenze gestite, esterne e operate da persone. Un diagramma di deployment Docker è utile ma incompleto: DNS, registrar o provider di domini personalizzati, identità, SMTP o API email, API SaaS, mittenti di webhook, endpoint di modelli e monitoraggio possono trovarsi tutti al di fuori dello stack applicativo. Docker Compose supporta inoltre servizi provider delegati esternamente, a conferma che un carico di lavoro può dipendere da risorse il cui ciclo di vita è gestito altrove ([riferimento Docker Compose](https://docs.docker.com/reference/compose-file/services/)).
Usa i seguenti gruppi funzionali per rendere visibili le lacune fin dalle prime fasi.
- Identità e accesso: provider di identità, federazione, autenticazione a più fattori, directory dei ruoli, percorso di accesso per gli amministratori.
- Rete e dominio: DNS, configurazione del dominio personalizzato, reverse proxy, convalida dei certificati TLS e percorso di rinnovo.
- Comunicazione: relay SMTP, API email transazionale, gestione delle email in entrata, servizi di messaggistica o notifica.
- Dati e file: database primario, storage di oggetti o file, destinazione dei backup, posizioni di importazione o esportazione.
- Servizi commerciali e connessi: provider di pagamenti, CRM, contabilità, analisi, mappe, ricerca, API di partner e credenziali API.
- Elaborazione asincrona: code, pianificatori, worker, webhook ed endpoint di callback.
- Servizi AI: endpoint del modello, servizio di embedding, vector store, pipeline di recupero documenti e credenziali del modello.
- Operazioni: log, monitoraggio, recapito degli avvisi, contatti per gli incidenti, gestione dei segreti e documentazione amministrativa.

Classifica le dipendenze in base alle conseguenze della loro indisponibilità
Non assegnare lo stesso obiettivo di resilienza a ogni dipendenza. Le linee guida NIST sulla supply chain supportano requisiti differenziati in base alla criticità, considerando l'impatto sulla missione o sul business, i dati elaborati e il prodotto o servizio fornito ([NIST SP 1305](https://nvlpubs.nist.gov/nistpubs/SpecialPublications/NIST.SP.1305.pdf)). Applica lo stesso ragionamento a ogni dipendenza nell'architettura della tua applicazione.
Una semplice classificazione in quattro parti impone una decisione sull'operatività degradata accettabile. Un servizio può comparire in più di una categoria per flussi di lavoro diversi; ad esempio, l'email può essere facoltativa per visualizzare record ma necessaria per il recupero della password o per una consegna con rilevanza legale.
- Necessaria per l'accesso: senza di essa, gli utenti ordinari non possono stabilire una sessione. Definisci separatamente un percorso sicuro di accesso di emergenza per gli amministratori.
- Necessaria per lavorare: senza di essa, una transazione essenziale non può essere completata correttamente. Gli esempi possono includere l'archivio dati primario o un'API esterna obbligatoria.
- Necessaria per funzionalità opzionali: gli utenti possono continuare il proprio lavoro principale, ma un'azione non essenziale non è disponibile o è ritardata.
- Necessaria per il ripristino: l'operatività quotidiana può continuare temporaneamente, ma il ripristino, il rinnovo dei certificati, la notifica di incidenti o il recupero dei dati dipendono da essa.
- Per ogni classificazione, definisci una finestra di interruzione accettabile, un arretrato massimo tollerabile, il fallback consentito e la persona autorizzata ad attivarlo.
Chiedi prove, non descrizioni rassicuranti
La documentazione del fornitore e un ambiente di test dovrebbero rispondere a domande operative a cui le pagine di marketing spesso non rispondono. Per ogni risposta, registra un link, un risultato di test, un riferimento di configurazione o un contatto di supporto. Quando la documentazione non specifica un comportamento, contrassegnalo come sconosciuto invece di presumere che esistano un tentativo automatico, una coda o un backup.
Verifica il confine preciso sottoposto a test. Traefik segnala che, quando i controlli di integrità sono abilitati e tutti i server di un servizio non sono in salute, può restituire HTTP 503. È una prova utile della disponibilità upstream al confine del reverse proxy, ma non dimostra che una transazione utente sia stata completata ([FAQ Traefik](https://doc.traefik.io/traefik/getting-started/faq/)).
L'automazione dei certificati merita una voce di dipendenza dedicata. La convalida HTTP-01 di Let's Encrypt richiede che l'autorità di certificazione recuperi un file di challenge dal server web, mentre DNS-01 richiede che interroghi un record TXT nel DNS. Il percorso pertinente, il controllo del DNS, l'ambito delle credenziali e il comportamento di propagazione dovrebbero quindi essere documentati prima che il rinnovo diventi urgente ([documentazione sulle challenge di Let's Encrypt](https://letsencrypt.org/docs/challenge-types/)).
- Quale operazione esatta dimostra che la dipendenza è utilizzabile, anziché semplicemente raggiungibile?
- Quali timeout, codici di errore, policy di retry, limiti di retry e comportamenti di backoff si applicano?
- Una richiesta può essere accettata ma completata in seguito e dove può essere verificato il suo stato finale?
- Gli eventi possono arrivare in ritardo, più di una volta o fuori ordine?
- L'applicazione mette in coda il lavoro durante un'interruzione? Quali sono il limite, la visibilità e il metodo di riconciliazione della coda?
- Quali credenziali sono necessarie per il ripristino, dove sono conservate e chi può usarle?
- Quali modifiche al DNS o alla rete possono impedire il rinnovo del certificato o l'accesso al dominio personalizzato?
- Esiste un ambiente non di produzione o un ambiente di staging del provider per una convalida sicura?
Esegui test di guasto controllati che somiglino agli incidenti di produzione
Un test di resilienza deve avere un ambito definito, una condizione di sicurezza, un'azione di rollback e un osservatore. Inizia in un ambiente non di produzione rappresentativo. Passa a esercitazioni di produzione limitate solo quando impatto, autorizzazione, monitoraggio e ripristino sono compresi. Non eseguire un esperimento che si prevede possa causare un guasto incontrollato del carico di lavoro.
Testa un flusso di lavoro business reale, non solo un controllo di connessione. Ad esempio, se il recapito email non è disponibile, testa l'invito a un account, il ripristino della password e l'azione che dipende dalla ricezione del messaggio da parte del destinatario. Registra separatamente se l'applicazione ha accettato la richiesta, se il provider email l'ha accettata e se il destinatario previsto può completare l'azione richiesta. Se un endpoint di modello non è disponibile, testa cosa vede l'utente, se i documenti sorgente restano protetti e se un'interazione incompleta viene registrata accuratamente.
Per la risoluzione dei problemi relativi ai certificati o lo sviluppo client, usa l'ambiente di staging di Let's Encrypt anziché causare ripetutamente autorizzazioni di produzione non riuscite. Let's Encrypt raccomanda lo staging per diagnosticare le condizioni di autorizzazione senza consumare i limiti di produzione ([documentazione sui limiti di frequenza di Let's Encrypt](https://letsencrypt.org/docs/rate-limits/)).
- Provider di identità non disponibile: prova l'accesso di un utente ordinario, il rinnovo della sessione, l'accesso dell'amministratore e il logout; verifica l'accesso di emergenza solo secondo i controlli documentati.
- Recapito email non riuscito: avvia l'invio di messaggi, esamina lo stato dell'applicazione e le prove di consegna, verifica il messaggio rivolto all'utente, quindi ripristina la consegna e riconcilia le azioni ritardate o non riuscite.
- API irraggiungibile: interrompi il percorso o nega la credenziale in un ambiente di test; controlla timeout, presentazione dell'errore, stato salvato e se l'azione possa essere ripetuta in sicurezza.
- Webhook ritardato: ritarda la consegna, poi rilascialo; testa la riconsegna, gli eventi duplicati e gli eventi fuori ordine nei casi in cui la documentazione del provider o dell'applicazione indichi tali comportamenti.
- Limite di frequenza esaurito: simula gli errori di quota dove possibile; verifica retry limitati, backoff e una chiara condizione di arresto.
- Endpoint di modello non disponibile: testa un timeout e una risposta di errore; determina se l'applicazione offre uno stato di indisponibilità chiaramente etichettato, rimanda il lavoro o deve bloccare il flusso di lavoro.
- Upstream non in salute: rendi indisponibili, in un ambiente di test, tutti i server dietro un servizio reverse proxy con controllo di integrità; verifica la gestione prevista del 503, gli avvisi e il ripristino.
Registra gli esiti che stabiliscono se un guasto è sicuro
Un test è incompleto quando l'unico risultato è “ha ritentato”. Un retry può seguire un'operazione dal cui esito incerto. Una risposta riuscita da un'applicazione o da un'API esterna può mostrare che è stato raggiunto un confine di elaborazione; non dimostra da sola ogni risultato business a valle. Definisci le prove di completamento richieste per ogni flusso di lavoro.
Registra ciò che sperimentano gli utenti e ciò che gli amministratori devono fare, ma determina anche se i dati sono corretti. Per ogni operazione ritardata o ritentata, stabilisci in base alla documentazione dell'applicazione e del provider pertinente se siano possibili consegna duplicata, riordinamento, completamento parziale o esiti incerti. Quando sono possibili, usa una progettazione sicura rispetto ai duplicati e mantieni un piano di riconciliazione.
Quando un'API documenta il supporto all'idempotenza, usa il meccanismo documentato per le richieste ripetibili di creazione o aggiornamento. Non presumere che tale meccanismo esista per un'API che non lo documenta.
- Impatto sugli utenti: attività esatta interessata, messaggio di errore, stato visibile e possibilità per gli utenti di continuare altro lavoro.
- Rischio per l'integrità dei dati: l'azione può andare persa, essere duplicata, salvata parzialmente, elaborata fuori ordine o lasciata in uno stato sconosciuto?
- Comportamento dei retry: trigger, timeout, pianificazione, backoff, numero massimo di tentativi e stato di errore finale.
- Comportamento della coda: dove viene trattenuto il lavoro, limite dell'arretrato, gestione dei duplicati, ipotesi sull'ordinamento, scadenza e metodo di riproduzione.
- Osservabilità: log, metriche, avvisi, ID di correlazione e prove usate per decidere che l'elaborazione è stata completata.
- Azioni dell'amministratore: contenimento immediato, passaggi di verifica, procedura di riconciliazione, contatto per l'escalation e regola per dichiarare completo il ripristino.
Progetta fallback pratici e sicuri
Un buon fallback preserva la sicurezza e rende espliciti i limiti. Non è semplicemente un modo per forzare il sistema ad andare avanti. Definisci cosa può continuare, cosa deve essere sospeso, chi può approvare un processo manuale, dove viene conservata la registrazione e come verrà riconciliato in seguito il lavoro differito.
L'accesso amministrativo di emergenza è un esempio fondamentale. Microsoft raccomanda account di emergenza progettati per scenari di interruzione del provider di identità federato, usando account solo cloud che non dipendono dalla federazione o dalla sincronizzazione on-premises. Le stesse linee guida sottolineano un'autenticazione forte diversa da quella dei normali account amministrativi, l'archiviazione sicura delle credenziali, la registrazione e il monitoraggio, nonché esercitazioni di convalida regolari ([linee guida Microsoft sull'accesso di emergenza](https://learn.microsoft.com/en-us/entra/identity/role-based-access-control/security-emergency-access)).
Per il lavoro rivolto ai clienti, una procedura manuale può essere più sicura dei retry automatici quando l'operazione può generare conseguenze finanziarie, legali o record duplicati. Un'opzione di lavoro differito è appropriata solo quando sono compresi la coda, lo stato finale e il processo di riconciliazione.
- Accesso locale di emergenza: accesso amministrativo strettamente controllato e autenticato separatamente per un'interruzione dell'identità; usalo solo secondo una procedura documentata e testata.
- Processo manuale: un'alternativa con durata limitata, come registrare le richieste in un sistema approvato per l'inserimento successivo, con un responsabile e un controllo di riconciliazione.
- Lavoro differito: metti in coda il lavoro idoneo finché una dipendenza non torna disponibile, tenendo traccia di arretrato, scadenza, elaborazione duplicata e stato dell'utente.
- Isolamento delle funzionalità: disabilita solo la funzione opzionale interessata preservando i flussi di lavoro essenziali sicuri.
- Comunicazioni chiare: indica cosa non è disponibile, cosa gli utenti dovrebbero fare invece, se il lavoro è stato salvato e quando verrà fornito il prossimo aggiornamento.
Evita soluzioni alternative che trasformano un'interruzione in un incidente di sicurezza o dei dati
Non rendere mai “disabilitare l'autenticazione” la risposta predefinita a un'interruzione dell'identità. Rimuove il controllo proprio quando gli amministratori hanno minore visibilità e maggiore pressione. Prepara invece un modello di accesso di emergenza limitato con credenziali distinte, uso ristretto, monitoraggio e test pianificati.
Allo stesso modo, non trattare i retry come prova che nulla sia andato perso o duplicato. I limiti di frequenza possono peggiorare i fallimenti ripetuti. Let's Encrypt applica limiti alle autorizzazioni non riuscite e raccomanda lo staging durante la risoluzione dei problemi ([documentazione sui limiti di frequenza di Let's Encrypt](https://letsencrypt.org/docs/rate-limits/)). Configura retry limitati e una condizione di arresto, quindi indaga o riconcilia il lavoro il cui esito rimane incerto.
Evita credenziali DNS con ambito non limitato per comodità nell'automazione dei certificati. Let's Encrypt avverte che collocare credenziali API DNS ampie su un server web aumenta l'impatto di una compromissione e suggerisce, ove possibile, credenziali con ambito ristretto o la convalida da un server separato ([documentazione sulle challenge di Let's Encrypt](https://letsencrypt.org/docs/challenge-types/)).
- Non aggirare i controlli di accesso senza una procedura di emergenza pre-autorizzata e registrata.
- Non riprodurre transazioni dall'esito sconosciuto finché non puoi determinare se l'originale è stata completata.
- Non presumere che la consegna dei webhook avvenga una sola volta o in ordine senza confermare il comportamento documentato.
- Non consentire a un ciclo di retry senza limiti di creare carico, costi o blocchi da parte del provider.
- Non concedere ampie autorizzazioni DNS solo per automatizzare una singola attività di convalida.
- Non chiudere un incidente basandoti solo sulla liveness del processo; verifica il risultato business interessato e riconcilia l'arretrato.
Domande frequenti
Che cos'è la pianificazione dei guasti delle dipendenze per applicazioni self-hosted?
È la pratica di identificare ogni servizio da cui dipende un'applicazione, classificare l'impatto business della perdita di ciascuno, testare modalità di guasto realistiche e documentare azioni sicure di fallback e ripristino prima che si verifichi un incidente.
Ogni dipendenza dovrebbe avere lo stesso obiettivo di ripristino?
No. Definisci i requisiti in base alla criticità: impatto business, dati elaborati e servizio fornito. Una dipendenza necessaria per l'accesso o per le transazioni essenziali richiede in genere un piano diverso da una utilizzata soltanto per una funzionalità opzionale.
Perché un controllo di integrità riuscito non è sufficiente?
Un controllo di integrità di norma dimostra una condizione ristretta e definita, come la liveness di un processo o la disponibilità upstream. Potrebbe non dimostrare che gli utenti possano completare un accesso, inviare un'email, elaborare un pagamento, recuperare un file o ricevere una risposta AI.
Come dovremmo testare la resilienza dei webhook?
Testa consegna non riuscita, consegna ritardata, riconsegna, duplicati ed eventi fuori ordine quando tali comportamenti sono rilevanti per il provider o l'applicazione. Verifica che l'elaborazione sia sicura rispetto ai duplicati dove necessario e che il team possa riconciliare gli eventi dopo il ripristino.
Come dovrebbe essere un fallback per l'interruzione di un provider di identità?
Usa un percorso pianificato e strettamente protetto di accesso amministrativo di emergenza che non dipenda dal percorso di federazione guasto. Proteggi le credenziali, usa un'autenticazione forte distinta, registra l'utilizzo, monitora l'attività e convalida regolarmente la procedura. Non disabilitare ampiamente i controlli di accesso.
In che modo l'hosting gestito aiuta e cosa resta in capo al proprietario dell'applicazione?
Per le applicazioni supportate, Airbip gestisce l'infrastruttura cloud attorno alle istanze di applicazioni self-hosted, inclusi i carichi di lavoro Docker sui server cloud Airbip, il routing e l'automazione dei certificati TLS tramite Traefik e Let's Encrypt, i controlli DNS, la gestione del ciclo di vita dei servizi e backup giornalieri, settimanali e mensili configurabili. Questo può ridurre le dipendenze infrastrutturali che un team gestisce direttamente. Il proprietario dell'applicazione deve comunque prendere e testare decisioni su integrazioni applicative, identità e accesso, gestione dei dati, processi business, fornitori esterni e procedure di continuità.
Fonti e approfondimenti
- Control startup and shutdown order in Compose — Docker
- Define services in Docker Compose — Docker
- Traefik Health Check Documentation — Traefik Labs
- Traefik Getting Started FAQ — Traefik Labs
- Challenge Types — Let's Encrypt / Internet Security Research Group
- Rate Limits — Let's Encrypt / Internet Security Research Group
- The NIST Cybersecurity Framework (CSF) 2.0 — NIST
- NIST CSF 2.0: Quick-Start Guide for Cybersecurity Supply Chain Risk Management — NIST
- OWASP Application Security Verification Standard — OWASP Foundation
- Manage emergency access admin accounts — Microsoft