L’IA self-hosted non è automaticamente privata: una checklist dei flussi di dati
Ospitare autonomamente un’applicazione di IA non dimostra che prompt, file, log o backup restino sulla tua infrastruttura. Traccia ogni flusso di dati e verifica ogni destinazione prima di usare informazioni sensibili.
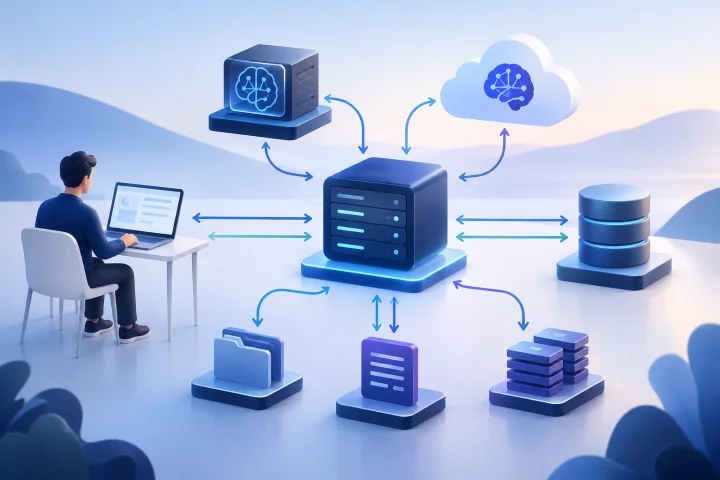
Self-hosted descrive una scelta di distribuzione, non una garanzia di privacy completa
Un’applicazione di IA self-hosted viene eseguita su un’infrastruttura predisposta da te o da un provider di hosting. Questo, da solo, non indica dove avviene l’inferenza, quali servizi ricevono i dati, che cosa viene conservato o chi può accedere alle copie operative.
Considera l’applicazione e l’endpoint del modello come componenti distinti del sistema. L’introduzione alle API di Ollama, disponibile all’indirizzo https://github.com/ollama/ollama/blob/main/docs/api/introduction.mdx, descrive sia un indirizzo API locale sia un URL di base per le API cloud. Anche la documentazione di autenticazione, disponibile all’indirizzo https://github.com/ollama/ollama/blob/main/docs/api/authentication.mdx, spiega che le richieste ai modelli cloud possono essere effettuate tramite la sua API locale. Il fatto che una richiesta venga inviata a un’interfaccia locale non dimostra, di per sé, che l’elaborazione del modello avvenga localmente.
La domanda giusta non è semplicemente «È self-hosted?». Chiediti invece: «Per questo flusso di lavoro e questi tipi di dati, quali sistemi elaborano o archiviano le informazioni, a quali condizioni e come possiamo verificarlo?»
- Hosting dell’applicazione: dove vengono eseguite l’interfaccia utente e i servizi di supporto.
- Hosting del modello: dove avviene l’inferenza e quale endpoint riceve le richieste.
- Gestione dei dati: che cosa viene archiviato, registrato nei log, sottoposto a backup, trasmesso o reso accessibile agli operatori e ai servizi collegati.

Disegna il flusso completo dei dati prima della distribuzione
Mappa il flusso di lavoro reale, dalla persona che usa il sistema a ogni componente che potrebbe gestire informazioni. Includi l’applicazione di IA, l’endpoint del modello, il database, l’archivio di file, il reverse proxy, gli strumenti collegati, i servizi di analisi o monitoraggio e la destinazione dei backup. Ove pertinente, aggiungi i percorsi di accesso delle persone, come amministrazione, assistenza e gestione degli incidenti.
Indica per ogni connessione se è interna alla distribuzione o esterna e annota chi gestisce ciascuna destinazione. «Locale» dovrebbe significare locale alla macchina o all’ambiente interessato, non semplicemente «raggiungibile tramite un’interfaccia che sembra locale». Verifica l’endpoint configurato e il modello o servizio che richiama effettivamente.
Ripeti l’analisi per ogni funzione che intendi utilizzare. Chat, ricerca nei documenti, caricamento di file, recupero di informazioni e integrazioni possono seguire percorsi diversi. Non dare per scontato che una funzione gestisca i dati come una chat ordinaria.
- Disegna le frecce per richieste, risposte, sincronizzazione, registrazione nei log e backup.
- Etichetta ogni destinazione indicando operatore, ambiente e finalità.
- Annota quali connessioni sono facoltative e se disattivarle modifica il flusso di lavoro.
- Confronta la configurazione e il comportamento della rete con la documentazione aggiornata del prodotto; non considerare un’etichetta del prodotto o un’impostazione predefinita come prova.

Fai l’inventario dei dati, non soltanto dei documenti
Elenca le informazioni che entrano nel flusso di lavoro, ne derivano o vengono generate al suo interno. Il caricamento di un documento può produrre testo estratto, blocchi di testo, embedding, risultati di ricerca, prompt contenenti passaggi recuperati e risposte generate. La presenza di ciascun elemento dipende dall’applicazione e dalla configurazione: verifica, anziché presumere.
Includi anche i normali metadati operativi. Un servizio può registrare date e orari, identificativi degli account, percorsi delle richieste, dettagli degli errori, modello selezionato o informazioni sull’utilizzo. I log possono contenere più dati di quanto i team si aspettino, se richieste o errori includono valori sensibili.
Per ogni tipo di dato, descrivi il livello di sensibilità, la finalità, la destinazione e se il flusso di lavoro ne ha davvero bisogno.
- Input: prompt, testo incollato, file caricati, immagini e informazioni recuperate da fonti collegate.
- Dati derivati: testo estratto, blocchi di testo, embedding, indici, contenuti memorizzati nella cache e riepiloghi, se il sistema li crea.
- Output: risposte generate, citazioni o passaggi recuperati e file creati dall’applicazione.
- Dati operativi: log dell’applicazione, log di accesso del proxy, dati analitici, rapporti sugli errori, metadati di utilizzo e registrazioni amministrative.
- Copie: contenuti dei database, volumi di file, snapshot, esportazioni e backup.
Verifica le condizioni di trattamento e conservazione di ogni destinazione
Per ogni servizio presente nella mappa, consulta la documentazione primaria aggiornata e l’accordo applicabile. Annota quali dati riceve, dove avviene il trattamento, quali regioni o subresponsabili possono essere coinvolti, per quanto tempo vengono conservate le informazioni, chi può accedervi, come funziona la cancellazione e se i dati possono essere usati per altri scopi.
Non considerare una dichiarazione generale del provider una risposta completa per ogni funzione. La documentazione della piattaforma OpenAI, ad esempio, disponibile all’indirizzo https://platform.openai.com/docs/models/default-usage-policies-by-endpoint, distingue i log di monitoraggio degli abusi dallo stato dell’applicazione e presenta informazioni e controlli sulla conservazione in base all’endpoint. Esamina l’endpoint e la funzione esatti utilizzati dalla tua applicazione.
Se i dati personali sono soggetti al GDPR, gli aspetti pertinenti includono minimizzazione dei dati, limitazione della conservazione, sicurezza, destinatari e trasferimenti. Le indicazioni della Commissione europea sui principi del GDPR, disponibili all’indirizzo https://commission.europa.eu/law/law-topic/data-protection/information-business-and-organisations/principles-gdpr_en, trattano questi principi e le informazioni da fornire in modo trasparente. Se un provider tratta dati personali per conto di un titolare del trattamento, verifica il contratto applicabile con il responsabile e il relativo ambito, comprese le condizioni per ricorrere a un altro responsabile ai sensi dell’articolo 28 del GDPR, disponibile all’indirizzo https://eur-lex.europa.eu/eli/reg/2016/679/oj/. Questa è una checklist operativa, non sostituisce la consulenza legale.
- Trattamento: quali dati vengono inviati, per quale funzione e in quale regione o ambiente?
- Conservazione e cancellazione: che cosa persiste, per quanto tempo e che cosa accade a backup o dati derivati dopo la cancellazione?
- Accesso e riutilizzo: chi può accedere ai dati e vengono usati per addestramento, miglioramento del servizio, monitoraggio degli abusi o altri scopi?
- Contratto e subresponsabili: quali condizioni si applicano al tuo account e al tuo caso d’uso, e come sono disciplinati gli altri responsabili?
- Prove: conserva la versione della documentazione o dell’accordo esaminata, la data e le domande ancora senza risposta.
Includi log, backup e altre copie operative
Un prompt può non essere presente nel database principale della chat e comparire comunque altrove. Controlla i log dell’applicazione, i log di accesso del reverse proxy, i dati analitici, i rapporti sugli errori, i flussi di assistenza, le esportazioni del database, l’archiviazione persistente dei file e i backup. Individua sia le copie automatiche sia quelle che le persone possono creare durante la risoluzione dei problemi.
La documentazione di Docker descrive i volumi come archivi di dati persistenti e fornisce procedure per eseguirne il backup e ripristinarli: https://docs.docker.com/engine/storage/volumes/. La documentazione dei driver di logging, all’indirizzo https://docs.docker.com/engine/logging/configure/, descrive driver in grado di inviare i log dei container a destinazioni locali o esterne. La documentazione dei log di accesso di Traefik, disponibile all’indirizzo https://doc.traefik.io/traefik/observe/logs-and-access-logs/, descrive campi e intestazioni delle richieste configurabili, comprese le opzioni per conservarli, escluderli o oscurarli. Esamina la configurazione effettiva: non dare per scontato che i log siano innocui o locali.
Per i backup, definisci che cosa includono, dove vengono conservati, chi può accedervi, per quanto tempo restano disponibili e come vengono gestite le richieste di cancellazione. Conferma questi dettagli per il servizio e il piano che utilizzi realmente.
- Esamina la configurazione di logging per individuare corpi delle richieste, intestazioni, parametri di query, dettagli degli errori e destinazioni esterne dei log.
- Verifica se i volumi persistenti contengono caricamenti, indici, cronologia delle chat o altri dati di stato dell’applicazione.
- Documenta l’ambito dei backup, la destinazione, gli accessi, la pianificazione, la conservazione, il processo di ripristino e il comportamento in caso di cancellazione.
- Esamina i percorsi di accesso per assistenza e amministrazione, compreso il modo in cui l’accesso viene concesso e revocato.
Verifica il flusso di lavoro reale con dati rappresentativi
La documentazione descrive il comportamento previsto; un test controllato aiuta a stabilire che cosa fa davvero la configurazione distribuita. Usa contenuti sintetici o approvati, non dati sensibili dei clienti, finché non hai compreso il flusso dei dati e le relative condizioni.
Invia una frase di test distintiva tramite ogni flusso di lavoro e controlla le destinazioni che puoi ispezionare: registrazioni dell’applicazione, archiviazione persistente, log configurati, log del proxy, servizi collegati e impostazioni dell’endpoint del modello. Se non puoi ispezionare direttamente una destinazione, chiedi prove o chiarimenti al suo operatore. Verifica anche la cancellazione e distingui la rimozione dall’applicazione attiva dalla scadenza dei backup o di altre copie conservate.
HTTPS protegge il traffico da alcuni rischi durante il transito, come spiegato all’indirizzo https://letsencrypt.org/docs/why-all-https/, ma non stabilisce che cosa succede dopo che un servizio riceve i dati. Considera la sicurezza del trasporto, il luogo del trattamento, la conservazione e l’accesso come verifiche distinte.
- Esegui un test per ogni funzione: chat, caricamento di file, recupero di documenti, integrazioni ed eventuali percorsi di esportazione o condivisione.
- Verifica l’endpoint del modello effettivo e la configurazione: un indirizzo API locale, da solo, non dimostra che l’inferenza avvenga localmente.
- Cerca la frase o il file di test nei sistemi che amministri e annota le destinazioni che non puoi ispezionare.
- Verifica il comportamento di cancellazione e recupero, compresa l’eventuale permanenza dei dati nei backup o nei servizi esterni.
- Ripeti il controllo dopo modifiche sostanziali alla configurazione o quando cambiano le condizioni di un provider.
Trasforma le incertezze in decisioni e regole operative
Alcune domande potrebbero restare aperte, perché la documentazione pubblica di un provider potrebbe non coprire il tuo account, endpoint o contratto specifico. Registra queste lacune, invece di trasformare un’ipotesi in un’affermazione sulla privacy. Assegna un responsabile e una scadenza e stabilisci quali dati possono essere usati mentre la questione è irrisolta.
Definisci regole coerenti con le prove disponibili: quali informazioni sono consentite, quali devono essere rimosse o mascherate, quali flussi di lavoro sono vietati e chi può approvare le eccezioni. Le regole devono essere utilizzabili dalle persone che inseriscono le informazioni, non soltanto dal team che ha distribuito il sistema.
Per i dati personali, allinea la finalità documentata, la minimizzazione dei dati, la conservazione, la sicurezza, i destinatari e i trasferimenti agli obblighi applicabili alla tua organizzazione. Conserva un registro dei sistemi e delle condizioni esaminati, così da poter valutare eventuali modifiche in seguito.
- Assegna a ogni flusso uno stato semplice: verificato, consentito a determinate condizioni, bloccato o ancora in fase di valutazione.
- Assegna responsabili per la configurazione degli endpoint, le condizioni dei fornitori, i log, i backup, gli accessi e le istruzioni per gli utenti.
- Definisci una regola chiara per i dati sensibili finché restano senza risposta domande sostanziali.
- Aggiorna la mappa quando aggiungi un provider di modelli, un’integrazione, una nuova fonte di dati, una destinazione dei log o un percorso di backup.
Scegli il modello di distribuzione che soddisfa requisiti verificati
Ospitare autonomamente l’applicazione può offrire controllo sul suo ambiente, ma non garantisce che ogni chiamata al modello o copia operativa resti al suo interno. Un servizio di modelli gestito esternamente può essere adatto se le condizioni specifiche dell’endpoint, il trattamento, la conservazione e il contratto sono compatibili con i tuoi obblighi. L’inferenza gestita localmente può essere indicata per requisiti che richiedono l’elaborazione locale del modello, ma verifica il percorso delle richieste e l’archiviazione, i log e gli accessi circostanti.
Confronta i modelli sulla base delle prove, non delle etichette. Se un requisito stabilisce che i dati non devono uscire da un determinato ambiente, definisci quali componenti rientrano in quel perimetro e testa il flusso di lavoro configurato. Se non puoi verificare una condizione richiesta, non instradare i dati interessati attraverso il sistema finché non hai ottenuto una risposta adeguata o approvato un’alternativa.
Airbip offre la distribuzione gestita delle applicazioni presenti nel proprio catalogo pubblico, con istanze applicative eseguite come workload Docker sui server cloud di Airbip. Automatizza il routing e i certificati TLS tramite Traefik e Let’s Encrypt e offre backup giornalieri, settimanali e mensili configurabili. Queste funzionalità possono agevolare la gestione dell’infrastruttura applicativa e del ciclo di vita, ma non stabiliscono di per sé dove un modello esterno elabora i dati, quali siano le condizioni di conservazione di un servizio collegato o come venga trattata ogni copia di backup. Per i dettagli pertinenti alla tua distribuzione, consulta le informazioni aggiornate sui prodotti Airbip e le condizioni applicabili.
- Scegli l’hosting dell’applicazione in base a chi dovrebbe gestire l’infrastruttura e a quali responsabilità amministrative puoi sostenere.
- Scegli un endpoint del modello sulla base di requisiti verificati relativi a trattamento, conservazione, accesso, cancellazione e contratto.
- Scegli l’inferenza locale soltanto dopo aver verificato il percorso del modello e aver considerato archiviazione locale, log, backup e accessi amministrativi.
- Se non è possibile dimostrare il perimetro richiesto per i dati, tieni quei dati fuori dal flusso di lavoro oppure scegli un altro modello di distribuzione.
Domande frequenti
Ospitare autonomamente un’applicazione di IA significa che i prompt restano sul mio server?
Non necessariamente. L’applicazione potrebbe inviare i prompt a un endpoint del modello separato. Controlla il percorso configurato e la documentazione aggiornata per il modello e la funzione specifici.
Che cosa dovrei controllare oltre ai prompt e ai file caricati?
Fai l’inventario dei dati derivati, come testo estratto ed embedding, se vengono creati, delle risposte generate, dei log, dei dati analitici, dei rapporti sugli errori, dell’archiviazione persistente, delle esportazioni e dei backup. L’elenco esatto dipende dall’applicazione e dalla configurazione.
HTTPS dimostra che i dati sono privati?
No. HTTPS protegge il traffico da alcuni rischi durante il transito. Non stabilisce dove avviene il trattamento di un servizio, quali siano le sue pratiche di accesso e le condizioni di conservazione, cancellazione o riutilizzo.
Che cosa devo fare se la documentazione di un fornitore non risponde a una domanda importante?
Registra la lacuna, chiedi al fornitore la documentazione applicabile o un chiarimento contrattuale ed evita di inviare dati che dipendono da quella risposta finché la questione non è risolta. Nel frattempo, usa un insieme di dati di test a rischio inferiore.
Fonti e approfondimenti
- Volumes: Back up, restore, or migrate data volumes — Docker
- Configure logging drivers — Docker
- Logs and Access Logs — Traefik Labs
- Data controls in the OpenAI platform — OpenAI
- Principles of personal data processing under the GDPR — European Commission
- Regulation (EU) 2016/679, Article 28 — EUR-Lex
- Ollama API introduction — Ollama
- Ollama API authentication — Ollama
- Why All Websites Should Use HTTPS — Internet Security Research Group (Let's Encrypt)