Come definire un budget di connessioni al database per un’applicazione self-hosted
Stima quante connessioni potrebbe aprire la tua applicazione, confronta la capacità con il limite del database e verifica il budget con carichi di lavoro realistici.
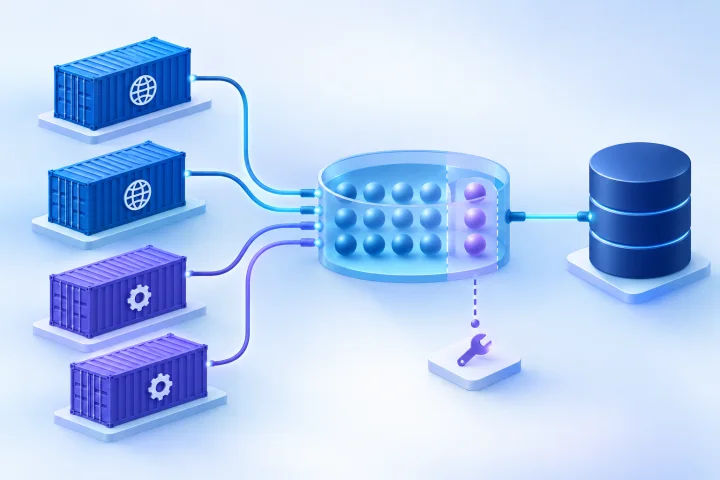
Perché serve un budget di connessioni al database
Un budget di connessioni al database stima quante connessioni simultanee potrebbe richiedere una distribuzione dell’applicazione, oltre alla capacità che vuoi lasciare disponibile per la manutenzione e per esigenze impreviste. Aiuta a evitare l’esaurimento delle connessioni senza considerare il limite del database come un obiettivo da raggiungere.
Aggiungere container applicativi può aumentare il numero potenziale di connessioni anche se il codice e il traffico per container rimangono invariati. La [Compose Deploy Specification di Docker](https://docs.docker.com/reference/compose-file/deploy/) definisce le repliche come il numero di container destinati a essere eseguiti per un servizio replicato; se ogni replica ha i propri pool di connessioni, ciascuna aggiunge capacità potenziale.
La capacità configurata non coincide con l’utilizzo effettivo: un pool può essere in grado di aprire un certo numero di connessioni senza aprirle tutte contemporaneamente. Una connessione inattiva tra una query e l’altra può comunque rimanere aperta e rientrare nel conteggio del limite del database. L’infrastruttura gestita non elimina la necessità di capire come si comporta il pool dell’applicazione e qual è il limite del database.
- Considera la capacità configurata del pool come un limite massimo che l’applicazione potrebbe raggiungere, non come una previsione del numero abituale di connessioni.
- Il numero di connessioni aperte osservato è una misurazione in un dato momento, non la prova che tutte stiano eseguendo query attivamente.
- Definisci un budget distinto per ogni database se i componenti dell’applicazione si collegano a più database.

Censire tutte le fonti di connessione
Inizia elencando ogni processo o strumento che può collegarsi al database. Non considerare soltanto l’applicazione accessibile dal web: anche le attività in background e quelle operative possono avere pool di connessioni propri o collegamenti diretti.
Per ogni fonte, registra quante istanze possono essere eseguite contemporaneamente, quanti processi o pool può creare ogni istanza e qual è la capacità configurata del pool. Controlla la configurazione della distribuzione e la documentazione ufficiale dell’applicazione, invece di presumere che le impostazioni predefinite di un framework valgano per la tua versione o configurazione.
- Container dell’applicazione web, compreso il numero massimo di repliche che potresti distribuire.
- Container dei worker e numero di processi worker o istanze di pool in ciascuno.
- Scheduler, processi ricorrenti e altri servizi che si collegano direttamente al database.
- Migrazioni, processi di distribuzione, monitoraggio, reportistica, strumenti collegati ai backup e sessioni amministrative.
- Eventuale sovrapposizione temporanea durante i rilasci o il ripristino, se le istanze vecchie e nuove possono essere attive contemporaneamente.

Stimare la domanda potenziale senza confonderla con l’utilizzo effettivo
Per una prima stima, calcola la capacità massima configurata di ciascun gruppo di pool di connessioni, quindi somma i gruppi che si collegano allo stesso database. Una formula utile è: capacità potenziale dei pool = numero di istanze in esecuzione × pool per istanza × numero massimo di connessioni per pool. Aggiungi la capacità dei worker separati e degli altri servizi, quindi considera le connessioni dirette che non usano quei pool.
Usa il numero effettivo di istanze dei pool, non un numero presunto di container applicativi. Per esempio, un’applicazione potrebbe creare un pool per processo: in tal caso, più processi web in ciascun container moltiplicano la capacità del container. Se un motore o un pool è condiviso tra processi, segui il comportamento documentato dell’applicazione, senza moltiplicarlo due volte.
Ecco un calcolo ipotetico, non una configurazione consigliata: tre repliche, ognuna con quattro processi e una dimensione massima del pool pari a cinque connessioni per processo, hanno una capacità potenziale di 60 connessioni per i pool web. Se un servizio worker separato ha due repliche con un pool da quattro connessioni ciascuna, aggiungine otto, per un totale potenziale di 68 prima di considerare migrazioni, monitoraggio o accesso amministrativo.
Quel totale è un limite massimo configurato in base alle ipotesi indicate, non una previsione dell’utilizzo abituale. Oltre a calcolare il limite, misura i conteggi effettivi sotto carico.
- Annota ogni valore e la relativa fonte: repliche, processi per istanza, istanze dei pool e limiti per pool.
- Considera il numero massimo di istanze raggiungibile durante il normale ridimensionamento o un rilascio, non soltanto il numero in esecuzione oggi.
- Non sommare al totale di un singolo database le capacità dei componenti che si collegano a server di database diversi.
- Nei casi documentati di QueuePool di SQLAlchemy, il numero massimo di connessioni utilizzabili da un Engine è pool_size più max_overflow. Prima di applicare questo calcolo, verifica che la tua applicazione utilizzi quel pool e quelle impostazioni; consulta la [documentazione di SQLAlchemy sui limiti dei pool](https://docs.sqlalchemy.org/en/20/errors.html).
Confrontare la stima con il limite del database
Confronta la somma della domanda potenziale dell’applicazione con il limite documentato delle connessioni simultanee del database. Non pianificare di occupare tutti gli slot disponibili. Lascia spazio per manutenzione, migrazioni, monitoraggio, diagnosi amministrativa e aumenti di breve durata della domanda. Scegli la capacità di riserva in base alle tue esigenze operative e ai picchi osservati: non esiste una percentuale universalmente sicura.
Tieni conto di come il database definisce gli slot utilizzabili. La [documentazione di PostgreSQL su connessioni e autenticazione](https://www.postgresql.org/docs/17/runtime-config-connection.html) descrive max_connections come il numero massimo di connessioni simultanee e segnala che aumentarlo incrementa anche l’allocazione di determinate risorse, tra cui la memoria condivisa. PostgreSQL può riservare slot per ruoli con privilegi adeguati, quindi non tutti gli slot sono necessariamente disponibili per le normali connessioni dell’applicazione.
La [documentazione di MySQL sulle connessioni](https://dev.mysql.com/doc/refman/8.0/en/connection-interfaces.html) descrive max_connections come il numero massimo di client simultanei consentiti. Documenta inoltre una connessione aggiuntiva per un account con il privilegio CONNECTION_ADMIN o con il privilegio SUPER, deprecato, utile per la diagnosi. Considerala una disponibilità amministrativa descritta da MySQL, non capacità ordinaria per l’applicazione.
Se la stima si avvicina al limite utilizzabile o lo supera, controlla innanzitutto il numero di repliche, i processi, le dimensioni dei pool e le fonti di connessione non necessarie. Aumentare il limite del database non è automaticamente la soluzione giusta: potrebbe consumare più risorse e non correggere un pool sovradimensionato o una perdita di connessioni.
- Registra il limite configurato del database e gli eventuali slot riservati o privilegiati pertinenti.
- Sottrai la riserva operativa prima di stabilire quanta capacità resta per i pool dell’applicazione.
- Consulta la documentazione del produttore del database per il database e la configurazione che utilizzi davvero.
- Se modifichi il limite, valuta le conseguenze sulle risorse del database e verifica la nuova impostazione, senza presumere che un valore più alto sia innocuo.
Verificare il funzionamento del pooling a entrambi i livelli
Un pool dell’applicazione e un limite di connessioni del database controllano aspetti diversi. Il pool dell’applicazione stabilisce quante connessioni può creare e cosa succede quando sono tutte occupate. Il limite del database stabilisce quanti client il database accetta contemporaneamente. Se un pool consente più connessioni di quante il database possa gestire, il problema può spostarsi dall’applicazione al database.
Nei casi documentati di QueuePool di SQLAlchemy, le richieste aggiuntive attendono quando la capacità configurata è esaurita e possono andare in timeout. La [documentazione di SQLAlchemy](https://docs.sqlalchemy.org/en/20/errors.html) avverte inoltre che un overflow illimitato può portare la domanda fino al limite di connessioni del database. Considera i timeout del pool un motivo per indagare sulla domanda e sul comportamento del pool, non un’indicazione automatica ad aumentare le dimensioni del pool.
Se il progetto prevede PgBouncer, distingui le connessioni client da quelle server. La sua [documentazione di configurazione](https://www.pgbouncer.org/config) descrive limiti separati per le connessioni client e server per ciascun database; la differenza può rappresentare client in attesa di connessioni server attive. Anche la modalità del pool influisce sul momento in cui una connessione server diventa riutilizzabile: in modalità sessione, quando il client si disconnette; in modalità transazione, al termine di una transazione. Verifica la modalità configurata e la compatibilità dell’applicazione nella documentazione.
Non presumere che il pooling avvenga solo perché l’applicazione o la distribuzione usa container. Individua quale componente gestisce ciascun pool, se il pool è per processo e se tra l’applicazione e il database è presente un proxy.
- Consulta la documentazione ufficiale dell’applicazione o del framework per il pool nella configurazione distribuita.
- Verifica il significato delle impostazioni di dimensione del pool, overflow, durata di inattività e timeout, se disponibili.
- Se usi un proxy per il database, definisci separatamente il budget delle connessioni lato client e lato database.
- Verifica cosa succede a una connessione al termine di una richiesta, di un’attività o di una transazione.
Verificare il budget con concorrenza rappresentativa
Una stima teorica è un punto di partenza. Metti alla prova l’applicazione con richieste concorrenti e processi in background rappresentativi, includendo gli schemi di carico rilevanti per il tuo team. Osserva il numero di connessioni insieme alle code e agli errori dell’applicazione, quindi confronta il picco con la stima e con la capacità riservata.
Per PostgreSQL, [pg_stat_activity](https://www.postgresql.org/docs/16/monitoring-stats.html) fornisce una riga per ogni processo server e include campi come application_name, user, indirizzo client, stato e query corrente. Questi campi possono aiutare a identificare le fonti delle connessioni e a distinguere l’attività osservata. Per gli altri motori, usa strumenti di monitoraggio appropriati: nella sua [documentazione sulle connessioni](https://dev.mysql.com/doc/refman/8.0/en/connection-interfaces.html), MySQL descrive Connection_errors_max_connections come un contatore che aumenta quando una connessione viene rifiutata perché è stato raggiunto max_connections.
Non testare soltanto il normale percorso web. Includi uno scenario di distribuzione o migrazione se può sovrapporsi al traffico attivo e considera l’attività dei worker se condividono il database. Lo scopo è verificare se la domanda rientra nel budget previsto e se l’applicazione accoda le richieste o si blocca prima che il limite del database venga esaurito.
- Registra il picco di connessioni aperte e, se disponibili, lo stato delle connessioni e l’identità della fonte.
- Monitora le attese nei pool dell’applicazione, i timeout dovuti ai limiti dei pool, i rifiuti delle connessioni e i contatori dei limiti lato database.
- Confronta il picco osservato sia con la capacità potenziale calcolata sia con la riserva operativa.
- Ripeti la verifica dopo aver modificato il numero di repliche, la concorrenza dei worker, le impostazioni dei pool o la configurazione del database.
Indagare sui segnali di allarme prima di aumentare i limiti
Un timeout del pool può indicare che tutte le connessioni configurate sono occupate, mentre un rifiuto del database può indicare che è stato raggiunto il limite del server. Nessuno dei due sintomi, da solo, identifica la causa principale. Controlla se la domanda è aumentata, se i processi richiedono più tempo, se le connessioni rimangono occupate più del previsto o se un componente ha aperto più istanze di pool di quante ne prevedesse il budget.
Controlla anche le connessioni inattive che restano aperte, oltre alle query attive. La [documentazione di SQLAlchemy](https://docs.sqlalchemy.org/en/20/errors.html) segnala che una connessione rilasciata può restare collegata nel pool per essere riutilizzata: le connessioni aperte, quindi, non indicano necessariamente una query in esecuzione. Su PostgreSQL, usa i campi identificativi e relativi all’attività di pg_stat_activity per risalire all’origine delle connessioni.
- Timeout del pool: verifica la capacità del pool e controlla la presenza di una domanda sostenuta o di connessioni trattenute troppo a lungo.
- Rifiuti di connessione del database: verifica il limite del server, la capacità riservata e quali fonti applicative si stanno collegando.
- Numero di connessioni aperte inaspettatamente elevato: determina se si tratta di connessioni inattive nei pool, attività in corso, pool duplicati o una perdita di connessioni.
- Cambiamenti improvvisi dopo una distribuzione: confronta le impostazioni di repliche, processi, worker e pool con il budget precedente.
Documentare il budget e i fattori che ne richiedono una revisione
Conserva il calcolo insieme alla configurazione di distribuzione o alla documentazione operativa. Un budget utile è riproducibile: un altro operatore può capire quali processi sono stati conteggiati, quali impostazioni sono state usate, quale capacità è stata riservata e come è stata verificata la stima.
Considera il budget un elemento da riesaminare quando il sistema cambia, non un numero da definire una volta sola. Airbip esegue le istanze applicative come carichi di lavoro Docker sui server cloud Airbip e offre una distribuzione gestita e la gestione del ciclo di vita dei servizi. Queste funzionalità infrastrutturali non determinano il comportamento dei pool di ciascuna applicazione e non sostituiscono la necessità di rivederne il budget di connessioni al database. Anche quando le attività infrastrutturali sono gestite, i team restano responsabili di comprendere le scelte relative all’applicazione e all’accesso ai dati.
- Documenta il limite del database, gli slot riservati, le impostazioni dei pool dell’applicazione e la fonte di ciascuna impostazione.
- Elenca il numero massimo di repliche, i processi per istanza, la concorrenza dei worker e le altre fonti di connessione.
- Registra il calcolo, la riserva operativa, il picco osservato, le condizioni dei test e le ipotesi note.
- Assegna un responsabile e rivedi il budget dopo modifiche alla scalabilità, all’applicazione o al database, crescita del carico di lavoro o aggiornamenti del piano di ripristino.
- Includi migrazioni e accesso amministrativo nelle procedure di distribuzione e ripristino, affinché non competano in modo imprevisto con la domanda dell’applicazione.
Domande frequenti
La dimensione del pool corrisponde al numero di connessioni al database che l’applicazione sta usando?
No. La dimensione del pool è la capacità configurata e non necessariamente il numero di connessioni aperte o di query in esecuzione in un dato momento. I pool possono crescere quando serve e le connessioni possono rimanere aperte mentre sono inattive, così da poter essere riutilizzate. Misura le connessioni osservate oltre a calcolare il limite massimo configurato.
Come stimo le connessioni quando eseguo più container applicativi?
Conta le istanze dei pool in ciascun container e moltiplica la loro capacità massima per il numero di istanze che possono essere eseguite contemporaneamente. Se ogni processo ha un pool separato, considera anche il numero di processi. Aggiungi i worker e le altre fonti di connessione diretta che usano lo stesso database.
Devo aumentare il limite di connessioni del database quando queste si esauriscono?
Non automaticamente. Prima identifica quali client si stanno collegando, se la capacità configurata dei pool è superiore al necessario, se le connessioni vengono trattenute o perse e se la concorrenza del carico è cambiata. Aumentare il valore max_connections di PostgreSQL incrementa anche l’allocazione di determinate risorse, tra cui la memoria condivisa: consulta quindi la [documentazione di PostgreSQL](https://www.postgresql.org/docs/17/runtime-config-connection.html) e verifica l’impatto.
Per quali attività dovrei riservare connessioni al database?
Lascia capacità per le attività operative necessarie alla tua distribuzione, come manutenzione, migrazioni, monitoraggio, amministrazione e domanda imprevista. La quantità dipende dal sistema e dal carico osservato: non presumere che esista una riserva universalmente sicura.
Se uso PgBouncer, posso ignorare le impostazioni dei pool dell’applicazione?
No. PgBouncer distingue i limiti delle connessioni client da quelli delle connessioni server, e la modalità del pool influisce sul momento in cui le connessioni server possono essere riutilizzate. Definisci il budget per entrambi i livelli e verifica la modalità configurata e il comportamento dell’applicazione nella [documentazione ufficiale di PgBouncer](https://www.pgbouncer.org/config).
Fonti e approfondimenti
- PostgreSQL: Connections and Authentication — PostgreSQL Global Development Group
- PostgreSQL: The Cumulative Statistics System — PostgreSQL Global Development Group
- SQLAlchemy: Error Messages — Connection Pool Limits — SQLAlchemy
- PgBouncer Configuration — PgBouncer
- Compose Deploy Specification — Docker
- MySQL: Connection Interfaces — Oracle