Un server o due? Domande per valutare dove collocare un’applicazione IA e il servizio di inferenza
Una guida pratica, non una raccomandazione universale: confronta servizi sullo stesso server e su server separati mappando componenti, flussi di dati e responsabilità operative.
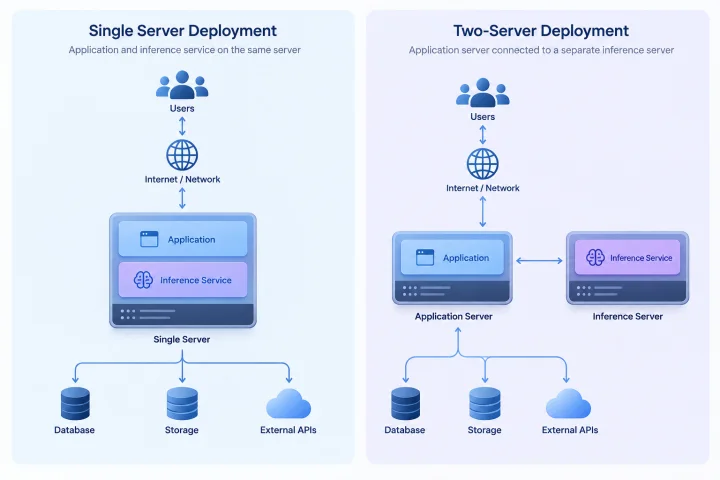
Una guida di valutazione, non una raccomandazione universale
In una configurazione con servizi sullo stesso server, l’applicazione IA destinata agli utenti e il servizio che esegue l’inferenza condividono un host. Possono comunque essere processi o container distinti.
In una configurazione separata, l’applicazione invia le richieste di inferenza a un servizio su un altro server o a un endpoint gestito. Microsoft descrive un modello in cui client remoti condividono un endpoint per modelli gestito centralmente ([documentazione Microsoft](https://learn.microsoft.com/en-us/windows-server/ai/local-ai-inference)). Questa fonte illustra quel modello specifico, ma non confronta le due configurazioni né indica quale sia preferibile.
Le domande di questa guida sono spunti da verificare rispetto alla tua applicazione e ai tuoi requisiti. Le informazioni disponibili non bastano a stabilire quale topologia offra prestazioni, sicurezza o gestione migliori.
- Servizi sullo stesso server: quali aspetti di risorse, manutenzione e ripristino vuoi verificare?
- Servizi separati: quali dipendenze di rete, endpoint e responsabilità operative vuoi chiarire?

Mappa componenti e flussi di dati
Per rendere concreto il confronto, rappresenta i componenti e le connessioni del sistema: applicazione destinata agli utenti, runtime di inferenza, file dei modelli, database, archiviazione, API esterne, sistemi di identità ed eventuali processi in background. Indica quali partecipano a una richiesta e quali sono facoltativi.
Per ogni componente, annota dove viene eseguito, chi se ne occupa e quali dati riceve o conserva. Verifica il comportamento effettivo dell’applicazione e della sua configurazione: non dedurre registrazione, conservazione o accessi dalla sola posizione dei servizi.
Traccia un’attività reale, dall’input dell’utente alla risposta. Il percorso può comprendere istruzioni dell’applicazione, documenti o altro contesto e chiamate a servizi esterni; controlla cosa viene inviato invece di presumerlo.
- Elenca applicazione, inferenza, database, archiviazione, attività pianificate e API esterne.
- Per ogni connessione, annota lo scopo, la direzione, le credenziali e cosa vuoi verificare se la dipendenza non è disponibile.
- Segna gli elementi che vuoi esaminare nel progetto pilota, come l’uso condiviso di CPU, memoria, acceleratore, disco o rete.
- Individua dove possono essere archiviati prompt, documenti caricati, risposte, log e record dell’applicazione.

Confronta le configurazioni con domande verificabili
Con i servizi sullo stesso server, puoi verificare se la configurazione dell’applicazione è compatibile, come vengono gestiti i file dei modelli e cosa accade durante le attività di manutenzione. Se vuoi valutare l’uso condiviso delle risorse, prova la configurazione con attività rappresentative: la topologia da sola non consente di stabilirne l’impatto.
Con servizi separati, individua il requisito a cui dovrebbe rispondere il confine tra server e chiarisci le dipendenze introdotte dalla rete e dall’endpoint. La separazione, da sola, non dimostra un miglioramento di prestazioni, sicurezza o isolamento.
Nel modello di endpoint gestito centralmente descritto da Microsoft, verifica chi può chiamarlo, come vengono gestiti gli accessi e quali dati possono essere inviati. Per entrambe le configurazioni, chiarisci cosa dovrebbe accadere se un componente o una dipendenza non è disponibile.
- Quale requisito concreto dovrebbe soddisfare la configurazione che stai valutando?
- Chi si occupa dei componenti, degli accessi, della manutenzione e del ripristino?
- Quali dati attraversano i confini tra servizi, dove possono essere registrati e chi può accedervi?
- Come vengono gestiti gli errori e cosa dovrebbero poter fare gli utenti quando l’inferenza non è disponibile?
Verifica le ipotesi con un progetto pilota
Un progetto pilota può aiutarti a valutare la tua applicazione e le configurazioni che stai considerando. Prima di iniziare, scegli attività e input rappresentativi e decidi cosa osservare, per esempio il comportamento dell’applicazione, il completamento dell’inferenza e l’idoneità dei risultati.
Prova il modello di utilizzo che ti aspetti di incontrare e annota configurazione, ipotesi e risultati. Se è pertinente al tuo ambiente, puoi verificare in un contesto controllato cosa accade quando un endpoint o un percorso di rete non è disponibile. Non dare per scontato il comportamento: registralo e controlla le procedure di ripristino.
- Scegli attività rappresentative, includendo eventuali passaggi di recupero documenti o chiamate ad API esterne.
- Definisci in anticipo i criteri di accettazione per il tuo caso d’uso.
- Se appropriato, osserva il comportamento in caso di indisponibilità di una dipendenza e verifica il ripristino.
- Conserva i risultati per confrontarli se cambiano configurazione o requisiti.
Documenta la decisione e le responsabilità
Registra la configurazione valutata, il requisito a cui dovrebbe rispondere, le ipotesi e i risultati del progetto pilota. Includi i responsabili dei componenti, i percorsi dei dati, le decisioni su accessi e conservazione e le procedure di ripristino. Rivedi la valutazione se cambiano i requisiti o le dipendenze.
Airbip offre la distribuzione gestita di applicazioni a catalogo come workload Docker sui server cloud Airbip. Include instradamento automatico e certificati TLS tramite Traefik e Let’s Encrypt, controlli DNS, gestione del ciclo di vita dei servizi e backup configurabili giornalieri, settimanali e mensili. Queste funzionalità infrastrutturali non determinano dove debba essere eseguito uno specifico servizio di inferenza. Verifica che la configurazione desiderata dell’applicazione e del servizio di inferenza sia compatibile con i tuoi requisiti.
- Configurazione valutata, requisito e ipotesi.
- Flussi di dati, accessi, conservazione e relative responsabilità.
- Comportamenti in caso di guasto e procedure di ripristino.
- Risultati del progetto pilota e condizioni che richiedono una nuova valutazione.
Domande frequenti
Un server di inferenza separato migliora sempre le prestazioni?
Le informazioni disponibili non dimostrano un vantaggio generale. La configurazione separata introduce una dipendenza di rete; valuta le opzioni con la tua applicazione e attività rappresentative.
La co-locazione è automaticamente più sicura?
No. La sola posizione dei servizi non determina controlli di accesso, conservazione dei dati o governance. Verifica quali dati si spostano tra i componenti e chi può accedervi.
Un endpoint di inferenza può servire più applicazioni?
Microsoft descrive un endpoint per modelli gestito centralmente e condivisibile da client remoti ([documentazione](https://learn.microsoft.com/en-us/windows-server/ai/local-ai-inference)). La compatibilità con una specifica configurazione dipende dalle applicazioni e dai relativi requisiti.
L’hosting gestito delle applicazioni determina dove viene eseguita l’inferenza?
Non da solo. Airbip gestisce la distribuzione di applicazioni a catalogo e offre funzionalità infrastrutturali come instradamento, automazione TLS, controlli DNS, gestione del ciclo di vita dei servizi e backup configurabili. Verifica separatamente la compatibilità della configurazione di inferenza desiderata.