Cómo establecer un presupuesto de conexiones a la base de datos para una aplicación autoalojada
Calcula cuántas conexiones podría abrir tu aplicación, compara esa capacidad con el límite de la base de datos y valida el presupuesto con cargas de trabajo realistas.
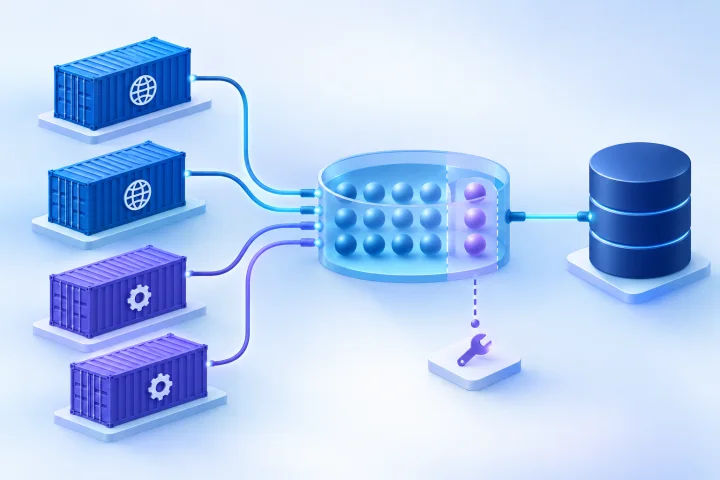
Por qué las conexiones a la base de datos necesitan un presupuesto
Un presupuesto de conexiones estima cuántas conexiones simultáneas podría necesitar una implementación y qué capacidad conviene reservar para mantenimiento o aumentos imprevistos de la demanda. Ayuda a evitar que se agoten las conexiones sin tratar el límite de la base de datos como una cifra que haya que alcanzar.
Añadir contenedores de aplicación puede aumentar la capacidad potencial de conexión, aunque el código y el tráfico por contenedor no cambien. La [Compose Deploy Specification de Docker](https://docs.docker.com/reference/compose-file/deploy/) define las réplicas como la cantidad de contenedores previstos para un servicio replicado; si cada réplica tiene sus propios pools, cada una aumenta la capacidad potencial.
La capacidad configurada no equivale al uso real: un pool puede tener conexiones disponibles que no estén abiertas en ese momento. Además, una conexión inactiva entre consultas puede seguir abierta y contar para el límite de la base de datos. La infraestructura gestionada no elimina la necesidad de conocer el comportamiento de los pools y el límite de la base de datos.
- Trata la capacidad configurada del pool como un máximo potencial, no como una predicción del uso habitual.
- Las conexiones abiertas observadas son una medición en un momento dado, no una prueba de que todas estén ejecutando consultas.
- Calcula un presupuesto separado para cada base de datos a la que se conecten los componentes.

Haz un inventario de todas las fuentes de conexiones
Enumera todos los procesos y herramientas que pueden conectarse a la base de datos. No cuentes solo la aplicación de cara al usuario: los trabajos en segundo plano y las tareas operativas pueden tener sus propios pools o conexiones directas.
Para cada fuente, registra cuántas instancias pueden ejecutarse simultáneamente, cuántos procesos o instancias de pool puede crear cada una y cuál es la capacidad configurada. Comprueba la configuración de la implementación y la documentación oficial de la aplicación; no des por hecho que el valor predeterminado de un framework corresponde a tu versión o configuración.
- Contenedores de la aplicación web, incluido el máximo de réplicas que podrías implementar.
- Contenedores de trabajadores y el número de procesos o instancias de pool de cada uno.
- Planificadores, tareas recurrentes y otros servicios que se conectan directamente a la base de datos.
- Migraciones, tareas de implementación, monitorización, generación de informes, herramientas relacionadas con copias de seguridad y sesiones administrativas.
- Posible superposición temporal durante versiones nuevas o procesos de recuperación, si las instancias antiguas y nuevas pueden ejecutarse a la vez.

Estima la demanda potencial sin confundirla con el uso real
Como primera estimación, calcula la capacidad máxima configurada de cada grupo de pools y suma los grupos que se conectan a la misma base de datos. Una fórmula útil es: capacidad potencial de los pools = número de instancias en ejecución × pools por instancia × conexiones máximas por pool. Añade los trabajadores independientes y otros servicios, y cuenta también las conexiones directas que no usan esos pools.
Usa el número real de instancias de pool, no uno supuesto a partir de los contenedores. Por ejemplo, si una aplicación crea un pool por proceso, varios procesos web en cada contenedor multiplican la capacidad de ese contenedor. Si un pool se comparte entre procesos, sigue el comportamiento documentado de la aplicación para evitar contarlo dos veces.
Este cálculo es hipotético, no una configuración recomendada: tres réplicas, cada una con cuatro procesos y un tamaño máximo de pool de cinco conexiones por proceso, tienen una capacidad potencial de 60 conexiones para los pools web. Si un servicio de trabajadores independiente tiene dos réplicas con una capacidad de pool de cuatro cada una, añade ocho: el total potencial combinado es 68 antes de contar migraciones, monitorización o acceso administrativo.
- Anota cada dato de entrada y su origen: réplicas, procesos por instancia, instancias de pool y límites por pool.
- Usa el máximo de instancias que puede alcanzar la implementación durante el escalado habitual o una versión nueva, no solo las que están en ejecución hoy.
- No sumes en un mismo total las capacidades de componentes que se conectan a servidores de bases de datos diferentes.
- En los casos documentados de QueuePool de SQLAlchemy, el máximo de conexiones que puede usar un Engine es pool_size más max_overflow. Confirma que ese pool y esos ajustes corresponden a tu aplicación; consulta la [documentación de SQLAlchemy sobre límites de los pools](https://docs.sqlalchemy.org/en/20/errors.html).
Compara la estimación con el límite de la base de datos
Compara la demanda potencial con el límite documentado de conexiones simultáneas de la base de datos. Reserva capacidad para las tareas operativas que necesites, como mantenimiento, migraciones, monitorización, diagnóstico administrativo y aumentos breves de la demanda. Determina la reserva según tus necesidades y los picos observados: no existe un porcentaje seguro universal.
Ten en cuenta cómo define la base de datos las conexiones disponibles. La [documentación de PostgreSQL sobre conexiones y autenticación](https://www.postgresql.org/docs/17/runtime-config-connection.html) define max_connections como el máximo de conexiones simultáneas y señala que aumentarlo incrementa la asignación de ciertos recursos, incluida la memoria compartida. PostgreSQL también puede reservar conexiones para roles con los privilegios adecuados.
La [documentación de conexiones de MySQL](https://dev.mysql.com/doc/refman/8.0/en/connection-interfaces.html) describe max_connections como el máximo de clientes simultáneos permitidos. También documenta una conexión adicional para una cuenta con el privilegio CONNECTION_ADMIN o el privilegio SUPER, ya obsoleto, con fines de diagnóstico. Es una disposición administrativa, no capacidad ordinaria para la aplicación.
Si la estimación se acerca al límite disponible o lo supera, revisa primero el número de réplicas, los procesos, el tamaño de los pools y las fuentes de conexiones innecesarias. Aumentar el límite no corrige por sí solo un pool sobredimensionado ni una fuga de conexiones.
- Registra el límite configurado y las conexiones reservadas o privilegiadas que sean pertinentes.
- Resta la reserva operativa antes de decidir qué capacidad queda disponible para los pools de la aplicación.
- Consulta la documentación del proveedor y la configuración que realmente utilizas.
- Si cambias el límite, evalúa las implicaciones para los recursos de la base de datos y valida el nuevo ajuste.
Comprueba cómo funciona el pooling en ambas capas
Un pool de la aplicación y un límite de conexiones de la base de datos controlan aspectos diferentes. El pool determina cuántas conexiones puede crear la aplicación y qué ocurre cuando están ocupadas; el límite de la base de datos determina cuántos clientes acepta simultáneamente. Si el pool permite más conexiones de las que la base de datos puede atender, el problema puede trasladarse de la aplicación al servidor.
En los casos documentados de QueuePool de SQLAlchemy, las solicitudes adicionales esperan cuando se alcanza la capacidad configurada y pueden agotar el tiempo de espera. La [documentación de SQLAlchemy](https://docs.sqlalchemy.org/en/20/errors.html) advierte que un desbordamiento ilimitado puede llevar la demanda hasta el límite de conexiones de la base de datos. Un tiempo de espera del pool es una señal para investigar la demanda y el comportamiento del pool, no una indicación automática de que debas ampliarlo.
Si PgBouncer forma parte del diseño, distingue las conexiones de cliente de las conexiones de servidor. Su [documentación de configuración](https://www.pgbouncer.org/config) describe límites independientes; la diferencia puede representar clientes en espera de conexiones de servidor activas. El modo de pool también determina cuándo puede reutilizarse una conexión de servidor: en modo de sesión, cuando el cliente se desconecta; en modo de transacción, cuando termina una transacción. Comprueba el modo configurado y la compatibilidad de la aplicación.
No des por hecho que hay pooling solo porque la aplicación o la implementación utiliza contenedores. Identifica qué componente administra cada pool, si es por proceso y si hay un proxy entre la aplicación y la base de datos.
- Consulta la documentación oficial del pool de la aplicación o del framework para la configuración implementada.
- Confirma el significado de los ajustes de tamaño, desbordamiento, tiempo de inactividad y espera, si están disponibles.
- Si utilizas un proxy, calcula por separado las conexiones del lado de los clientes y del lado de la base de datos.
Valida el presupuesto con una concurrencia representativa
Un cálculo teórico es solo un punto de partida. Prueba la aplicación con solicitudes simultáneas y trabajos en segundo plano representativos, incluidos los patrones de carga importantes para tu equipo. Observa el número de conexiones junto con las colas y los errores; compara después el pico con la estimación y la capacidad reservada.
En PostgreSQL, [pg_stat_activity](https://www.postgresql.org/docs/16/monitoring-stats.html) ofrece una fila por proceso del servidor e incluye campos como application_name, usuario, dirección del cliente, estado y consulta actual. Estos campos ayudan a identificar fuentes de conexiones e inspeccionar la actividad observada. Para otros motores, usa la monitorización adecuada; en MySQL, el contador [Connection_errors_max_connections](https://dev.mysql.com/doc/refman/8.0/en/connection-interfaces.html) aumenta cuando se rechaza una conexión por haberse alcanzado max_connections.
Incluye una implementación o migración en las pruebas si puede coincidir con el tráfico en producción, así como la actividad de los trabajadores que comparten la base de datos. Comprueba si la demanda cabe en el presupuesto y si la aplicación pone solicitudes en cola o falla antes de que se agote el límite.
- Registra el pico de conexiones abiertas y, cuando estén disponibles, su estado y la identidad de su origen.
- Vigila las esperas del pool, los tiempos de espera por alcanzar su límite, los rechazos de conexiones y los contadores del lado de la base de datos.
- Repite la comprobación tras cambiar las réplicas, la concurrencia de los trabajadores, los ajustes de los pools o la configuración de la base de datos.
Investiga las señales de alerta antes de cambiar los límites
Un tiempo de espera del pool puede indicar que todas las conexiones configuradas están ocupadas; un rechazo de la base de datos puede indicar que se alcanzó el límite del servidor. Ninguno de los síntomas, por sí solo, identifica la causa raíz. Comprueba si aumentó la demanda, si los trabajos tardan más, si las conexiones permanecen abiertas más tiempo del previsto o si algún componente creó más pools de los que contemplaba el presupuesto.
Busca también conexiones inactivas persistentes. La [documentación de SQLAlchemy](https://docs.sqlalchemy.org/en/20/errors.html) explica que una conexión liberada puede seguir conectada en el pool para reutilizarse, por lo que las conexiones abiertas no implican necesariamente que haya una consulta en ejecución. En PostgreSQL, los campos de identificación y actividad de pg_stat_activity pueden ayudar a rastrear su origen.
- Tiempos de espera del pool: confirma su capacidad y comprueba si hay demanda sostenida o conexiones retenidas demasiado tiempo.
- Rechazos de conexiones: verifica el límite del servidor, la capacidad reservada y qué fuentes se están conectando.
- Un número inesperadamente alto de conexiones abiertas: identifica si son conexiones inactivas en pools, trabajo activo, pools duplicados o una fuga.
- Cambios repentinos tras una implementación: compara réplicas, procesos, trabajadores y ajustes de los pools con el presupuesto anterior.
Documenta el presupuesto y cuándo revisarlo
Guarda el cálculo junto con la configuración de implementación o la documentación de operaciones. Debe poder reproducirse: otra persona encargada de las operaciones debería poder ver qué procesos se contaron, qué ajustes se usaron, qué capacidad se reservó y cómo se validó la estimación.
Revisa el presupuesto cuando cambie el sistema. Airbip ejecuta instancias de aplicaciones como cargas de trabajo Docker en servidores en la nube de Airbip y ofrece implementación gestionada y administración del ciclo de vida de los servicios. Estas capacidades de infraestructura no determinan el comportamiento de los pools de cada aplicación ni sustituyen la revisión del presupuesto de conexiones. Los equipos siguen siendo responsables de entender sus decisiones sobre la aplicación y el acceso a los datos.
- Documenta el límite de la base de datos, las conexiones reservadas, los ajustes de los pools y el origen de cada dato.
- Enumera el máximo de réplicas, los procesos por instancia, la concurrencia de los trabajadores y las demás fuentes de conexiones.
- Registra el cálculo, el pico observado, las condiciones de prueba y los supuestos conocidos.
- Asigna una persona responsable y revisa el presupuesto después de cambios de escala, de la aplicación o de la base de datos, del crecimiento de la carga de trabajo o del plan de recuperación.
- Incluye migraciones y acceso administrativo en los procedimientos de implementación y recuperación.
Preguntas frecuentes
¿El tamaño del pool equivale al número de conexiones que usa la aplicación?
No. Es la capacidad configurada, no necesariamente el número de conexiones abiertas ni el de consultas en ejecución. Mide las conexiones observadas además de calcular el máximo potencial.
¿Cómo calculo las conexiones si ejecuto varios contenedores de aplicación?
Cuenta las instancias de pool de cada contenedor y multiplica su capacidad máxima por el número de instancias que pueden ejecutarse simultáneamente. Si cada proceso tiene su propio pool, incluye también el número de procesos. Añade los trabajadores y otras fuentes que usen la misma base de datos.
¿Debería aumentar el límite de conexiones cuando se agotan?
No automáticamente. Identifica qué clientes se conectan y comprueba si cambiaron la capacidad de los pools, las conexiones abiertas o la concurrencia. Aumentar max_connections en PostgreSQL incrementa la asignación de ciertos recursos, incluida la memoria compartida; consulta la [documentación de PostgreSQL](https://www.postgresql.org/docs/17/runtime-config-connection.html) y valida el impacto.
¿Para qué debería reservar conexiones de la base de datos?
Para las tareas operativas que necesite tu implementación, como mantenimiento, migraciones, monitorización, administración y demanda imprevista. La cantidad depende del sistema y de la carga de trabajo observada; no existe una reserva segura universal.
¿Puedo ignorar los ajustes de los pools de la aplicación si uso PgBouncer?
No. PgBouncer distingue los límites de conexiones de cliente y de servidor, y el modo de pool influye en cuándo pueden reutilizarse las conexiones de servidor. Calcula ambas partes y comprueba el modo configurado en la [documentación oficial de PgBouncer](https://www.pgbouncer.org/config).
Fuentes y lecturas adicionales
- PostgreSQL: Connections and Authentication — PostgreSQL Global Development Group
- PostgreSQL: The Cumulative Statistics System — PostgreSQL Global Development Group
- SQLAlchemy: Error Messages — Connection Pool Limits — SQLAlchemy
- PgBouncer Configuration — PgBouncer
- Compose Deploy Specification — Docker
- MySQL: Connection Interfaces — Oracle