¿Qué ocurre cuando falla una dependencia? Una prueba de resiliencia para aplicaciones autoalojadas
Un método práctico para mapear los servicios de los que depende su aplicación autoalojada, probar interrupciones realistas de forma segura y definir alternativas seguras antes de un lanzamiento o una migración.
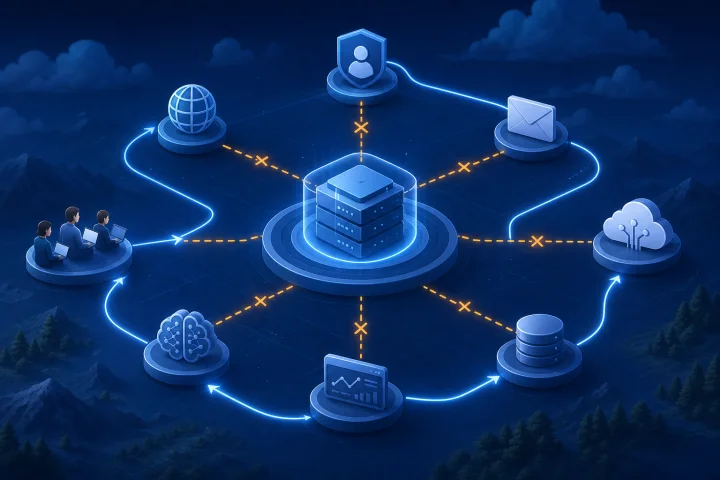
Una aplicación puede estar en buen estado mientras su trabajo es imposible
Un contenedor en ejecución, una solicitud correcta a la página de inicio de sesión o una comprobación en verde del proxy inverso solo responden a una pregunta limitada: ¿ese componente responde en la condición que se está comprobando? No demuestran que los usuarios puedan iniciar sesión mediante el proveedor de identidad de la organización, enviar una notificación, recuperar un archivo, completar un pago, llamar a una API conectada u obtener una respuesta de un servicio de modelos.
Docker Compose puede iniciar servicios en orden de dependencia, pero el orden de inicio por sí solo no significa que una dependencia esté preparada para el trabajo de la aplicación. Docker documenta el uso de una comprobación de estado configurada y de la condición `service_healthy` cuando un servicio dependiente debe esperar a que otro esté listo ([documentación de Docker](https://docs.docker.com/compose/how-tos/startup-order/)). Incluso entonces, las comprobaciones de estado requieren una interpretación precisa: el endpoint `/ping` documentado por Traefik demuestra que el proceso de Traefik está activo, no que todas las rutas ascendentes de la aplicación sean utilizables ([documentación de Traefik](https://doc.traefik.io/traefik/reference/install-configuration/observability/healthcheck/)).
Considere la resiliencia como una cuestión orientada a resultados: ¿qué tareas de usuario deben seguir teniendo éxito, cuáles pueden retrasarse y cuáles deben bloquearse de forma segura cuando una dependencia se deteriora? Esto produce un plan mucho más útil que una lista de integraciones.
- Vitalidad: un proceso responde a una solicitud simple.
- Preparación: un servicio puede aceptar el tipo específico de trabajo que está a punto de recibir.
- Finalización de negocio: el resultado previsto ocurrió una vez, con los datos correctos y cualquier registro de auditoría requerido.
- Recuperación: el equipo puede restaurar el funcionamiento normal, conciliar trabajos inciertos y explicar el impacto.

Mapee las dependencias según la función que desempeñan
Empiece por los recorridos de usuario, no por el archivo de configuración. Para cada recorrido importante —como iniciar sesión, crear un registro de cliente, publicar contenido, enviar una factura, aceptar el envío de un formulario o responder una consulta de IA— rastree cada servicio necesario desde la acción del usuario hasta el resultado confirmado.
Incluya dependencias gestionadas, externas y operadas por personas. Un diagrama de despliegue de Docker es útil, pero incompleto: DNS, un registrador o proveedor de dominios personalizados, identidad, SMTP o API de correo electrónico, API SaaS, emisores de webhooks, endpoints de modelos y supervisión pueden estar todos fuera de la pila de aplicación. Docker Compose también admite servicios de proveedores delegados externamente, lo que refuerza que una carga de trabajo puede depender de recursos cuyo ciclo de vida se gestiona en otro lugar ([referencia de Docker Compose](https://docs.docker.com/reference/compose-file/services/)).
Utilice los siguientes grupos funcionales para que las brechas sean visibles desde el principio.
- Identidad y acceso: proveedor de identidad, federación, autenticación multifactor, directorio de roles, ruta de acceso de administrador.
- Red y dominio: DNS, configuración de dominio personalizado, proxy inverso, validación de certificados TLS y ruta de renovación.
- Comunicación: relé SMTP, API de correo transaccional, gestión de correo entrante, servicios de mensajería o notificación.
- Datos y archivos: base de datos principal, almacenamiento de objetos o archivos, destino de copias de seguridad, ubicaciones de importación o exportación.
- Servicios comerciales y conectados: proveedor de pagos, CRM, contabilidad, analítica, mapas, búsqueda, API de socios y credenciales de API.
- Procesamiento asíncrono: colas, programadores, trabajadores, webhooks y endpoints de devolución de llamada.
- Servicios de IA: endpoint de modelo, servicio de embeddings, almacén vectorial, canalización de recuperación de documentos y credenciales de modelo.
- Operaciones: registros, supervisión, entrega de alertas, contactos para incidentes, gestión de secretos y documentación administrativa.

Clasifique las dependencias según la consecuencia de perderlas
No asigne el mismo objetivo de resiliencia a cada dependencia. La guía de cadena de suministro de NIST respalda la variación de requisitos según la criticidad, considerando el impacto en la misión o el negocio, los datos tratados y el producto o servicio suministrado ([NIST SP 1305](https://nvlpubs.nist.gov/nistpubs/SpecialPublications/NIST.SP.1305.pdf)). Aplique el mismo razonamiento a cada dependencia de la arquitectura de su aplicación.
Una clasificación sencilla en cuatro partes obliga a decidir qué funcionamiento degradado es aceptable. Un servicio puede aparecer en más de una categoría para distintos flujos de trabajo; por ejemplo, el correo electrónico puede ser opcional para consultar registros, pero necesario para recuperar contraseñas o realizar entregas legalmente importantes.
- Necesaria para iniciar sesión: sin ella, los usuarios normales no pueden establecer una sesión. Defina por separado una ruta segura de acceso de emergencia para administradores.
- Necesaria para trabajar: sin ella, una transacción principal no puede completarse correctamente. Algunos ejemplos pueden incluir el almacén de datos principal o una API externa obligatoria.
- Necesaria para funciones opcionales: los usuarios pueden continuar su trabajo principal, pero una acción no esencial no está disponible o se retrasa.
- Necesaria para la recuperación: el funcionamiento diario puede continuar temporalmente, pero la restauración, renovación de certificados, notificación de incidentes o recuperación de datos dependen de ella.
- Para cada clasificación, establezca una ventana de interrupción aceptable, un máximo de trabajo acumulado tolerable, la alternativa permitida y la persona autorizada para activar esa alternativa.
Pida evidencias, no descripciones tranquilizadoras
La documentación del proveedor y un entorno de prueba deben responder preguntas operativas que las páginas de marketing a menudo no responden. Registre un enlace, resultado de prueba, referencia de configuración o contacto de soporte para cada respuesta. Cuando la documentación guarde silencio, marque el comportamiento como desconocido en lugar de asumir que existe un reintento, una cola o una copia de seguridad.
Compruebe el límite preciso que se está probando. Traefik indica que, cuando las comprobaciones de estado están activadas y todos los servidores de un servicio no están en buen estado, puede devolver HTTP 503. Esto es una evidencia útil sobre la disponibilidad ascendente en el límite del proxy inverso, pero no demuestra que se haya completado una transacción de usuario ([preguntas frecuentes de Traefik](https://doc.traefik.io/traefik/getting-started/faq/)).
La automatización de certificados merece su propia entrada de dependencia. La validación HTTP-01 de Let’s Encrypt requiere que la autoridad de certificación recupere un archivo de desafío del servidor web, mientras que DNS-01 requiere que consulte un registro TXT en DNS. Por tanto, la ruta pertinente, el control de DNS, el alcance de las credenciales y el comportamiento de propagación deben documentarse antes de que la renovación sea urgente ([documentación sobre desafíos de Let’s Encrypt](https://letsencrypt.org/docs/challenge-types/)).
- ¿Qué operación exacta demuestra que la dependencia es utilizable, en lugar de simplemente accesible?
- ¿Qué tiempo de espera, código de error, política de reintentos, límite de reintentos y comportamiento de retroceso se aplican?
- ¿Puede aceptarse una solicitud y completarse más tarde, y dónde puede verificarse su estado final?
- ¿Pueden los eventos llegar tarde, más de una vez o fuera de orden?
- ¿La aplicación pone trabajo en cola durante una interrupción? ¿Cuál es el límite, la visibilidad y el método de conciliación de la cola?
- ¿Qué credenciales se necesitan para la recuperación, dónde se almacenan y quién puede usarlas?
- ¿Qué cambios de DNS o de red pueden impedir la renovación de certificados o el acceso a dominios personalizados?
- ¿Existe un entorno no productivo o de pruebas del proveedor para realizar una validación segura?
Ejecute pruebas controladas de fallos que se parezcan a incidentes de producción
Una prueba de resiliencia debe tener un alcance definido, una condición de seguridad, una acción de reversión y un observador. Comience en un entorno no productivo representativo. Pase a ejercicios limitados en producción solo cuando se comprendan el impacto, la autorización, la supervisión y la reversión. No ejecute un experimento que se espere que cause un fallo incontrolado de la carga de trabajo.
Pruebe un flujo de trabajo empresarial real, no solo una comprobación de conexión. Por ejemplo, si la entrega de correo electrónico no está disponible, pruebe la invitación de cuentas, el restablecimiento de contraseñas y la acción que depende de que el destinatario reciba el mensaje. Registre por separado si la aplicación aceptó la solicitud, si el proveedor de correo la aceptó y si el destinatario previsto puede completar la acción requerida. Si un endpoint de modelo no está disponible, pruebe lo que ve el usuario, si los documentos de origen permanecen protegidos y si una interacción incompleta se registra con precisión.
Para solucionar problemas de certificados o desarrollar clientes, use el entorno de pruebas de Let’s Encrypt en lugar de provocar repetidamente autorizaciones fallidas en producción. Let’s Encrypt recomienda el entorno de pruebas para diagnosticar las condiciones de autorización sin consumir los límites de producción ([documentación sobre límites de velocidad de Let’s Encrypt](https://letsencrypt.org/docs/rate-limits/)).
- Proveedor de identidad no disponible: intente el inicio de sesión de un usuario normal, la renovación de sesión, el acceso de administrador y el cierre de sesión; verifique el acceso de emergencia solo bajo los controles documentados.
- Fallo de entrega de correo: inicie mensajes, inspeccione el estado de la aplicación y la evidencia de entrega, verifique el mensaje mostrado al usuario; después restaure la entrega y concilie las acciones retrasadas o fallidas.
- API inaccesible: interrumpa la ruta o deniegue la credencial en un entorno de prueba; compruebe tiempos de espera, presentación de errores, estado guardado y si la acción puede repetirse de forma segura.
- Webhook retrasado: retrase la entrega y luego libérela; pruebe la reentrega, los eventos duplicados y los eventos fuera de orden cuando la documentación del proveedor o de la aplicación identifique estos comportamientos.
- Límite de velocidad agotado: simule errores de cuota cuando sea posible; verifique reintentos limitados, retroceso y una condición clara de detención.
- Endpoint de modelo no disponible: pruebe un tiempo de espera y una respuesta de error; determine si la aplicación ofrece un estado de no disponibilidad claramente etiquetado, aplaza el trabajo o debe bloquear el flujo de trabajo.
- Servicio ascendente no saludable: deje no disponibles, en un entorno de prueba, todos los servidores detrás de un servicio de proxy inverso con comprobación de estado; verifique la gestión esperada de 503, las alertas y la recuperación.
Registre los resultados que determinan si un fallo es seguro
Una prueba está incompleta cuando el único resultado es «volvió a intentarlo». Un reintento puede seguir a una operación cuyo resultado se desconoce. Una respuesta satisfactoria de una aplicación o API externa puede indicar que se alcanzó un límite de procesamiento; por sí sola, no demuestra todos los resultados empresariales posteriores. Defina la evidencia de finalización necesaria para cada flujo de trabajo.
Registre lo que experimentan los usuarios y lo que deben hacer los administradores, pero determine también si los datos son correctos. Para cada operación retrasada o reintentada, establezca, a partir de la documentación pertinente de la aplicación y del proveedor, si son posibles entregas duplicadas, reordenamiento, finalización parcial o resultados inciertos. Cuando sean posibles, utilice un diseño seguro frente a duplicados y mantenga un plan de conciliación.
Cuando una API documente compatibilidad con idempotencia, utilice su mecanismo documentado para solicitudes de creación o actualización que se puedan reintentar. No suponga que existe tal mecanismo para una API que no lo documenta.
- Impacto en el usuario: tarea exacta afectada, mensaje de error, estado visible y si los usuarios pueden continuar con otro trabajo.
- Riesgo para la integridad de los datos: ¿la acción puede perderse, duplicarse, guardarse parcialmente, procesarse fuera de orden o quedar en un estado desconocido?
- Comportamiento de reintentos: desencadenante, tiempo de espera, programación, retroceso, máximo de intentos y estado de fallo final.
- Comportamiento de la cola: dónde se retiene el trabajo, límite de acumulación, gestión de duplicados, supuestos de orden, caducidad y método de reproducción.
- Observabilidad: registros, métricas, alertas, ID de correlación y la evidencia utilizada para decidir que el procesamiento se completó.
- Acciones de administrador: contención inmediata, pasos de verificación, procedimiento de conciliación, contacto de escalado y la regla para declarar completa la recuperación.
Diseñe alternativas que sean prácticas y seguras
Una buena alternativa preserva la seguridad y hace explícitos los límites. No es simplemente una forma de forzar el funcionamiento del sistema. Defina qué puede continuar, qué debe pausarse, quién puede aprobar un proceso manual, dónde se conserva el registro y cómo se conciliará posteriormente el trabajo diferido.
El acceso administrativo de emergencia es un ejemplo clave. Microsoft recomienda cuentas de emergencia diseñadas para escenarios de interrupción de proveedores de identidad federados, mediante cuentas solo en la nube que no dependan de federación ni de sincronización local. La misma guía destaca una autenticación fuerte distinta de la de las cuentas administrativas normales, el almacenamiento seguro de credenciales, el registro y la supervisión, así como simulacros de validación periódicos ([guía de acceso de emergencia de Microsoft](https://learn.microsoft.com/en-us/entra/identity/role-based-access-control/security-emergency-access)).
Para el trabajo de cara al cliente, un procedimiento manual puede ser más seguro que los reintentos automatizados cuando la operación puede tener consecuencias financieras, legales o de registros duplicados. Una opción de trabajo diferido solo es apropiada cuando se comprenden la cola, el estado final y el proceso de conciliación.
- Acceso local de emergencia: acceso de administrador estrictamente controlado y autenticado por separado para una interrupción de identidad; úselo únicamente de acuerdo con un procedimiento documentado y probado.
- Proceso manual: una alternativa limitada en el tiempo, como registrar solicitudes en un sistema aprobado para introducirlas posteriormente, con un responsable y una comprobación de conciliación.
- Trabajo diferido: poner en cola el trabajo elegible hasta que regrese una dependencia, mientras se realiza un seguimiento de la acumulación, la caducidad, el procesamiento duplicado y el estado del usuario.
- Aislamiento de funciones: desactivar solo la función opcional afectada mientras se preservan flujos de trabajo principales seguros.
- Comunicaciones claras: indique qué no está disponible, qué deben hacer los usuarios en su lugar, si se ha guardado el trabajo y cuándo se proporcionará la próxima actualización.
Evite soluciones provisionales que conviertan una interrupción en un incidente de seguridad o de datos
Nunca convierta «desactivar la autenticación» en la respuesta predeterminada ante una interrupción de identidad. Esto elimina el control justo cuando los administradores tienen menos visibilidad y mayor presión. En su lugar, prepare un diseño de acceso de emergencia limitado con credenciales distintas, uso restringido, supervisión y pruebas programadas.
Del mismo modo, no trate los reintentos como prueba de que no se perdió ni se duplicó nada. Los límites de velocidad pueden empeorar los fallos repetidos. Let’s Encrypt aplica límites a las autorizaciones fallidas y recomienda el entorno de pruebas durante la resolución de problemas ([documentación sobre límites de velocidad de Let’s Encrypt](https://letsencrypt.org/docs/rate-limits/)). Configure reintentos limitados y una condición de detención, y después investigue o concilie el trabajo cuyo resultado siga siendo incierto.
Evite las credenciales de DNS sin restricciones por comodidad para la automatización de certificados. Let’s Encrypt advierte que colocar credenciales amplias de API DNS en un servidor web aumenta el impacto de una vulneración, y sugiere credenciales de alcance reducido o la validación desde un servidor independiente cuando sea viable ([documentación sobre desafíos de Let’s Encrypt](https://letsencrypt.org/docs/challenge-types/)).
- No omita controles de acceso sin un procedimiento de emergencia preautorizado y registrado.
- No reproduzca transacciones desconocidas hasta poder determinar si la original se completó.
- No suponga que la entrega de webhooks ocurre una sola vez o en orden sin confirmar el comportamiento documentado.
- No permita que un bucle de reintentos sin límite genere carga, costes o bloqueo por parte del proveedor.
- No conceda permisos DNS amplios únicamente para automatizar una sola tarea de validación.
- No cierre un incidente basándose únicamente en la actividad del proceso; verifique el resultado empresarial afectado y concilie el trabajo acumulado.
Preguntas frecuentes
¿Qué es la planificación ante fallos de dependencias en aplicaciones autoalojadas?
Es la práctica de identificar todos los servicios de los que depende una aplicación, clasificar el impacto empresarial de perder cada uno, probar modos de fallo realistas y documentar alternativas seguras y acciones de recuperación antes de que ocurra un incidente.
¿Todas las dependencias deben tener el mismo objetivo de recuperación?
No. Establezca requisitos según la criticidad: impacto empresarial, datos procesados y servicio prestado. Una dependencia necesaria para iniciar sesión o para transacciones principales generalmente necesita un plan distinto de otra usada solo para una función opcional.
¿Por qué no basta una comprobación de estado correcta?
Una comprobación de estado normalmente demuestra una condición limitada y definida, como la actividad de un proceso o la disponibilidad ascendente. Puede no demostrar que los usuarios puedan completar un inicio de sesión, enviar un correo electrónico, procesar un pago, recuperar un archivo o recibir una respuesta de IA.
¿Cómo debemos probar la resiliencia de los webhooks?
Pruebe entregas fallidas, entregas retrasadas, reentregas, duplicados y eventos fuera de orden cuando esos comportamientos sean relevantes para el proveedor o la aplicación. Verifique que el procesamiento sea seguro frente a duplicados cuando sea necesario y que el equipo pueda conciliar los eventos después de la recuperación.
¿Cómo debería ser una alternativa ante una interrupción del proveedor de identidad?
Utilice una ruta de acceso de emergencia para administradores planificada y estrechamente protegida que no dependa de la ruta de federación fallida. Proteja las credenciales, use una autenticación fuerte distinta, registre su uso, supervise la actividad y valide el procedimiento regularmente. No desactive los controles de acceso de forma generalizada.
¿En qué ayuda el alojamiento gestionado y qué sigue siendo responsabilidad del propietario de la aplicación?
Para las aplicaciones compatibles, Airbip gestiona la infraestructura en la nube alrededor de instancias de aplicaciones autoalojadas, incluidas cargas de trabajo Docker en servidores en la nube de Airbip, enrutamiento y automatización de certificados TLS mediante Traefik y Let’s Encrypt, comprobaciones DNS, gestión del ciclo de vida de los servicios y copias de seguridad diarias, semanales y mensuales configurables. Esto puede reducir las dependencias de infraestructura que un equipo opera directamente. El propietario de la aplicación aún debe tomar y probar decisiones sobre integraciones de la aplicación, identidad y acceso, gestión de datos, procesos empresariales, proveedores externos y procedimientos de continuidad.
Fuentes y lecturas adicionales
- Control startup and shutdown order in Compose — Docker
- Define services in Docker Compose — Docker
- Traefik Health Check Documentation — Traefik Labs
- Traefik Getting Started FAQ — Traefik Labs
- Challenge Types — Let's Encrypt / Internet Security Research Group
- Rate Limits — Let's Encrypt / Internet Security Research Group
- The NIST Cybersecurity Framework (CSF) 2.0 — NIST
- NIST CSF 2.0: Quick-Start Guide for Cybersecurity Supply Chain Risk Management — NIST
- OWASP Application Security Verification Standard — OWASP Foundation
- Manage emergency access admin accounts — Microsoft