La IA autoalojada no es privada automáticamente: lista de comprobación del flujo de datos
Alojar tú mismo una aplicación de IA no demuestra que las instrucciones, los archivos, los registros o las copias de seguridad permanezcan en tu infraestructura. Sigue cada flujo de datos y verifica cada destino antes de usar información sensible.
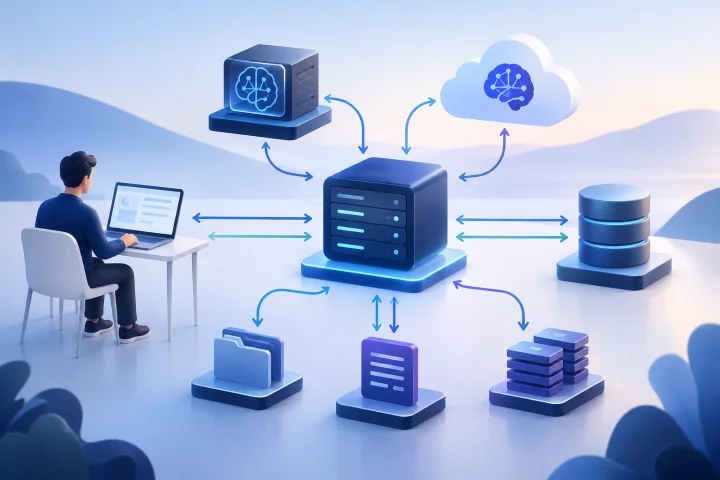
Autoalojar describe una opción de despliegue, no un resultado completo de privacidad
Una aplicación de IA autoalojada se ejecuta en una infraestructura que tú o un proveedor de alojamiento ponen a disposición. Ese hecho, por sí solo, no indica dónde se realiza la inferencia, qué servicios reciben datos, qué información se conserva ni quién puede acceder a las copias operativas.
Considera la aplicación y el punto de acceso al modelo como partes distintas del sistema. La introducción a la API de Ollama (https://github.com/ollama/ollama/blob/main/docs/api/introduction.mdx) describe tanto una dirección de API local como una URL base de API en la nube. Su documentación de autenticación (https://github.com/ollama/ollama/blob/main/docs/api/authentication.mdx) también explica que las solicitudes a modelos en la nube pueden hacerse a través de su API local. Enviar una solicitud a una interfaz local no demuestra, por sí mismo, que el procesamiento del modelo sea local.
La pregunta adecuada no es simplemente «¿Está autoalojado?». Pregúntate: «Para este flujo de trabajo y estos tipos de datos, ¿qué sistemas procesan o almacenan la información, bajo qué condiciones y cómo podemos verificarlo?»
- Alojamiento de la aplicación: dónde se ejecutan la interfaz de usuario y sus servicios auxiliares.
- Alojamiento del modelo: dónde se realiza la inferencia y qué punto de acceso recibe las solicitudes.
- Tratamiento de datos: qué se almacena, registra, respalda, transmite o pone a disposición de operadores y servicios conectados.

Traza el flujo completo de datos antes del despliegue
Representa el flujo real desde la persona que utiliza el sistema hasta cada componente que podría tratar información. Incluye la aplicación de IA, el punto de acceso al modelo, la base de datos, el almacenamiento de archivos, el proxy inverso, las herramientas conectadas, los servicios de analítica o monitorización y el destino de las copias de seguridad. Cuando corresponda, añade las vías de acceso de personas, como la administración, el soporte y la investigación de incidentes.
Marca cada conexión como local al despliegue o externa, e indica quién opera cada destino. «Local» debe significar local a la máquina o al entorno pertinente, no simplemente «accesible mediante una interfaz que parece local». Confirma el punto de acceso configurado y el modelo o servicio al que realmente llama.
Hazlo para cada función que tengas previsto utilizar. El chat, la búsqueda de documentos, la carga de archivos, la recuperación de información y las integraciones pueden seguir rutas diferentes. No des por sentado que el tratamiento de datos de una función sigue las mismas reglas que el chat habitual.
- Dibuja flechas para las solicitudes, las respuestas, la sincronización, el registro y las copias de seguridad.
- Etiqueta cada destino con su operador, entorno y propósito.
- Anota qué conexiones son opcionales y si desactivarlas modifica el flujo de trabajo.
- Contrasta la configuración y el comportamiento de la red con la documentación vigente del producto; no te bases en una etiqueta comercial o en una configuración predeterminada como prueba.

Haz un inventario de los datos, no solo de los documentos
Enumera la información que entra en el flujo de trabajo, que se deriva de ella o que este genera. La carga de un documento puede dar lugar a texto extraído, fragmentos, vectores de representación, resultados de búsqueda, instrucciones que incluyen pasajes recuperados y respuestas generadas. La existencia de cada elemento depende de la aplicación y su configuración, así que verifícala en lugar de darla por sentada.
Incluye los metadatos operativos habituales. Un servicio puede registrar marcas de tiempo, identificadores de cuenta, rutas de solicitud, detalles de errores, selección del modelo o información de uso. Los registros pueden contener más información de la prevista si las solicitudes o los errores incluyen valores sensibles.
Para cada tipo de dato, describe su sensibilidad, propósito y destino, y si el flujo de trabajo realmente lo necesita.
- Entradas: instrucciones, texto pegado, archivos cargados, imágenes e información recuperada de fuentes conectadas.
- Datos derivados: texto extraído, fragmentos, vectores de representación, índices, contenido en caché y resúmenes, si el sistema los genera.
- Salidas: respuestas generadas, citas o pasajes recuperados y archivos creados por la aplicación.
- Datos operativos: registros de la aplicación, registros de acceso del proxy, analítica, informes de errores, metadatos de uso y registros administrativos.
- Copias: contenidos de bases de datos, volúmenes de archivos, instantáneas, exportaciones y copias de seguridad.
Verifica las condiciones de tratamiento y conservación de cada destino
Para cada servicio del mapa, consulta la documentación oficial vigente y el contrato aplicable. Anota qué recibe el servicio, dónde se realiza el tratamiento, qué regiones o subencargados pueden intervenir, cuánto tiempo se conserva la información, quién puede acceder a ella, cómo funciona su eliminación y si los datos pueden utilizarse para otros fines.
No consideres que una declaración general de un proveedor responde por completo a todas las preguntas sobre cada función. Por ejemplo, la documentación de la plataforma de OpenAI (https://platform.openai.com/docs/models/default-usage-policies-by-endpoint) distingue los registros de supervisión para detectar usos indebidos del estado de la aplicación y presenta información y controles de conservación según el punto de acceso. Revisa el punto de acceso y la función exactos que utiliza tu aplicación.
Si los datos personales están sujetos al RGPD, entre los aspectos pertinentes se encuentran la minimización de datos, la limitación del plazo de conservación, la seguridad, los destinatarios y las transferencias. La guía de la Comisión Europea sobre los principios del RGPD (https://commission.europa.eu/law/law-topic/data-protection/information-business-and-organisations/principles-gdpr_en) aborda estos principios y la información de transparencia. Cuando un proveedor trate datos personales por cuenta de un responsable del tratamiento, comprueba el contrato de encargado aplicable y su alcance, incluidas las condiciones para recurrir a otro encargado conforme al artículo 28 del RGPD (https://eur-lex.europa.eu/eli/reg/2016/679/oj/). Esta es una lista de comprobación operativa, no sustituye al asesoramiento jurídico.
- Tratamiento: ¿qué datos se envían, para qué función y en qué región o entorno?
- Conservación y eliminación: ¿qué información persiste, durante cuánto tiempo y qué sucede con las copias de seguridad o los datos derivados tras su eliminación?
- Acceso y reutilización: ¿quién puede acceder a los datos y se utilizan para entrenar modelos, mejorar el servicio, supervisar usos indebidos o algún otro propósito?
- Contrato y subencargados: ¿qué condiciones se aplican a tu cuenta y caso de uso, y cómo se contempla a otros encargados?
- Evidencias: guarda la versión de la documentación o el contrato que revisaste, la fecha y las preguntas que sigan sin respuesta.
Incluye los registros, las copias de seguridad y otras copias operativas
Aunque una instrucción no esté en la base de datos principal del chat, puede aparecer en otros lugares. Comprueba los registros de la aplicación, los registros de acceso del proxy inverso, la analítica, los informes de errores, los flujos de trabajo de soporte, las exportaciones de bases de datos, el almacenamiento persistente de archivos y las copias de seguridad. Identifica tanto las copias automatizadas como las que las personas pueden crear durante la resolución de problemas.
Docker describe los volúmenes como almacenes de datos persistentes (https://docs.docker.com/engine/storage/volumes/) y ofrece procedimientos para respaldarlos y restaurarlos. Su documentación sobre controladores de registro (https://docs.docker.com/engine/logging/configure/) describe controladores que pueden enviar los registros de contenedores a destinos locales o externos. La documentación de Traefik sobre registros de acceso (https://doc.traefik.io/traefik/observe/logs-and-access-logs/) describe campos y encabezados de solicitudes configurables, incluidas opciones para conservarlos, descartarlos o censurarlos. Inspecciona tu configuración real en lugar de dar por sentado que los registros son inocuos o locales.
Para las copias de seguridad, determina qué incluyen, dónde se guardan, quién puede acceder a ellas, cuánto tiempo se conservan y cómo se gestionan las solicitudes de eliminación. Confirma esos detalles para el servicio y el plan que utilizas realmente.
- Inspecciona la configuración de registro en busca de cuerpos de solicitudes, encabezados, parámetros de consulta, detalles de errores y destinos externos de registros.
- Comprueba si los volúmenes persistentes contienen cargas de archivos, índices, historial de chats u otros datos de estado de la aplicación.
- Documenta el alcance, el destino, el acceso, la programación, la conservación, el proceso de restauración y el comportamiento de eliminación de las copias de seguridad.
- Revisa las vías de acceso del soporte y los administradores, incluido cómo se concede y revoca el acceso.
Prueba el flujo de trabajo real con datos representativos
La documentación describe el comportamiento previsto; una prueba controlada ayuda a determinar qué hace realmente la configuración desplegada. Utiliza contenido sintético o autorizado, no registros sensibles de clientes, hasta que comprendas el flujo de datos y las condiciones aplicables.
Envía una frase de prueba distintiva por cada flujo de trabajo y comprueba los destinos que puedes inspeccionar: registros de la aplicación, almacenamiento persistente, registros configurados, registros del proxy, servicios conectados y configuración del punto de acceso al modelo. Si no puedes inspeccionar directamente un destino, pide evidencias o aclaraciones a su operador. Prueba también la eliminación y distingue entre borrar los datos de la aplicación activa y el vencimiento de las copias de seguridad u otras copias conservadas.
HTTPS protege el tráfico frente a determinados riesgos durante el tránsito (https://letsencrypt.org/docs/why-all-https/), pero no determina qué sucede después de que un servicio recibe los datos. Trata la seguridad del transporte, la ubicación del tratamiento, la conservación y el acceso como comprobaciones distintas.
- Realiza una prueba por función: chat, carga de archivos, recuperación de documentos, integraciones y cualquier opción de exportación o uso compartido.
- Verifica el punto de acceso y la configuración reales del modelo; una dirección de API local no demuestra por sí sola que la inferencia sea local.
- Busca la frase o el archivo de prueba en los sistemas que administras y anota qué destinos no puedes inspeccionar.
- Prueba la eliminación y la recuperación de datos, incluido si estos siguen en copias de seguridad o servicios externos.
- Repite la comprobación tras cambios sustanciales de configuración o si cambian las condiciones de un proveedor.
Convierte la incertidumbre en decisiones y reglas operativas
Algunas preguntas quedarán sin respuesta porque la documentación pública de un proveedor quizá no cubra tu cuenta, punto de acceso o contrato concretos. Registra esas lagunas en lugar de convertir una suposición en una afirmación sobre privacidad. Asigna una persona responsable y una fecha límite, e identifica qué datos pueden utilizarse mientras la pregunta siga pendiente.
Define reglas que se ajusten a las evidencias: qué información está permitida, qué información debe eliminarse o enmascararse, qué flujos de trabajo están prohibidos y quién puede aprobar excepciones. Haz que las reglas sean útiles para las personas que introducen información, no solo para el equipo que desplegó el sistema.
Si se trata de datos personales, ajusta el propósito documentado, la minimización de datos, la conservación, la seguridad, los destinatarios y las transferencias a las obligaciones que se aplican a tu organización. Conserva un registro de los sistemas y las condiciones revisados para poder evaluar los cambios más adelante.
- Asigna a cada flujo un estado sencillo: verificado, permitido con condiciones, bloqueado o aún en revisión.
- Designa responsables para la configuración de los puntos de acceso, las condiciones de los proveedores, los registros, las copias de seguridad, el acceso y las indicaciones para los usuarios.
- Establece una regla clara para los datos sensibles mientras siga sin respuesta cualquier pregunta importante.
- Revisa el mapa al añadir un proveedor de modelos, una integración, una nueva fuente de datos, un destino de registros o una ruta de copias de seguridad.
Elige el modelo de despliegue que cumpla los requisitos verificados
Autoalojar la aplicación puede darte control sobre el entorno de la aplicación, pero no garantiza que todas las llamadas al modelo o copias operativas permanezcan allí. Un servicio de modelos operado externamente puede ser adecuado si las condiciones específicas del punto de acceso, el tratamiento, la conservación y el contrato se ajustan a tus obligaciones. La inferencia operada localmente puede convenir cuando se requiere que el procesamiento del modelo sea local, pero verifica la ruta de las solicitudes y el almacenamiento, los registros y los controles de acceso circundantes.
Compara los modelos según las evidencias, no las etiquetas. Si un requisito establece que los datos no deben salir de un entorno determinado, define qué componentes quedan dentro de ese límite y prueba el flujo de trabajo configurado. Si no puedes verificar una condición obligatoria, no envíes los datos afectados a través del sistema hasta obtener una respuesta adecuada o una alternativa aprobada.
Airbip ofrece despliegues gestionados de aplicaciones de su catálogo público, con instancias que se ejecutan como cargas de trabajo Docker en servidores en la nube de Airbip. Automatiza el enrutamiento y los certificados TLS mediante Traefik y Let’s Encrypt, y ofrece copias de seguridad diarias, semanales y mensuales configurables. Estas capacidades pueden ayudar con la infraestructura de las aplicaciones y las tareas de ciclo de vida, pero por sí solas no determinan dónde procesa los datos un modelo externo, cuáles son las condiciones de conservación de un servicio conectado ni cómo se trata cada copia de seguridad. Consulta la información vigente de los productos de Airbip y las condiciones aplicables para conocer los detalles pertinentes a tu despliegue.
- Elige el alojamiento de la aplicación según quién deba operar la infraestructura y qué responsabilidades de administración puedes asumir.
- Elige un punto de acceso al modelo según los requisitos verificados de tratamiento, conservación, acceso, eliminación y contrato.
- Elige la inferencia local solo después de verificar la ruta del modelo y tener en cuenta el almacenamiento local, los registros, las copias de seguridad y el acceso administrativo.
- Si no se puede demostrar el límite requerido para los datos, no los incluyas en el flujo de trabajo o elige otro modelo de despliegue.
Preguntas frecuentes
¿Autoalojar una aplicación de IA significa que las instrucciones permanecen en mi servidor?
No necesariamente. La aplicación puede enviar las instrucciones a un punto de acceso al modelo independiente. Comprueba la ruta configurada y la documentación vigente para el modelo y la función concretos.
¿Qué debo revisar además de las instrucciones y los archivos cargados?
Haz un inventario de los datos derivados, como el texto extraído y los vectores de representación, si se generan; las respuestas, los registros, la analítica, los informes de errores, el almacenamiento persistente, las exportaciones y las copias de seguridad. La lista exacta depende de la aplicación y su configuración.
¿HTTPS demuestra que los datos son privados?
No. HTTPS protege el tráfico frente a determinados riesgos durante el tránsito. No determina la ubicación del tratamiento de un servicio, sus prácticas de acceso, la conservación, la eliminación ni las condiciones de reutilización.
¿Qué hago si la documentación de un proveedor no responde a una pregunta importante?
Registra la laguna, pide al proveedor documentación aplicable o aclaraciones contractuales y evita enviar datos que dependan de esa respuesta hasta resolverla. Mientras tanto, utiliza un conjunto de datos de prueba de menor riesgo.
Fuentes y lecturas adicionales
- Volumes: Back up, restore, or migrate data volumes — Docker
- Configure logging drivers — Docker
- Logs and Access Logs — Traefik Labs
- Data controls in the OpenAI platform — OpenAI
- Principles of personal data processing under the GDPR — European Commission
- Regulation (EU) 2016/679, Article 28 — EUR-Lex
- Ollama API introduction — Ollama
- Ollama API authentication — Ollama
- Why All Websites Should Use HTTPS — Internet Security Research Group (Let's Encrypt)