¿Un servidor o dos? Cómo ubicar una aplicación de IA y su servicio de inferencia
Compara las implementaciones en el mismo servidor y en servidores separados: identifica los componentes, los flujos de datos y las responsabilidades operativas, y luego evalúa cada opción según tus propios requisitos.
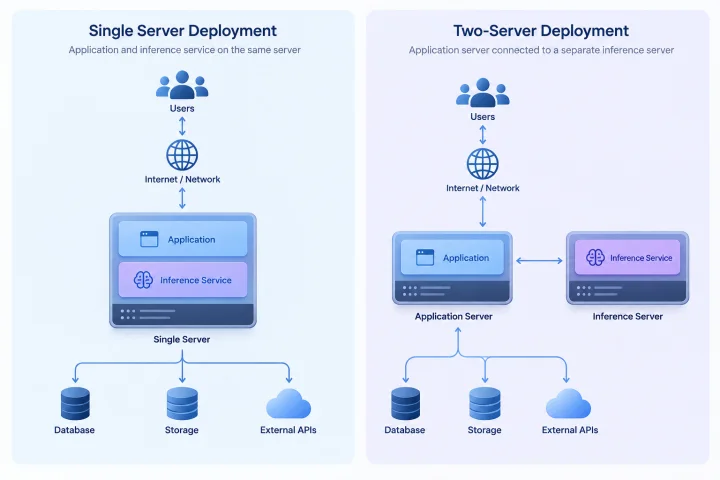
Empieza por los dos patrones de implementación
En un diseño con servicios en el mismo servidor, la aplicación de IA con la que interactúan los usuarios y el servicio que ejecuta la inferencia del modelo comparten un servidor. Aun así, pueden ser procesos de software o contenedores independientes, pero utilizan el mismo host.
En un diseño con servicios separados, la aplicación envía solicitudes de inferencia a un servicio alojado en otro servidor o en un endpoint administrado. Microsoft describe un patrón en el que clientes remotos comparten un endpoint de modelo operado de forma centralizada ([documentación de Microsoft](https://learn.microsoft.com/en-us/windows-server/ai/local-ai-inference)). Esto respalda ese patrón concreto; no compara las dos arquitecturas ni establece cuál es preferible.
Las preguntas que siguen te ayudan a investigar tus propios requisitos; no son recomendaciones universales sobre qué topología ofrece mejor rendimiento o es más fácil de operar.
- Mismo servidor: ¿qué implicaría compartir un host para los recursos, el mantenimiento y los planes de recuperación?
- Servidores separados: ¿de qué red, endpoint y acuerdos de responsabilidad dependería la aplicación?

Identifica los componentes y las cuestiones que debes investigar
Representa el sistema como componentes y conexiones, no solo como una lista de servidores. Incluye la aplicación con la que interactúan los usuarios, el entorno de ejecución de inferencia, los archivos del modelo, la base de datos, el almacenamiento de archivos u objetos, las API externas, los sistemas de identidad y los procesos en segundo plano. Indica qué componentes necesita cada solicitud y cuáles son opcionales.
Para cada componente, anota dónde se ejecuta, quién lo mantiene, qué recursos utiliza y qué experimentarían los usuarios si no estuviera disponible. Son aspectos que debes verificar según la configuración compatible con tu aplicación y tus requisitos operativos; no son conclusiones que se deriven de elegir una u otra arquitectura.
Anota las tareas que realizan los usuarios, la concurrencia prevista y si las solicitudes llegan en ráfagas. Si desconoces estos valores, trátalos como preguntas para un proyecto piloto en vez de completarlos con estimaciones genéricas de rendimiento.
- Enumera la aplicación, el servicio de inferencia, la base de datos, el almacenamiento, las tareas programadas y las API externas.
- Para cada conexión, registra su propósito, dirección, credenciales y comportamiento previsto cuando la dependencia no esté disponible.
- Identifica posibles solapamientos de recursos que debas investigar, como el uso de la misma capacidad de CPU, memoria, acelerador, disco o red por parte de la actividad de la aplicación y la ejecución del modelo.
- Anota dónde se almacenan los archivos del modelo, las instrucciones, los documentos cargados, las respuestas generadas y los registros de la aplicación.

Preguntas para un diseño con servicios en el mismo servidor
Esta opción puede ser una posibilidad si estás pensando en mantener ambos servicios en un mismo host. Antes de decidir, investiga si la aplicación admite la conexión prevista, si los archivos del modelo caben en tu plan de almacenamiento y si tu equipo puede supervisar y recuperar ambos componentes.
Pregunta qué ocurriría si la actividad de la aplicación y la inferencia compitieran por los recursos, o si un mantenimiento o problema del host afectara a ambos servicios. La respuesta depende de tu configuración y de la experiencia de usuario que consideres aceptable; la arquitectura por sí sola no permite determinar el impacto.
- ¿Es aceptable que la actividad de la aplicación y la inferencia compartan un host y sus periodos de mantenimiento?
- ¿Cómo comprobarás el comportamiento de la aplicación mientras se ejecutan tareas de inferencia representativas?
- ¿Qué deberían experimentar los usuarios si la inferencia está ocupada o no disponible? ¿Podrán seguir usando las funciones de la aplicación que no dependen de la IA?
Preguntas para un diseño con servicios separados
Un servicio de inferencia independiente crea una frontera de servicio y de red distinta. Investiga si esa separación responde a un requisito concreto, como disponer de acuerdos de mantenimiento, gestión de recursos o administración diferentes. La separación por sí sola no garantiza aislamiento, seguridad ni un mejor rendimiento.
Microsoft documenta un endpoint de inferencia operado de forma centralizada y compartido por clientes remotos. Si estás valorando ese patrón, verifica quién puede llamar al endpoint, cómo se concede y revoca el acceso y si las aplicaciones podrían enviar las mismas categorías de datos.
Considera qué debería hacer la aplicación si no puede acceder al endpoint, las credenciales no son válidas o el endpoint devuelve un error. Al evaluar el diseño, asigna responsabilidades para la supervisión, el mantenimiento y la recuperación del endpoint.
- ¿A qué requisito respondería una frontera de servicio independiente?
- ¿Quién es responsable del endpoint, el control de acceso, el mantenimiento y la respuesta a incidentes?
- ¿Cómo se gestionarán y comunicarán a los usuarios los errores de red y del endpoint?
Sigue el recorrido de los datos y las responsabilidades
Dibuja el recorrido de los datos para una tarea real. Puede incluir la entrada del usuario, las instrucciones de la aplicación, documentos recuperados u otro contexto, una solicitud al servicio de inferencia y una respuesta. El recorrido real depende de la aplicación y de su configuración, así que verifica qué se envía en lugar de darlo por sentado.
Para cada elemento de datos, pregunta si cruza una frontera de servicio, dónde se procesa y si se almacena en los registros de la aplicación, los registros del servicio, las copias de seguridad u otro sistema. No deduzcas cómo funcionan los registros o la retención a partir de dónde se ejecutan los servicios.
Anota quién puede acceder a los datos y las credenciales, qué ajustes de retención se aplican y cómo se gestionan las copias de seguridad. Revisa por separado las llamadas a API externas: un diseño con dos servidores no implica que todo el procesamiento permanezca dentro de esos servidores.
- Sigue por separado las entradas, el contexto recuperado, los archivos adjuntos, las salidas, los identificadores y las credenciales.
- Para cada componente, verifica qué se puede registrar, qué se conserva, quién puede acceder y durante cuánto tiempo se guarda.
- Confirma qué datos y configuración de la aplicación se incluyen en las copias de seguridad; documenta por separado cómo se gestionan los archivos del modelo y otros recursos de gran tamaño.
- Asigna responsables de las decisiones sobre datos, acceso y retención.
Haz una prueba piloto para responder a las preguntas pendientes
Una prueba piloto puede ayudarte a evaluar tu aplicación, la configuración del modelo, los datos y las condiciones operativas. Las afirmaciones genéricas sobre pruebas de rendimiento no permiten determinar si tus propias tareas, patrón de concurrencia o expectativas ante fallos serán aceptables.
Ejecuta tareas representativas en la arquitectura o las arquitecturas que estés valorando. Incluye el uso habitual y el periodo de mayor actividad realista que puedas reproducir. Decide de antemano qué vas a observar —por ejemplo, el comportamiento de la aplicación, la finalización de la inferencia, el uso de recursos y la idoneidad de los resultados— y define criterios de aceptación para tu caso de uso.
Si el entorno lo permite, prueba fallos pertinentes en condiciones controladas: por ejemplo, un endpoint no disponible, una interrupción de la ruta de red o credenciales no válidas. Registra el comportamiento observado y los pasos de recuperación en vez de asumir cómo responderá el sistema.
- Elige tareas y entradas representativas, incluidos los pasos pertinentes de recuperación de documentos o uso de API externas.
- Prueba el patrón de uso previsto y cualquier actividad concurrente realista que puedas reproducir.
- Observa el comportamiento de la aplicación y de la inferencia mientras se procesan las solicitudes.
- Define de antemano criterios de aceptación que incluyan la finalización de las tareas, la experiencia de usuario, el tratamiento de datos y la capacidad de recuperación.
- Registra la configuración, los supuestos y los resultados para poder compararlos después de hacer cambios.
Documenta la decisión y revísala cuando cambien los requisitos
Registra la topología elegida, los requisitos que pretende satisfacer y los supuestos en los que se basa la decisión. Incluye responsables de los componentes, flujos de datos, comportamiento ante fallos relevantes y resultados de las pruebas piloto. Revisa la decisión si cambian la carga de trabajo, los acuerdos de mantenimiento, los requisitos de acceso o las expectativas de recuperación; evalúa el nuevo requisito en vez de dar por sentado que un diseño más grande es automáticamente mejor.
Airbip ofrece la implementación administrada de aplicaciones del catálogo como cargas de trabajo Docker en servidores en la nube de Airbip, con enrutamiento automatizado y certificados TLS mediante Traefik y Let’s Encrypt, comprobaciones de DNS, gestión del ciclo de vida de los servicios y copias de seguridad diarias, semanales y mensuales configurables. Estas capacidades de infraestructura no determinan dónde debe ejecutarse un servicio de inferencia concreto ni eliminan la responsabilidad del cliente en las decisiones sobre datos, acceso y gobernanza. Antes de elegir un modelo de implementación, confirma que la configuración deseada de la aplicación y la organización del servicio de inferencia se ajustan a tus requisitos.
- La arquitectura elegida y el requisito que pretende satisfacer.
- Los supuestos sobre la carga de trabajo, la concurrencia, la ubicación de los datos y las dependencias externas.
- Los datos que cruzan las fronteras de servicio, las decisiones de retención y los responsables del acceso.
- Las responsabilidades, el comportamiento ante fallos relevantes, el procedimiento de recuperación y los resultados de las pruebas piloto.
- Las condiciones que motivarían una revisión de la decisión.
Preguntas frecuentes
¿Un servidor de inferencia independiente siempre mejora el rendimiento?
No hay pruebas disponibles que establezcan una ventaja de rendimiento general. La separación cambia la disposición de los servicios e introduce una dependencia de red. Evalúa las opciones con tu aplicación, tu configuración y tareas representativas.
¿Que los servicios compartan un servidor es automáticamente más seguro?
No. La ubicación por sí sola no resuelve el control de acceso, la retención de datos ni la gobernanza. Verifica qué datos se trasladan entre componentes, quién puede acceder y cómo se gestionan las credenciales y los registros.
¿Qué debemos probar antes de elegir una arquitectura?
Utiliza tareas representativas y el patrón de uso previsto. Decide de antemano qué observarás y qué considerarás aceptable. Cuando corresponda, prueba el comportamiento ante fallos y la recuperación en un entorno controlado.
¿Puede un endpoint de inferencia servir a varias aplicaciones?
Microsoft describe un endpoint de modelo operado de forma centralizada que pueden compartir clientes remotos ([documentación](https://learn.microsoft.com/en-us/windows-server/ai/local-ai-inference)). Que ese patrón se adapte a tu configuración depende de la compatibilidad de las aplicaciones, los controles de acceso, las políticas de datos y las responsabilidades operativas.
¿El alojamiento administrado de aplicaciones determina dónde se ejecuta la inferencia?
No por sí solo. Airbip gestiona la implementación de aplicaciones del catálogo y ofrece capacidades de infraestructura como enrutamiento, automatización de TLS, comprobaciones de DNS, gestión del ciclo de vida de los servicios y copias de seguridad configurables. Confirma por separado que la organización prevista para la inferencia y la configuración de la aplicación cumplen tus requisitos.