Self-Hosting von KI bedeutet nicht automatisch Datenschutz: Checkliste zum Datenfluss
Wenn Sie eine KI-Anwendung selbst hosten, ist damit nicht bewiesen, dass Prompts, Dateien, Protokolle oder Backups auf Ihrer Infrastruktur bleiben. Verfolgen Sie jeden Datenpfad und prüfen Sie jedes Ziel, bevor Sie sensible Informationen verwenden.
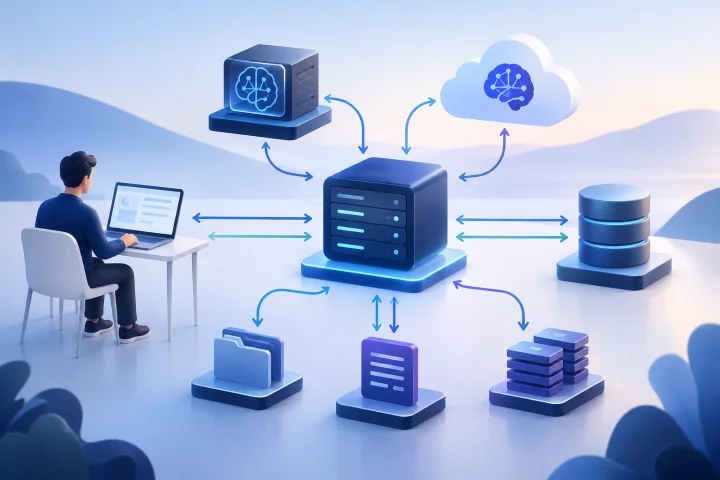
Self-Hosting beschreibt eine Bereitstellungsentscheidung, kein vollständiges Datenschutzergebnis
Eine selbst gehostete KI-Anwendung läuft auf einer Infrastruktur, die Sie oder ein Hosting-Anbieter bereitstellen. Allein daraus geht nicht hervor, wo die Inferenz stattfindet, welche Dienste Daten erhalten, was aufbewahrt wird oder wer auf betriebliche Kopien zugreifen kann.
Betrachten Sie die Anwendung und den Modellendpunkt als getrennte Systemteile. Ollamas API-Einführung (https://github.com/ollama/ollama/blob/main/docs/api/introduction.mdx) beschreibt sowohl eine lokale API-Adresse als auch eine Cloud-API-Basis-URL. In der Dokumentation zur Authentifizierung (https://github.com/ollama/ollama/blob/main/docs/api/authentication.mdx) wird außerdem erläutert, dass Cloud-Modellanfragen über die lokale API gestellt werden können. Eine Anfrage an eine lokale Schnittstelle ist für sich genommen kein Beleg dafür, dass die Modellverarbeitung lokal stattfindet.
Die richtige Frage lautet nicht einfach: „Ist das selbst gehostet?“ Fragen Sie stattdessen: „Welche Systeme verarbeiten oder speichern bei diesem Arbeitsablauf und diesen Datentypen Informationen, unter welchen Bedingungen und wie können wir das überprüfen?“
- Anwendungs-Hosting: Wo laufen die für Nutzer sichtbare Oberfläche und die unterstützenden Dienste?
- Modell-Hosting: Wo findet die Inferenz statt und welcher Endpunkt erhält die Anfragen?
- Datenverarbeitung: Was wird gespeichert, protokolliert, gesichert, übertragen oder Betreibern und verbundenen Diensten zugänglich gemacht?

Zeichnen Sie vor der Bereitstellung den vollständigen Datenpfad auf
Erfassen Sie den tatsächlichen Arbeitsablauf von der Person, die das System nutzt, bis hin zu allen Komponenten, die Informationen verarbeiten könnten. Berücksichtigen Sie die KI-Anwendung, den Modellendpunkt, die Datenbank, den Dateispeicher, den Reverse-Proxy, verbundene Tools, Analyse- oder Überwachungsdienste und den Backup-Speicherort. Ergänzen Sie gegebenenfalls menschliche Zugriffspfade wie Administration, Support und die Untersuchung von Sicherheitsvorfällen.
Kennzeichnen Sie jede Verbindung als lokal innerhalb der Bereitstellung oder extern und notieren Sie, wer das jeweilige Ziel betreibt. „Lokal“ sollte bedeuten, dass etwas auf der betreffenden Maschine oder in der jeweiligen Umgebung lokal ist – nicht einfach, dass es über eine lokal wirkende Schnittstelle erreicht wird. Prüfen Sie den konfigurierten Endpunkt sowie das Modell oder den Dienst, den er tatsächlich aufruft.
Erfassen Sie jeden Funktionsbereich, den Sie verwenden möchten, separat. Chat, Dokumentsuche, Datei-Upload, Abruf und Integrationen können unterschiedliche Datenpfade haben. Gehen Sie nicht davon aus, dass für die Datenverarbeitung einer Funktion dieselben Regeln gelten wie für gewöhnliche Chats.
- Zeichnen Sie Pfeile für Anfragen, Antworten, Synchronisierung, Protokollierung und Backups ein.
- Beschriften Sie jedes Ziel mit Betreiber, Umgebung und Zweck.
- Notieren Sie, welche Verbindungen optional sind und ob eine Deaktivierung den Arbeitsablauf verändert.
- Prüfen Sie die Konfiguration und das Netzwerkverhalten anhand der aktuellen Produktdokumentation. Verlassen Sie sich nicht auf eine Produktbezeichnung oder eine Standardeinstellung als Nachweis.

Erfassen Sie die Daten, nicht nur die Dokumente
Listen Sie die Informationen auf, die in den Arbeitsablauf einfließen, daraus abgeleitet oder darin erzeugt werden. Aus einem hochgeladenen Dokument können extrahierter Text, Textabschnitte, Embeddings, Suchergebnisse, Prompts mit abgerufenen Passagen und generierte Antworten entstehen. Ob die einzelnen Elemente tatsächlich anfallen, hängt von Anwendung und Konfiguration ab. Prüfen Sie es daher, statt es vorauszusetzen.
Berücksichtigen Sie auch gewöhnliche Betriebsmetadaten. Ein Dienst kann Zeitstempel, Konto-IDs, Anfragepfade, Fehlerdetails, die Modellauswahl oder Nutzungsinformationen protokollieren. Protokolle können mehr enthalten, als Teams erwarten, wenn Anfragen oder Fehler sensible Werte enthalten.
Beschreiben Sie für jeden Datentyp seine Sensibilität, seinen Zweck und sein Ziel sowie, ob der Arbeitsablauf ihn überhaupt benötigt.
- Eingaben: Prompts, eingefügter Text, hochgeladene Dateien und Bilder sowie Informationen aus verbundenen Quellen.
- Abgeleitete Daten: extrahierter Text, Textabschnitte, Embeddings, Indizes, zwischengespeicherte Inhalte und Zusammenfassungen, sofern das System sie erstellt.
- Ausgaben: generierte Antworten, Quellenangaben oder abgerufene Passagen sowie von der Anwendung erstellte Dateien.
- Betriebsdaten: Anwendungsprotokolle, Zugriffsprotokolle des Proxys, Analysen, Fehlerberichte, Nutzungsmetadaten und Verwaltungsaufzeichnungen.
- Kopien: Datenbankinhalte, Dateivolumes, Snapshots, Exporte und Backups.
Prüfen Sie die Bedingungen zur Verarbeitung und Aufbewahrung für jedes Ziel
Prüfen Sie für jeden Dienst in der Übersicht die aktuelle Primärdokumentation und den geltenden Vertrag. Halten Sie fest, welche Daten der Dienst erhält, wo die Verarbeitung stattfindet, welche Regionen oder Unterauftragsverarbeiter beteiligt sein können, wie lange Informationen gespeichert werden, wer darauf zugreifen kann, wie die Löschung funktioniert und ob Daten für andere Zwecke verwendet werden dürfen.
Behandeln Sie eine allgemeine Erklärung eines Anbieters nicht als vollständige Antwort für alle Funktionen. Die Plattformdokumentation von OpenAI (https://platform.openai.com/docs/models/default-usage-policies-by-endpoint) unterscheidet beispielsweise zwischen Protokollen zur Missbrauchsüberwachung und dem Anwendungsstatus und enthält Informationen und Kontrollmöglichkeiten zur Aufbewahrung je nach Endpunkt. Prüfen Sie den konkreten Endpunkt und die Funktion, die Ihre Anwendung verwendet.
Wenn personenbezogene Daten der DSGVO unterliegen, sind unter anderem Datenminimierung, Speicherbegrenzung, Sicherheit, Empfänger und Übermittlungen relevant. Die Erläuterungen der Europäischen Kommission zu den DSGVO-Grundsätzen (https://commission.europa.eu/law/law-topic/data-protection/information-business-and-organisations/principles-gdpr_en) behandeln diese Grundsätze und die Informationspflichten zur Transparenz. Verarbeitet ein Anbieter personenbezogene Daten im Auftrag eines Verantwortlichen, prüfen Sie den anwendbaren Auftragsverarbeitungsvertrag und seinen Geltungsbereich, einschließlich der Bedingungen für die Beauftragung weiterer Auftragsverarbeiter nach Artikel 28 der DSGVO (https://eur-lex.europa.eu/eli/reg/2016/679/oj/). Diese Checkliste dient der betrieblichen Prüfung und ersetzt keine Rechtsberatung.
- Verarbeitung: Welche Daten werden für welche Funktion und in welcher Region oder Umgebung übermittelt?
- Aufbewahrung und Löschung: Was bleibt gespeichert und wie lange? Was geschieht nach einer Löschung mit Backups oder abgeleiteten Daten?
- Zugriff und Wiederverwendung: Wer kann auf die Daten zugreifen und werden sie für Training, Serviceverbesserung, Missbrauchsüberwachung oder einen anderen Zweck verwendet?
- Vertrag und Unterauftragsverarbeiter: Welche Bedingungen gelten für Ihr Konto und Ihren Anwendungsfall, und wie werden weitere Auftragsverarbeiter berücksichtigt?
- Nachweise: Bewahren Sie die geprüfte Dokumentationsversion oder den Vertrag, das Prüfdatum und alle noch offenen Fragen auf.
Berücksichtigen Sie Protokolle, Backups und weitere Betriebskopien
Ein Prompt kann in der Hauptdatenbank des Chats fehlen und trotzdem an anderer Stelle auftauchen. Prüfen Sie Anwendungsprotokolle, Zugriffsprotokolle des Reverse-Proxys, Analysen, Fehlerberichte, Supportabläufe, Datenbankexporte, persistenten Dateispeicher und Backups. Erfassen Sie sowohl automatisch erstellte Kopien als auch Kopien, die Mitarbeitende bei der Fehlerbehebung anlegen können.
Docker beschreibt Volumes als Speicher für persistente Daten (https://docs.docker.com/engine/storage/volumes/) und stellt Verfahren für ihre Sicherung und Wiederherstellung bereit. Die Dokumentation zu Docker-Logging-Treibern (https://docs.docker.com/engine/logging/configure/) beschreibt Treiber, mit denen Container-Protokolle an lokale oder externe Ziele gesendet werden können. Die Dokumentation der Zugriffsprotokolle von Traefik (https://doc.traefik.io/traefik/observe/logs-and-access-logs/) erläutert konfigurierbare Anfragefelder und Header, einschließlich Optionen zum Beibehalten, Entfernen oder Schwärzen von Feldern. Prüfen Sie Ihre tatsächliche Konfiguration, statt anzunehmen, Protokolle seien unbedenklich oder lokal.
Klären Sie bei Backups, was darin enthalten ist, wo sie gespeichert werden, wer darauf zugreifen kann, wie lange sie aufbewahrt werden und wie Löschanfragen gehandhabt werden. Bestätigen Sie diese Angaben für den Dienst und den Tarif, den Sie tatsächlich nutzen.
- Prüfen Sie die Protokollierungskonfiguration auf Anfrageinhalte, Header, Abfrageparameter, Fehlerdetails und externe Protokollziele.
- Prüfen Sie, ob persistente Volumes Uploads, Indizes, Chatverläufe oder andere Anwendungsdaten enthalten.
- Dokumentieren Sie Umfang, Ziel, Zugriff, Zeitplan, Aufbewahrung, Wiederherstellungsprozess und Löschverhalten der Backups.
- Prüfen Sie Support- und Administratorzugriffe, einschließlich der Vergabe und Entziehung von Zugriffsrechten.
Testen Sie den tatsächlichen Arbeitsablauf mit repräsentativen Daten
Die Dokumentation beschreibt das vorgesehene Verhalten. Ein kontrollierter Test hilft festzustellen, was Ihre bereitgestellte Konfiguration tatsächlich tut. Verwenden Sie synthetische oder genehmigte Testinhalte und keine sensiblen Kundendaten, bis der Datenpfad und die geltenden Bedingungen geklärt sind.
Senden Sie für jeden Arbeitsablauf eine eindeutige Testphrase und prüfen Sie die Ziele, die Sie einsehen können: Anwendungsdatensätze, persistenten Speicher, konfigurierte Protokolle, Proxy-Protokolle, verbundene Dienste und Einstellungen des Modellendpunkts. Wenn Sie ein Ziel nicht direkt einsehen können, bitten Sie dessen Betreiber um Nachweise oder Klarstellung. Testen Sie auch die Löschung und unterscheiden Sie zwischen der Entfernung aus der aktiven Anwendung und dem Ablauf der Aufbewahrungsfrist für Backups oder andere gespeicherte Kopien.
HTTPS schützt den Datenverkehr vor bestimmten Risiken bei der Übertragung (https://letsencrypt.org/docs/why-all-https/), belegt aber nicht, was geschieht, nachdem ein Dienst die Daten erhalten hat. Prüfen Sie Transportsicherheit, Verarbeitungsort, Aufbewahrung und Zugriff als getrennte Punkte.
- Führen Sie für jede Funktion einen eigenen Test durch: Chat, Datei-Upload, Dokumentabruf, Integrationen sowie alle Export- und Freigabepfade.
- Prüfen Sie den tatsächlichen Modellendpunkt und die Konfiguration.
- Suchen Sie in den von Ihnen verwalteten Systemen nach der Testphrase oder Testdatei und notieren Sie, welche Ziele Sie nicht einsehen können.
- Testen Sie Lösch- und Abrufverhalten, einschließlich der Frage, ob Daten in Backups oder externen Diensten verbleiben.
- Wiederholen Sie die Prüfung nach wesentlichen Konfigurationsänderungen oder wenn sich die Bedingungen eines Anbieters ändern.
Machen Sie aus Unsicherheit konkrete Entscheidungen und Betriebsregeln
Manche Fragen bleiben offen, weil die öffentliche Dokumentation eines Anbieters Ihr konkretes Konto, Ihren Endpunkt oder Ihren Vertrag möglicherweise nicht abdeckt. Halten Sie diese Lücken fest, statt eine Annahme als Datenschutzaussage auszugeben. Legen Sie eine verantwortliche Person und eine Frist fest und bestimmen Sie, welche Daten verwendet werden dürfen, solange die Frage ungeklärt ist.
Definieren Sie Regeln, die zur Faktenlage passen: Welche Informationen sind zulässig, welche müssen entfernt oder maskiert werden, welche Arbeitsabläufe sind untersagt und wer kann Ausnahmen genehmigen? Die Regeln sollten für die Personen verständlich sein, die Informationen eingeben, und nicht nur für das Team, das das System bereitgestellt hat.
Richten Sie bei personenbezogenen Daten den dokumentierten Zweck, die Datenminimierung, Aufbewahrung, Sicherheit, Empfänger und Übermittlungen an den für Ihre Organisation geltenden Pflichten aus. Halten Sie fest, welche Systeme und Bedingungen geprüft wurden, damit spätere Änderungen bewertet werden können.
- Verwenden Sie für jeden Datenfluss einen einfachen Status: verifiziert, unter Bedingungen zulässig, gesperrt oder noch in Prüfung.
- Benennen Sie Verantwortliche für die Endpunktkonfiguration, Anbieterbedingungen, Protokolle, Backups, Zugriffe und Nutzerhinweise.
- Legen Sie eine klare Regel für sensible Daten fest, solange eine wesentliche Frage unbeantwortet bleibt.
- Aktualisieren Sie die Übersicht, wenn Sie einen Modellanbieter, eine Integration, eine neue Datenquelle, ein Protokollziel oder einen Backup-Pfad hinzufügen.
Wählen Sie das Bereitstellungsmodell, das nachweislich Ihre Anforderungen erfüllt
Wenn Sie die Anwendung selbst hosten, können Sie die Anwendungsumgebung kontrollieren. Das garantiert jedoch nicht, dass jeder Modellaufruf oder jede Betriebskopie dort verbleibt. Ein extern betriebener Modelldienst kann geeignet sein, wenn seine endpunktspezifischen Bedingungen, die Verarbeitung, Aufbewahrung und sein Vertrag Ihren Pflichten entsprechen. Lokal betriebene Inferenz kann zu Anforderungen passen, die eine lokale Modellverarbeitung verlangen. Prüfen Sie den Anfragepfad sowie den umgebenden Speicher, die Protokolle und die Zugriffskontrollen.
Vergleichen Sie Modelle anhand von Nachweisen, nicht anhand von Bezeichnungen. Wenn eine Anforderung vorgibt, dass Daten eine bestimmte Umgebung nicht verlassen dürfen, klären Sie, welche Komponenten zu dieser Grenze gehören, und testen Sie den konfigurierten Arbeitsablauf. Können Sie eine geforderte Bedingung nicht verifizieren, leiten Sie die betroffenen Daten nicht durch das System, bis Sie eine geeignete Antwort oder eine genehmigte Alternative haben.
Airbip bietet die verwaltete Bereitstellung von Anwendungen aus seinem öffentlichen Katalog. Die Anwendungsinstanzen laufen als Docker-Workloads auf Airbip-Cloud-Servern. Airbip automatisiert Routing und TLS-Zertifikate über Traefik und Let’s Encrypt und bietet konfigurierbare tägliche, wöchentliche und monatliche Backups. Diese Funktionen können bei der Anwendungsinfrastruktur und den Aufgaben über den Lebenszyklus hinweg helfen, belegen aber für sich genommen weder, wo ein externes Modell Daten verarbeitet, noch die Aufbewahrungsbedingungen eines verbundenen Dienstes oder den Umgang mit jeder Backup-Kopie. Prüfen Sie die aktuellen Produktinformationen und geltenden Bedingungen von Airbip auf Einzelheiten, die für Ihre Bereitstellung relevant sind.
- Wählen Sie das Anwendungs-Hosting danach aus, wer die Infrastruktur betreiben soll und welche Verwaltungsaufgaben Sie übernehmen können.
- Wählen Sie einen Modellendpunkt anhand der nachgewiesenen Anforderungen an Verarbeitung, Aufbewahrung, Zugriff, Löschung und Verträge.
- Entscheiden Sie sich erst für lokale Inferenz, nachdem Sie den Modellpfad geprüft und lokalen Speicher, Protokolle, Backups und Administratorzugriffe berücksichtigt haben.
- Lässt sich die erforderliche Datengrenze nicht nachweisen, halten Sie die betreffenden Daten aus dem Arbeitsablauf heraus oder wählen Sie ein anderes Bereitstellungsmodell.
Häufige Fragen
Bedeutet das Selbst-Hosting einer KI-Anwendung, dass Prompts auf meinem Server bleiben?
Nicht unbedingt. Die Anwendung kann Prompts an einen separaten Modellendpunkt senden. Prüfen Sie den konfigurierten Pfad und die aktuelle Dokumentation für das konkrete Modell und die jeweilige Funktion.
Was sollte ich außer Prompts und hochgeladenen Dateien prüfen?
Erfassen Sie abgeleitete Daten wie extrahierten Text und Embeddings, sofern sie erstellt werden, sowie generierte Antworten, Protokolle, Analysen, Fehlerberichte, persistenten Speicher, Exporte und Backups. Die genaue Liste hängt von der Anwendung und ihrer Konfiguration ab.
Beweist HTTPS, dass Daten privat sind?
Nein. HTTPS schützt den Datenverkehr vor bestimmten Risiken bei der Übertragung. Es sagt nichts darüber aus, wo ein Dienst Daten verarbeitet, wie er Zugriffe handhabt, wie lange er Daten aufbewahrt, wie sie gelöscht werden oder ob sie wiederverwendet werden.
Was kann ich tun, wenn die Dokumentation eines Anbieters eine wichtige Frage nicht beantwortet?
Halten Sie die Lücke fest, bitten Sie den Anbieter um einschlägige Dokumentation oder eine vertragliche Klarstellung und übermitteln Sie keine Daten, deren Verwendung von dieser Antwort abhängt, bis die Frage geklärt ist. Verwenden Sie in der Zwischenzeit einen Testdatensatz mit geringerem Risiko.
Quellen und weiterführende Literatur
- Volumes: Back up, restore, or migrate data volumes — Docker
- Configure logging drivers — Docker
- Logs and Access Logs — Traefik Labs
- Data controls in the OpenAI platform — OpenAI
- Principles of personal data processing under the GDPR — European Commission
- Regulation (EU) 2016/679, Article 28 — EUR-Lex
- Ollama API introduction — Ollama
- Ollama API authentication — Ollama
- Why All Websites Should Use HTTPS — Internet Security Research Group (Let's Encrypt)