So legen Sie ein Datenbankverbindungsbudget für eine selbst gehostete Anwendung fest
Schätzen Sie den möglichen Verbindungsbedarf Ihrer Anwendung, vergleichen Sie ihn mit dem Datenbanklimit und überprüfen Sie Ihr Budget unter realistischen Workloads.
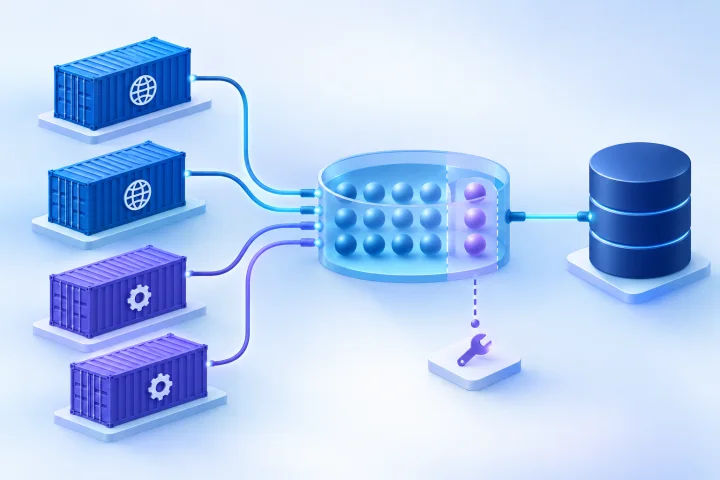
Warum Datenbankverbindungen ein Budget brauchen
Ein Verbindungsbudget schätzt, wie viele gleichzeitige Verbindungen eine Anwendung benötigen könnte. Zugleich berücksichtigt es Kapazität für Wartungsarbeiten und unerwarteten Bedarf. So vermeiden Sie, das Datenbanklimit als Zielgröße zu behandeln, die vollständig ausgeschöpft werden sollte.
Zusätzliche Anwendungscontainer können die mögliche Zahl der Verbindungen erhöhen, auch wenn Code und Traffic pro Container gleich bleiben. Die [Compose Deploy Specification von Docker](https://docs.docker.com/reference/compose-file/deploy/) definiert Replikate als die Anzahl der Container, die für einen replizierten Dienst ausgeführt werden sollen. Hat jedes Replikat eigene Verbindungspools, erhöht sich dadurch die mögliche Gesamtkapazität.
Die konfigurierte Poolkapazität entspricht nicht der tatsächlichen Nutzung: Ein Pool kann Verbindungen öffnen, ohne dass alle gleichzeitig Abfragen ausführen. Inaktive Verbindungen können geöffnet bleiben und trotzdem auf das Datenbanklimit angerechnet werden. Auch bei verwalteter Infrastruktur sollten Sie daher Poolverhalten und Datenbanklimit kennen.
- Betrachten Sie die Poolkapazität als Obergrenze, die die Anwendung erreichen kann, nicht als Vorhersage der üblichen Verbindungszahl.
- Die Zahl offener Verbindungen ist eine Momentaufnahme und sagt nicht aus, wie viele gerade Abfragen ausführen.
- Erstellen Sie für jede Datenbank ein eigenes Budget, wenn Komponenten mit mehreren Datenbanken verbunden sind.

Alle Verbindungsquellen erfassen
Listen Sie zunächst alle Prozesse und Tools auf, die eine Verbindung zur Datenbank herstellen können. Berücksichtigen Sie neben der Anwendung auch Hintergrundaufgaben und Betriebsprozesse, die eigene Verbindungspools oder direkte Verbindungen nutzen.
Notieren Sie für jede Quelle, wie viele Instanzen gleichzeitig laufen können, wie viele Prozesse oder Pools jede Instanz erstellt und welche Kapazität pro Pool konfiguriert ist. Prüfen Sie die Bereitstellungskonfiguration und die offizielle Dokumentation für Ihre Anwendungsversion, statt sich auf einen möglicherweise unzutreffenden Framework-Standardwert zu verlassen.
- Webanwendungscontainer einschließlich der höchsten vorgesehenen Replikatzahl.
- Worker-Container sowie die Zahl der Worker-Prozesse oder Pools in jedem Container.
- Scheduler, wiederkehrende Jobs und weitere Dienste mit direkter Datenbankverbindung.
- Migrationen, Bereitstellungsjobs, Monitoring, Reporting, Backup-Tools und administrative Sitzungen.
- Überschneidungen bei Releases oder Wiederherstellungen, wenn alte und neue Instanzen gleichzeitig laufen können.

Den möglichen Bedarf schätzen
Berechnen Sie für eine erste Schätzung die maximale Kapazität jeder Poolgruppe und addieren Sie die Gruppen, die dieselbe Datenbank nutzen. Eine hilfreiche Formel lautet: mögliche Poolkapazität = laufende Instanzen × Poolinstanzen pro Instanz × maximale Verbindungen pro Pool. Addieren Sie separate Worker und andere Dienste sowie direkte Verbindungen, die keinen dieser Pools nutzen.
Verwenden Sie die tatsächliche Zahl der Poolinstanzen und nicht nur die Zahl der Container. Eine Anwendung kann beispielsweise pro Prozess einen Pool erstellen. Mehrere Webprozesse in einem Container vervielfachen dann die Kapazität. Wenn ein Pool gemeinsam genutzt wird, orientieren Sie sich am dokumentierten Verhalten der Anwendung.
Beispielrechnung, keine Konfigurationsempfehlung: Drei Replikate mit jeweils vier Prozessen und einer maximalen Poolgröße von fünf pro Prozess ergeben eine mögliche Web-Pool-Kapazität von 60 Verbindungen. Zwei Worker-Replikate mit jeweils vier Verbindungen kommen auf weitere acht. Die Summe beträgt 68, noch ohne Migrationen, Monitoring oder administrative Zugriffe.
Diese Summe ist eine konfigurierte Obergrenze unter den genannten Annahmen, keine Vorhersage der üblichen Nutzung. Messen Sie zusätzlich die tatsächlichen Verbindungszahlen unter Last.
- Notieren Sie alle Eingaben und ihre Quellen: Replikate, Prozesse pro Instanz, Pools und Limits pro Pool.
- Verwenden Sie die höchste Instanzzahl, die bei normaler Skalierung oder einem Release erreicht werden kann.
- Addieren Sie keine Kapazitäten von Komponenten, die unterschiedliche Datenbankserver nutzen.
- Bei den dokumentierten SQLAlchemy-QueuePool-Fällen entspricht die maximale Zahl gleichzeitig genutzter Verbindungen pro Engine pool_size plus max_overflow. Prüfen Sie, ob dieser Pool und diese Einstellungen für Ihre Anwendung gelten. Siehe die [Dokumentation von SQLAlchemy zu Pool-Limits](https://docs.sqlalchemy.org/en/20/errors.html).
Die Schätzung mit dem Datenbanklimit vergleichen
Vergleichen Sie den möglichen Gesamtbedarf der Anwendung mit dem dokumentierten Limit für gleichzeitige Verbindungen. Planen Sie nicht, alle verfügbaren Plätze zu belegen. Reservieren Sie Kapazität für Wartung, Migrationen, Monitoring, administrative Fehlerdiagnosen und Bedarfsspitzen. Die passende Reserve hängt von Ihren betrieblichen Anforderungen und beobachteten Spitzen ab; einen allgemein sicheren Prozentsatz gibt es nicht.
Prüfen Sie, wie Ihre Datenbank nutzbare Verbindungsplätze definiert. Die [PostgreSQL-Dokumentation zu Verbindungen und Authentifizierung](https://www.postgresql.org/docs/17/runtime-config-connection.html) beschreibt max_connections als maximale Zahl gleichzeitiger Verbindungen. Eine Erhöhung führt auch zur Zuweisung zusätzlicher Ressourcen, darunter Shared Memory. PostgreSQL kann Plätze für entsprechend privilegierte Rollen reservieren, sodass nicht jeder Platz für gewöhnliche Anwendungsverbindungen verfügbar ist.
Die [Dokumentation von MySQL zu Verbindungen](https://dev.mysql.com/doc/refman/8.0/en/connection-interfaces.html) beschreibt max_connections als maximale Zahl gleichzeitig zugelassener Clients. Außerdem dokumentiert sie eine zusätzliche Verbindung für ein Konto mit CONNECTION_ADMIN oder dem veralteten SUPER-Recht zur Fehlerdiagnose. Betrachten Sie dies als administrative Möglichkeit und nicht als gewöhnliche Anwendungskapazität.
Nähert sich die Schätzung dem nutzbaren Limit oder überschreitet sie es, prüfen Sie zuerst Replikat- und Prozesszahlen, Poolgrößen und unnötige Verbindungsquellen. Das Datenbanklimit zu erhöhen, ist nicht automatisch die richtige Lösung: Dadurch können mehr Ressourcen benötigt werden, ohne dass ein überdimensionierter Pool oder ein Verbindungsleck behoben wird.
- Halten Sie das konfigurierte Datenbanklimit und relevante reservierte oder privilegierte Plätze fest.
- Berücksichtigen Sie die betriebliche Reserve, bevor Sie Kapazität für Anwendungspools festlegen.
- Prüfen Sie die Dokumentation des Anbieters für die tatsächlich eingesetzte Datenbank und Konfiguration.
- Bewerten Sie bei einer Limitänderung die Auswirkungen auf Datenbankressourcen und überprüfen Sie die neue Einstellung.
Das Pooling auf beiden Ebenen prüfen
Ein Anwendungspool und ein Datenbanklimit regeln unterschiedliche Dinge. Der Pool bestimmt, wie viele Verbindungen er erstellen kann und was passiert, wenn alle ausgelastet sind. Das Datenbanklimit bestimmt, wie viele Clients die Datenbank gleichzeitig akzeptiert. Erlaubt ein Pool mehr Verbindungen, als die Datenbank bedienen kann, kann sich das Problem von der Anwendung auf die Datenbank verlagern.
Bei den dokumentierten SQLAlchemy-QueuePool-Fällen warten zusätzliche Anfragen, wenn die konfigurierte Kapazität ausgeschöpft ist, und können eine Zeitüberschreitung verursachen. Die [SQLAlchemy-Dokumentation](https://docs.sqlalchemy.org/en/20/errors.html) warnt außerdem, dass unbegrenzter Overflow den Bedarf bis zum Datenbanklimit steigen lassen kann. Ein Pool-Timeout ist ein Anlass, Bedarf und Poolverhalten zu untersuchen, nicht automatisch den Pool zu vergrößern.
Wenn PgBouncer Teil der Architektur ist, unterscheiden Sie zwischen Client- und Serververbindungen. Die [Konfigurationsdokumentation](https://www.pgbouncer.org/config) beschreibt separate Client- und Serverlimits pro Datenbank. Ein Unterschied zwischen diesen Limits kann dazu führen, dass Clients auf aktive Serververbindungen warten. Auch der Poolmodus beeinflusst die Wiederverwendung: Im Sitzungsmodus wird eine Serververbindung nach dem Trennen des Clients freigegeben, im Transaktionsmodus nach Abschluss einer Transaktion. Prüfen Sie den konfigurierten Modus und die Kompatibilität Ihrer Anwendung anhand der Dokumentation.
Gehen Sie nicht davon aus, dass Pooling allein durch den Einsatz von Containern stattfindet. Ermitteln Sie, welche Komponente für jeden Pool zuständig ist, ob der Pool pro Prozess angelegt wird und ob ein Proxy zwischen Anwendung und Datenbank liegt.
- Prüfen Sie die offizielle Pool-Dokumentation der Anwendung oder des Frameworks für Ihre Bereitstellung.
- Klären Sie die Bedeutung von Poolgröße, Overflow, Leerlaufzeit und Timeout, sofern diese Einstellungen vorhanden sind.
- Budgetieren Sie bei einem Datenbankproxy Client- und Datenbankverbindungen getrennt.
- Prüfen Sie, wann eine Verbindung nach Abschluss einer Anfrage, eines Jobs oder einer Transaktion freigegeben wird.
Das Budget unter repräsentativer Last überprüfen
Die Berechnung ist ein Ausgangspunkt. Testen Sie die Anwendung mit einer repräsentativen Zahl gleichzeitiger Anfragen und Hintergrundjobs. Beobachten Sie die Verbindungszahlen zusammen mit Warteschlangen und Fehlern in der Anwendung. Vergleichen Sie die Spitzenwerte anschließend mit Ihrer Schätzung und der reservierten Kapazität.
Für PostgreSQL liefert [pg_stat_activity](https://www.postgresql.org/docs/16/monitoring-stats.html) eine Zeile pro Serverprozess und enthält Felder wie application_name, Benutzer, Clientadresse, Zustand und aktuelle Abfrage. Damit können Sie Verbindungsquellen und beobachtete Aktivitäten untersuchen. Nutzen Sie für andere Datenbanken geeignete Monitoring-Möglichkeiten. MySQL dokumentiert in seiner [Verbindungsdokumentation](https://dev.mysql.com/doc/refman/8.0/en/connection-interfaces.html) den Zähler Connection_errors_max_connections. Er wird erhöht, wenn eine Verbindung abgelehnt wird, weil max_connections erreicht ist.
Testen Sie neben dem üblichen Webpfad auch Bereitstellungen oder Migrationen, wenn sie sich mit Live-Traffic überschneiden können. Beziehen Sie Worker-Aktivität ein, sofern Worker dieselbe Datenbank nutzen. So erkennen Sie, ob der Bedarf in Ihr Budget passt und ob die Anwendung Anfragen in eine Warteschlange stellt oder fehlschlägt, bevor das Datenbanklimit erreicht ist.
- Erfassen Sie die Spitzenzahl offener Verbindungen sowie, sofern verfügbar, deren Zustand und Quelle.
- Achten Sie auf Wartezeiten in Anwendungspools, Pool-Timeouts, abgelehnte Verbindungen und datenbankseitige Limitzähler.
- Vergleichen Sie den Spitzenwert mit der berechneten Kapazität und der für den Betrieb reservierten Kapazität.
- Wiederholen Sie den Test nach Änderungen an Replikatzahl, Worker-Konkurrenz, Pooleinstellungen oder Datenbankkonfiguration.
Warnzeichen untersuchen, bevor Sie Limits erhöhen
Ein Pool-Timeout kann bedeuten, dass alle konfigurierten Verbindungen ausgelastet sind. Eine Ablehnung durch die Datenbank kann darauf hindeuten, dass das Serverlimit erreicht wurde. Keines der Symptome erklärt allein die Ursache. Prüfen Sie, ob der Bedarf gestiegen ist, Jobs länger dauern, Verbindungen länger gehalten werden oder eine Komponente mehr Pools geöffnet hat als angenommen.
Unterscheiden Sie inaktive Verbindungen von laufenden Abfragen. Laut [SQLAlchemy-Dokumentation](https://docs.sqlalchemy.org/en/20/errors.html) kann eine freigegebene Verbindung im Pool verbunden bleiben, damit sie wiederverwendet werden kann. Offene Verbindungen bedeuten daher nicht unbedingt, dass gerade eine Abfrage läuft. Nutzen Sie bei PostgreSQL die Felder von pg_stat_activity, um Herkunft und Aktivität nachzuvollziehen.
- Pool-Timeouts: Prüfen Sie Poolkapazität, anhaltenden Bedarf und die Dauer, für die Verbindungen gehalten werden.
- Abgelehnte Datenbankverbindungen: Überprüfen Sie das Serverlimit, reservierte Plätze und die verbindenden Anwendungen.
- Unerwartet viele offene Verbindungen: Untersuchen Sie inaktive Poolverbindungen, aktive Arbeit, doppelte Pools oder ein mögliches Leck.
- Plötzliche Änderungen nach einer Bereitstellung: Vergleichen Sie Replikat-, Prozess-, Worker- und Pooleinstellungen mit dem vorherigen Budget.
Budget und Überprüfungsanlässe dokumentieren
Halten Sie die Berechnung zusammen mit der Bereitstellungskonfiguration oder Betriebsdokumentation fest. Ein nachvollziehbares Budget zeigt, welche Prozesse und Einstellungen berücksichtigt wurden, wie viel Kapazität reserviert ist und wie die Schätzung überprüft wurde.
Überprüfen Sie das Budget bei Änderungen am System. Airbip führt Anwendungsinstanzen als Docker-Workloads auf Airbip-Cloudservern aus und bietet verwaltete Bereitstellung sowie Verwaltung des Service-Lebenszyklus. Diese Leistungen legen nicht das Poolverhalten der jeweiligen Anwendung fest und ersetzen nicht die Prüfung des Datenbankverbindungsbudgets. Auch bei verwalteter Infrastruktur sollten Teams ihre Entscheidungen zu Anwendungen und Datenzugriff verstehen.
- Dokumentieren Sie Datenbanklimit, reservierte Plätze, Anwendungspools und die Quelle jeder Einstellung.
- Listen Sie maximale Replikatzahl, Prozesse pro Instanz, Worker-Konkurrenz und weitere Verbindungsquellen auf.
- Halten Sie Berechnung, betriebliche Reserve, beobachteten Spitzenwert, Testbedingungen und Annahmen fest.
- Bestimmen Sie eine verantwortliche Person und überprüfen Sie das Budget nach Änderungen an Skalierung, Anwendung, Datenbank oder Wiederherstellungsplan sowie bei Wachstum der Workload.
- Berücksichtigen Sie Migrationen und administrative Zugriffe in Bereitstellungs- und Wiederherstellungsverfahren, damit sie nicht unerwartet mit der Anwendung um Kapazität konkurrieren.
Häufige Fragen
Entspricht die Poolgröße der Zahl der Datenbankverbindungen, die die Anwendung nutzt?
Nein. Die Poolgröße ist die konfigurierte Kapazität und entspricht nicht unbedingt der Zahl der geöffneten Verbindungen oder der gerade aktiven Abfragen. Ein Pool kann bei Bedarf wachsen; Verbindungen können zur Wiederverwendung im Leerlauf geöffnet bleiben. Messen Sie die beobachteten Verbindungen zusätzlich zur berechneten Obergrenze.
Wie schätze ich die Zahl der Verbindungen bei mehreren Anwendungscontainern?
Ermitteln Sie die Zahl der Pools in jedem Container und multiplizieren Sie deren maximale Kapazität mit der Zahl der gleichzeitig möglichen Instanzen. Gehört jedem Prozess ein eigener Pool, beziehen Sie auch die Prozesszahl ein. Addieren Sie Worker und andere direkte Verbindungsquellen, die dieselbe Datenbank nutzen.
Sollte ich das Datenbankverbindungslimit erhöhen, wenn die Verbindungen ausgeschöpft sind?
Nicht automatisch. Ermitteln Sie zuerst, welche Clients Verbindungen herstellen, ob Poolkapazitäten größer als vorgesehen sind, ob Verbindungen zu lange gehalten werden oder verloren gehen und ob sich die gleichzeitige Workload geändert hat. Eine Erhöhung von max_connections in PostgreSQL vergrößert auch die Zuweisung bestimmter Ressourcen, darunter Shared Memory. Prüfen Sie die [PostgreSQL-Dokumentation](https://www.postgresql.org/docs/17/runtime-config-connection.html) und validieren Sie die Auswirkungen.
Wofür sollte ich Datenbankverbindungen reservieren?
Halten Sie Kapazität für erforderliche Betriebsaufgaben frei, etwa Wartung, Migrationen, Monitoring, Administration und unerwarteten Bedarf. Die benötigte Menge hängt von Ihrem System und der beobachteten Workload ab; eine allgemein sichere Reserve gibt es nicht.
Kann ich die Einstellungen der Anwendungspools ignorieren, wenn ich PgBouncer verwende?
Nein. PgBouncer unterscheidet zwischen Limits für Client- und Serververbindungen. Der Poolmodus beeinflusst, wann Serververbindungen wiederverwendet werden können. Budgetieren Sie beide Seiten und prüfen Sie den konfigurierten Modus sowie das Verhalten der Anwendung anhand der [offiziellen PgBouncer-Dokumentation](https://www.pgbouncer.org/config).
Quellen und weiterführende Literatur
- PostgreSQL: Connections and Authentication — PostgreSQL Global Development Group
- PostgreSQL: The Cumulative Statistics System — PostgreSQL Global Development Group
- SQLAlchemy: Error Messages — Connection Pool Limits — SQLAlchemy
- PgBouncer Configuration — PgBouncer
- Compose Deploy Specification — Docker
- MySQL: Connection Interfaces — Oracle