Was passiert, wenn eine Abhängigkeit ausfällt? Ein Resilienztest für selbstgehostete Anwendungen
Eine praxisnahe Methode, um die Dienste zu erfassen, von denen Ihre selbstgehostete Anwendung abhängt, realistische Ausfälle sicher zu testen und vor einem Launch oder einer Migration sichere Fallbacks festzulegen.
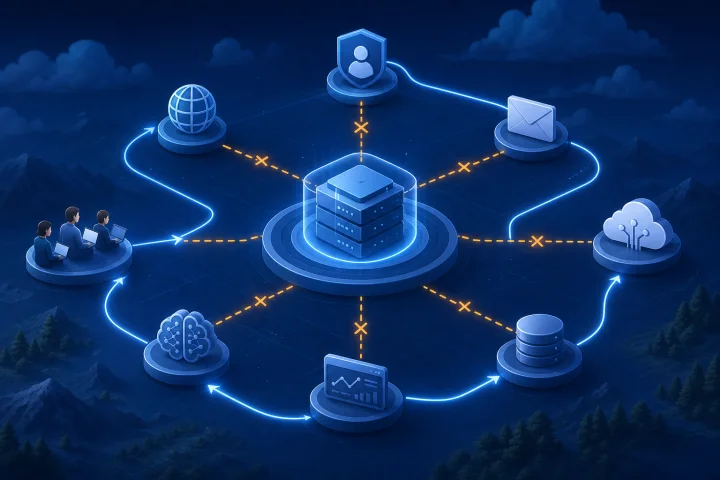
Eine Anwendung kann gesund sein, obwohl ihre Arbeit nicht möglich ist
Ein laufender Container, eine erfolgreiche Anfrage an die Login-Seite oder ein grüner Reverse-Proxy-Check beantwortet nur eine eng gefasste Frage: Reagiert diese Komponente unter der geprüften Bedingung? Es beweist nicht, dass Nutzer sich über den Identitätsanbieter der Organisation anmelden, eine Benachrichtigung versenden, eine Datei abrufen, eine Zahlung abschließen, eine angebundene API aufrufen oder eine Antwort von einem Modelldienst erhalten können.
Docker Compose kann Dienste in Abhängigkeitsreihenfolge starten, doch die Startreihenfolge allein bedeutet nicht, dass eine Abhängigkeit für die Arbeit der Anwendung bereit ist. Docker dokumentiert die Verwendung eines konfigurierten Health Checks und der Bedingung `service_healthy`, wenn ein abhängiger Dienst auf die Bereitschaft warten muss ([Docker-Dokumentation](https://docs.docker.com/compose/how-tos/startup-order/)). Auch dann müssen Health Checks präzise interpretiert werden: Der dokumentierte Endpunkt `/ping` von Traefik zeigt, dass der Traefik-Prozess aktiv ist, nicht dass jeder Upstream-Anwendungspfad nutzbar ist ([Traefik-Dokumentation](https://doc.traefik.io/traefik/reference/install-configuration/observability/healthcheck/)).
Betrachten Sie Resilienz als ergebnisorientierte Frage: Welche Nutzeraufgaben müssen weiterhin erfolgreich sein, welche dürfen verzögert werden und welche müssen sicher blockiert werden, wenn eine Abhängigkeit beeinträchtigt ist? Dadurch entsteht ein weitaus nützlicherer Plan als durch eine Liste von Integrationen.
- Liveness: Ein Prozess beantwortet eine einfache Anfrage.
- Readiness: Ein Dienst kann die konkrete Art von Arbeit annehmen, die er gleich erhalten soll.
- Geschäftlicher Abschluss: Das beabsichtigte Ergebnis ist einmalig, mit den korrekten Daten und gegebenenfalls mit dem erforderlichen Audit-Trail eingetreten.
- Wiederherstellung: Das Team kann den Normalbetrieb wiederherstellen, unklare Vorgänge abgleichen und die Auswirkungen erklären.

Ordnen Sie Abhängigkeiten nach ihrer Funktion zu
Beginnen Sie mit den Nutzerabläufen, nicht mit der Konfigurationsdatei. Verfolgen Sie für jeden wichtigen Ablauf – etwa Anmeldung, Anlegen eines Kundendatensatzes, Veröffentlichen von Inhalten, Versand einer Rechnung, Annahme einer Formularübermittlung oder Beantwortung einer KI-Anfrage – jeden Dienst von der Nutzeraktion bis zum bestätigten Ergebnis.
Beziehen Sie verwaltete, externe und von Menschen betriebene Abhängigkeiten ein. Ein Docker-Bereitstellungsdiagramm ist nützlich, aber unvollständig: DNS, ein Registrar oder Anbieter für benutzerdefinierte Domains, Identität, SMTP oder E-Mail-APIs, SaaS-APIs, Webhook-Absender, Modellendpunkte und Monitoring können sämtlich außerhalb des Anwendungs-Stacks liegen. Docker Compose unterstützt außerdem extern bereitgestellte Provider-Dienste, was unterstreicht, dass ein Workload von Ressourcen abhängen kann, deren Lebenszyklus an anderer Stelle liegt ([Docker-Compose-Referenz](https://docs.docker.com/reference/compose-file/services/)).
Nutzen Sie die folgenden Funktionsgruppen, damit Lücken früh sichtbar werden.
- Identität und Zugriff: Identitätsanbieter, Föderation, Multi-Faktor-Authentifizierung, Rollenverzeichnis, Administrator-Zugriffsweg.
- Netzwerk und Domain: DNS, Konfiguration benutzerdefinierter Domains, Reverse Proxy, Pfad zur TLS-Zertifikatsvalidierung und -erneuerung.
- Kommunikation: SMTP-Relay, transaktionale E-Mail-API, Verarbeitung eingehender E-Mails, Messaging- oder Benachrichtigungsdienste.
- Daten und Dateien: primäre Datenbank, Objekt- oder Dateispeicher, Backup-Ziel, Import- oder Export-Orte.
- Kommerzielle und angebundene Dienste: Zahlungsanbieter, CRM, Buchhaltung, Analytics, Karten, Suche, Partner-APIs und API-Zugangsdaten.
- Asynchrone Verarbeitung: Queues, Scheduler, Worker, Webhooks und Callback-Endpunkte.
- KI-Dienste: Modellendpunkt, Embedding-Dienst, Vektorspeicher, Dokumentenabruf-Pipeline und Modellzugangsdaten.
- Betrieb: Logs, Monitoring, Alarmzustellung, Incident-Kontakte, Secrets-Management und Administrationsdokumentation.

Klassifizieren Sie Abhängigkeiten nach den Folgen ihres Ausfalls
Weisen Sie nicht jeder Abhängigkeit dasselbe Resilienzziel zu. NIST-Leitlinien zur Lieferkette unterstützen unterschiedliche Anforderungen entsprechend der Kritikalität und unter Berücksichtigung der Auswirkung auf Auftrag oder Geschäft, der verarbeiteten Daten sowie des bereitgestellten Produkts oder Dienstes ([NIST SP 1305](https://nvlpubs.nist.gov/nistpubs/SpecialPublications/NIST.SP.1305.pdf)). Wenden Sie dieselbe Logik auf jede Abhängigkeit in Ihrer Anwendungsarchitektur an.
Eine einfache vierteilige Klassifizierung zwingt zu einer Entscheidung darüber, welcher eingeschränkte Betrieb akzeptabel ist. Ein Dienst kann für unterschiedliche Workflows in mehr als einer Kategorie erscheinen; E-Mail kann beispielsweise für das Anzeigen von Datensätzen optional sein, für die Passwortwiederherstellung oder eine rechtlich relevante Zustellung jedoch erforderlich.
- Für die Anmeldung erforderlich: Ohne sie können normale Nutzer keine Sitzung aufbauen. Definieren Sie separat einen sicheren Notfall-Zugriffsweg für Administratoren.
- Für die Arbeit erforderlich: Ohne sie kann eine Kerntransaktion nicht korrekt abgeschlossen werden. Beispiele sind der primäre Datenspeicher oder eine verpflichtende externe API.
- Für optionale Funktionen erforderlich: Nutzer können ihre Hauptarbeit fortsetzen, doch eine nicht essenzielle Aktion ist nicht verfügbar oder verzögert.
- Für die Wiederherstellung erforderlich: Der tägliche Betrieb kann vorübergehend weiterlaufen, doch Wiederherstellung, Zertifikatserneuerung, Incident-Benachrichtigung oder Datenwiederherstellung hängen davon ab.
- Legen Sie für jede Klassifizierung ein akzeptables Unterbrechungsfenster, einen maximal tolerierbaren Rückstau, den zulässigen Fallback und die Person fest, die diesen Fallback auslösen darf.
Fordern Sie Nachweise statt beruhigender Beschreibungen
Anbieterdokumentation und eine Testumgebung sollten operative Fragen beantworten, die Marketingseiten häufig nicht beantworten. Erfassen Sie für jede Antwort einen Link, ein Testergebnis, eine Konfigurationsreferenz oder einen Support-Kontakt. Wenn die Dokumentation keine Aussage trifft, kennzeichnen Sie das Verhalten als unbekannt, statt von einem Retry, einer Queue oder einem Backup auszugehen.
Prüfen Sie die exakte Grenze, die getestet wird. Traefik weist darauf hin, dass es bei aktivierten Health Checks und nicht verfügbaren Servern eines Dienstes HTTP 503 zurückgeben kann. Das ist ein nützlicher Nachweis zur Upstream-Verfügbarkeit an der Reverse-Proxy-Grenze, aber kein Nachweis dafür, dass eine Nutzertransaktion abgeschlossen wurde ([Traefik-FAQ](https://doc.traefik.io/traefik/getting-started/faq/)).
Die Zertifikatsautomatisierung verdient einen eigenen Abhängigkeitseintrag. Für die HTTP-01-Validierung von Let’s Encrypt muss die Zertifizierungsstelle eine Challenge-Datei vom Webserver abrufen können; für DNS-01 muss sie einen TXT-Record im DNS abfragen. Der relevante Pfad, die DNS-Kontrolle, der Berechtigungsumfang der Zugangsdaten und das Propagierungsverhalten sollten daher dokumentiert werden, bevor eine Erneuerung dringend wird ([Let’s-Encrypt-Dokumentation zu Challenges](https://letsencrypt.org/docs/challenge-types/)).
- Welche genaue Operation beweist, dass die Abhängigkeit nutzbar und nicht nur erreichbar ist?
- Welche Timeouts, Fehlercodes, Retry-Richtlinien, Retry-Limits und Backoff-Verhalten gelten?
- Kann eine Anfrage angenommen, aber erst später abgeschlossen werden, und wo lässt sich ihr endgültiger Status überprüfen?
- Können Ereignisse verspätet, mehrfach oder in falscher Reihenfolge eintreffen?
- Stellt die Anwendung bei einem Ausfall Arbeit in eine Queue? Wie hoch sind deren Limit und Transparenz, und wie erfolgt der Abgleich?
- Welche Zugangsdaten werden für die Wiederherstellung benötigt, wo sind sie gespeichert und wer darf sie nutzen?
- Welche DNS- oder Netzwerkänderungen können die Zertifikatserneuerung oder den Zugriff über eine benutzerdefinierte Domain verhindern?
- Gibt es eine Nicht-Produktionsumgebung oder eine Staging-Umgebung des Anbieters für eine sichere Validierung?
Führen Sie kontrollierte Ausfalltests durch, die Produktionsvorfällen ähneln
Ein Resilienztest sollte einen definierten Umfang, eine Sicherheitsbedingung, eine Rückrollmaßnahme und eine beobachtende Person haben. Beginnen Sie in einer repräsentativen Nicht-Produktionsumgebung. Führen Sie begrenzte Übungen in der Produktion erst durch, wenn Auswirkungen, Autorisierung, Monitoring und Rückabwicklung verstanden sind. Führen Sie kein Experiment durch, bei dem ein unkontrollierter Ausfall des Workloads zu erwarten ist.
Testen Sie einen tatsächlichen Geschäftsablauf, nicht nur einen Verbindungstest. Ist beispielsweise die E-Mail-Zustellung nicht verfügbar, testen Sie die Kontoeinladung, die Passwortzurücksetzung und die Aktion, die voraussetzt, dass der Empfänger die Nachricht erhält. Dokumentieren Sie getrennt, ob die Anwendung die Anfrage angenommen hat, ob der E-Mail-Anbieter sie angenommen hat und ob der beabsichtigte Empfänger die erforderliche Aktion abschließen kann. Ist ein Modellendpunkt nicht verfügbar, testen Sie, was der Nutzer sieht, ob Quelldokumente weiterhin geschützt bleiben und ob eine unvollständige Interaktion korrekt erfasst wird.
Nutzen Sie für die Zertifikatsfehlersuche oder Client-Entwicklung die Staging-Umgebung von Let’s Encrypt, statt wiederholt fehlgeschlagene Produktionsautorisierungen zu verursachen. Let’s Encrypt empfiehlt Staging, um Autorisierungsbedingungen zu diagnostizieren, ohne Produktionslimits zu verbrauchen ([Let’s-Encrypt-Dokumentation zu Ratenlimits](https://letsencrypt.org/docs/rate-limits/)).
- Nicht verfügbarer Identitätsanbieter: Testen Sie die Anmeldung normaler Nutzer, Sitzungserneuerung, Administratorzugriff und Abmeldung; verifizieren Sie den Notfallzugriff nur unter den dokumentierten Kontrollen.
- Fehlgeschlagene E-Mail-Zustellung: Lösen Sie Nachrichten aus, prüfen Sie Anwendungsstatus und Zustellnachweise, verifizieren Sie die Nutzeranzeige, stellen Sie dann die Zustellung wieder her und gleichen Sie verzögerte oder fehlgeschlagene Aktionen ab.
- Nicht erreichbare API: Unterbrechen Sie den Pfad oder verweigern Sie die Zugangsdaten in einer Testumgebung; prüfen Sie Timeouts, Fehlerdarstellung, gespeicherten Zustand und ob die Aktion sicher wiederholt werden kann.
- Verzögerter Webhook: Verzögern Sie die Zustellung und geben Sie ihn anschließend frei; testen Sie erneute Zustellung, doppelte Ereignisse und Ereignisse in falscher Reihenfolge, wenn die Anbieter- oder Anwendungsdokumentation diese Verhaltensweisen beschreibt.
- Ausgeschöpftes Ratenlimit: Simulieren Sie nach Möglichkeit Kontingentfehler; verifizieren Sie begrenzte Retries, Backoff und eine klare Abbruchbedingung.
- Nicht verfügbarer Modellendpunkt: Testen Sie einen Timeout und eine Fehlerantwort; bestimmen Sie, ob die Anwendung einen klar gekennzeichneten Nichtverfügbarkeitsstatus bietet, Arbeit aufschiebt oder den Workflow blockieren muss.
- Nicht verfügbarer Upstream: Machen Sie in einer Testumgebung alle Server hinter einem per Health Check überwachten Reverse-Proxy-Dienst nicht verfügbar; verifizieren Sie die erwartete Behandlung von 503, Alarmierung und Wiederherstellung.
Dokumentieren Sie die Ergebnisse, die bestimmen, ob ein Ausfall sicher ist
Ein Test ist unvollständig, wenn sein einziges Ergebnis „es wurde erneut versucht“ lautet. Ein Retry kann auf eine Operation folgen, deren Ergebnis unbekannt ist. Eine erfolgreiche Antwort einer Anwendung oder externen API kann zeigen, dass eine Verarbeitungsgrenze erreicht wurde; sie beweist für sich allein nicht jedes nachgelagerte Geschäftsergebnis. Definieren Sie die für jeden Workflow erforderlichen Abschlussnachweise.
Dokumentieren Sie, was Nutzer erleben und was Administratoren tun müssen, aber stellen Sie auch fest, ob die Daten korrekt sind. Klären Sie für jede verzögerte oder wiederholte Operation anhand der relevanten Anwendungs- und Anbieterdokumentation, ob doppelte Zustellung, Umordnung, teilweiser Abschluss oder unklare Ergebnisse möglich sind. Wo dies möglich ist, verwenden Sie ein gegen Duplikate sicheres Design und pflegen Sie einen Abgleichplan.
Wenn eine API Idempotenzunterstützung dokumentiert, verwenden Sie deren dokumentierten Mechanismus für wiederholbare Erstellungs- oder Aktualisierungsanfragen. Gehen Sie nicht davon aus, dass ein solcher Mechanismus bei einer API existiert, die ihn nicht dokumentiert.
- Nutzerauswirkung: genau betroffene Aufgabe, Fehlermeldung, sichtbarer Status und ob Nutzer andere Arbeit fortsetzen können.
- Datenintegritätsrisiko: Könnte die Aktion verloren gehen, dupliziert, teilweise gespeichert, in falscher Reihenfolge verarbeitet oder in einem unbekannten Zustand zurückgelassen werden?
- Retry-Verhalten: Auslöser, Timeout, Zeitplan, Backoff, maximale Versuche und endgültiger Fehlerstatus.
- Queue-Verhalten: Speicherort der Arbeit, Rückstaulimit, Duplikatbehandlung, Annahmen zur Reihenfolge, Ablauf und Wiedergabemethode.
- Beobachtbarkeit: Logs, Metriken, Alarme, Korrelations-IDs und die Nachweise, anhand derer entschieden wird, dass die Verarbeitung abgeschlossen ist.
- Administratoraktionen: sofortige Eindämmung, Verifikationsschritte, Abgleichverfahren, Eskalationskontakt und die Regel zur Erklärung der vollständigen Wiederherstellung.
Entwerfen Sie praktische und sichere Fallbacks
Ein guter Fallback bewahrt die Sicherheit und macht die Grenzen ausdrücklich. Er ist nicht einfach ein Weg, das System mit Gewalt weiterlaufen zu lassen. Definieren Sie, was fortgesetzt werden kann, was pausieren muss, wer einen manuellen Prozess genehmigen darf, wo der Vorgang erfasst wird und wie aufgeschobene Arbeit anschließend abgeglichen wird.
Notfallzugriff für Administratoren ist ein zentrales Beispiel. Microsoft empfiehlt für Ausfallszenarien föderierter Identitätsanbieter vorbereitete Notfallkonten, die als reine Cloud-Konten nicht von Föderation oder lokaler Synchronisierung abhängen. Dieselben Leitlinien betonen eine starke Authentifizierung, die sich von normalen Administratorkonten unterscheidet, sichere Speicherung der Zugangsdaten, Protokollierung und Monitoring sowie regelmäßige Validierungsübungen ([Microsoft-Leitlinien für Notfallzugriff](https://learn.microsoft.com/en-us/entra/identity/role-based-access-control/security-emergency-access)).
Bei kundenbezogener Arbeit kann ein manueller Ablauf sicherer sein als automatisierte Retries, wenn die Operation finanzielle, rechtliche oder Folgen durch doppelte Datensätze verursachen kann. Eine Option für aufgeschobene Arbeit ist nur geeignet, wenn Queue, endgültiger Status und Abgleichprozess verstanden sind.
- Lokaler Notfallzugriff: streng kontrollierter, separat authentifizierter Administratorzugriff bei einem Identitätsausfall; nur gemäß einem dokumentierten und getesteten Verfahren verwenden.
- Manueller Prozess: eine zeitlich begrenzte Alternative, etwa das Erfassen von Anfragen in einem genehmigten System zur späteren Eingabe, mit verantwortlicher Person und Abgleichprüfung.
- Aufgeschobene Arbeit: geeignete Arbeit in die Queue stellen, bis eine Abhängigkeit zurückkehrt, und dabei Rückstau, Ablauf, doppelte Verarbeitung und Nutzerstatus verfolgen.
- Funktionsisolation: Nur die betroffene optionale Funktion deaktivieren und sichere Kern-Workflows erhalten.
- Klare Kommunikation: Angeben, was nicht verfügbar ist, was Nutzer stattdessen tun sollen, ob Arbeit gespeichert wurde und wann das nächste Update bereitgestellt wird.
Vermeiden Sie Behelfslösungen, die aus einem Ausfall einen Sicherheits- oder Datenvorfall machen
Machen Sie „Authentifizierung deaktivieren“ niemals zur Standardreaktion auf einen Identitätsausfall. Damit wird die Kontrolle genau dann entfernt, wenn Administratoren weniger Transparenz und mehr Druck haben. Bereiten Sie stattdessen einen begrenzten Notfallzugriff mit separaten Zugangsdaten, eingeschränkter Nutzung, Monitoring und geplanten Tests vor.
Behandeln Sie Retries ebenso wenig als Beweis dafür, dass nichts verloren ging oder dupliziert wurde. Ratenlimits können wiederholte Fehler verschlimmern. Let’s Encrypt begrenzt fehlgeschlagene Autorisierungen und empfiehlt Staging bei der Fehlersuche ([Let’s-Encrypt-Dokumentation zu Ratenlimits](https://letsencrypt.org/docs/rate-limits/)). Konfigurieren Sie begrenzte Retries und eine Abbruchbedingung; untersuchen oder gleichen Sie anschließend Arbeit ab, deren Ergebnis unklar bleibt.
Vermeiden Sie unbeschränkte DNS-Zugangsdaten aus Gründen der Bequemlichkeit bei der Zertifikatsautomatisierung. Let’s Encrypt warnt, dass breit gefasste DNS-API-Zugangsdaten auf einem Webserver die Auswirkungen einer Kompromittierung erhöhen, und schlägt vor, nach Möglichkeit eng begrenzte Zugangsdaten oder eine Validierung über einen separaten Server zu verwenden ([Let’s-Encrypt-Dokumentation zu Challenges](https://letsencrypt.org/docs/challenge-types/)).
- Umgehen Sie Zugriffskontrollen nicht ohne ein vorab autorisiertes und protokolliertes Notfallverfahren.
- Spielen Sie Transaktionen mit unbekanntem Ergebnis nicht erneut ab, bevor Sie feststellen können, ob die ursprüngliche Transaktion abgeschlossen wurde.
- Gehen Sie nicht von einmaliger oder geordneter Webhook-Zustellung aus, ohne das dokumentierte Verhalten zu bestätigen.
- Erlauben Sie keiner unbegrenzten Retry-Schleife, Last, Kosten oder eine Sperrung durch den Anbieter zu verursachen.
- Vergeben Sie keine weitreichenden DNS-Berechtigungen nur zur Automatisierung einer einzelnen Validierungsaufgabe.
- Schließen Sie einen Incident nicht allein aufgrund eines aktiven Prozesses; verifizieren Sie das betroffene Geschäftsergebnis und gleichen Sie den Rückstau ab.
Häufige Fragen
Was ist die Ausfallplanung von Abhängigkeiten für selbstgehostete Anwendungen?
Dabei werden alle Dienste identifiziert, von denen eine Anwendung abhängt, die geschäftlichen Auswirkungen des Ausfalls jedes Dienstes klassifiziert, realistische Ausfallmodi getestet und sichere Fallback- sowie Wiederherstellungsmaßnahmen dokumentiert, bevor ein Vorfall eintritt.
Sollte jede Abhängigkeit dasselbe Wiederherstellungsziel haben?
Nein. Legen Sie Anforderungen nach Kritikalität fest: geschäftliche Auswirkungen, verarbeitete Daten und bereitgestellter Dienst. Eine Abhängigkeit für Anmeldung oder Kerntransaktionen benötigt in der Regel einen anderen Plan als eine, die nur für eine optionale Funktion verwendet wird.
Warum reicht ein erfolgreicher Health Check nicht aus?
Ein Health Check belegt üblicherweise nur eine definierte, eng begrenzte Bedingung, etwa die Aktivität eines Prozesses oder die Verfügbarkeit eines Upstreams. Er belegt möglicherweise nicht, dass Nutzer eine Anmeldung abschließen, eine E-Mail versenden, eine Zahlung verarbeiten, eine Datei abrufen oder eine KI-Antwort erhalten können.
Wie sollten wir die Webhook-Resilienz testen?
Testen Sie fehlgeschlagene Zustellung, verzögerte Zustellung, erneute Zustellung, Duplikate und Ereignisse in falscher Reihenfolge, wenn diese Verhaltensweisen für den Anbieter oder die Anwendung relevant sind. Verifizieren Sie, dass die Verarbeitung bei Bedarf gegen Duplikate sicher ist und das Team Ereignisse nach der Wiederherstellung abgleichen kann.
Wie sollte ein Fallback bei einem Ausfall des Identitätsanbieters aussehen?
Nutzen Sie einen geplanten, streng geschützten Notfall-Zugriffsweg für Administratoren, der nicht vom ausgefallenen Föderierungspfad abhängt. Sichern Sie die Zugangsdaten, nutzen Sie eine separate starke Authentifizierung, protokollieren Sie die Nutzung, überwachen Sie Aktivitäten und validieren Sie das Verfahren regelmäßig. Deaktivieren Sie Zugriffskontrollen nicht großflächig.
Wo hilft Managed Hosting, und was bleibt beim Eigentümer der Anwendung?
Für unterstützte Anwendungen verwaltet Airbip die Cloud-Infrastruktur rund um selbstgehostete Anwendungsinstanzen, einschließlich Docker-Workloads auf Airbip-Cloud-Servern, Routing und TLS-Zertifikatsautomatisierung über Traefik und Let’s Encrypt, DNS-Prüfungen, Service-Lifecycle-Management sowie konfigurierbaren täglichen, wöchentlichen und monatlichen Backups. Das kann die Infrastrukturabhängigkeiten reduzieren, die ein Team direkt betreibt. Der Eigentümer der Anwendung muss weiterhin Entscheidungen zu Anwendungsintegrationen, Identität und Zugriff, Datenverarbeitung, Geschäftsprozessen, externen Anbietern und Kontinuitätsverfahren treffen und testen.
Quellen und weiterführende Literatur
- Control startup and shutdown order in Compose — Docker
- Define services in Docker Compose — Docker
- Traefik Health Check Documentation — Traefik Labs
- Traefik Getting Started FAQ — Traefik Labs
- Challenge Types — Let's Encrypt / Internet Security Research Group
- Rate Limits — Let's Encrypt / Internet Security Research Group
- The NIST Cybersecurity Framework (CSF) 2.0 — NIST
- NIST CSF 2.0: Quick-Start Guide for Cybersecurity Supply Chain Risk Management — NIST
- OWASP Application Security Verification Standard — OWASP Foundation
- Manage emergency access admin accounts — Microsoft